前言
GCD的队列是GCD源码分析系列中的重点
队列的定义
dispatch_queue_s是一个结构体,定义如下:
1 | struct dispatch_queue_s { |
可以看到结构体里面包含两个宏和一个dq_label
DISPATCH_STRUCT_HEADER
1 |
|
在GCD中,很多结构体的定义基本上都会调用DISPATCH_STRUCT_HEADER,并把结构体的名字作为第一个宏参数x传递进去,而第二个宏参数y通常是dispatch_queue_vtable_s。
struct x *volatile do_next,x参数仅仅会影响do_next的指针类型,可以理解为将来要进行链表操作。很显然,在队列的定义中,这行展开为:
1 | struct dispatch_queue_s *volatile do_next; |
而第二个参数y也只是会影响到do_vtable指针的类型,这里展开为:
1 | const struct dispatch_queue_vtable_s *do_vtable; |
dispatch_queue_vtable_s这个结构体内包含了这个dispatch_object_s
或者其子类的操作函数,而且针对这些操作函数,定义了相对简短的宏,方便调用
1 | unsigned long const do_type; \ // 数据的具体类型 |
DISPATCH_QUEUE_HEADER
1 |
dq_label
dq_label代表队列的名字,且最长的长度不能超过DISPATCH_QUEUE_MIN_LABEL_SIZE = 64
队列的获取
GCD队列的获取通常有以下几种方式:
1、主队列:dispatch_get_main_queue
1 |
可以看到dispatch_get_main_queue实际上是一个宏,它返回的是结构体_dispatch_main_q的地址
1 | struct dispatch_queue_s _dispatch_main_q = { |
do_vtable
看看主队列的函数指针do_vtable的指向:_dispatch_queue_vtable
1 | static const struct dispatch_queue_vtable_s _dispatch_queue_vtable = { |
do_ref_cnt && do_xref_cnt
这两个值和GCD对象的内存管理有关,只有两个值同时为0,GCD对象才能被释放,主队列的这两个成员的值都为DISPATCH_OBJECT_GLOBAL_REFCNT:
1 |
|
从_dispatch_retain和dispatch_release函数中可以看出,主队列的生命周期是伴随着应用的,不会受retain和release的影响
do_targetq
目标队列,通常非全局队列(例如mgr_queue),需要压入到glablalQueue中来处理,因此需要指明target_queue
1 |
1 | .do_targetq = &_dispatch_root_queues[DISPATCH_ROOT_QUEUE_COUNT / 2], |
即为“com.apple.root.default-overcommit-priority“这个全局队列
管理队列:_dispatch_mgr_q
注:这个队列是GCD内部使用的,不对外公开
1 | struct dispatch_queue_s _dispatch_mgr_q = { |
do_vtable
看看管理队列的函数指针do_vtable的指向:_dispatch_queue_mgr_vtable
1 | static const struct dispatch_queue_vtable_s _dispatch_queue_mgr_vtable = { |
do_ref_cnt && do_xref_cnt
可以参考主队列
do_targetq
即为“com.apple.root.high-overcommit-priority“这个全局队列
全局队列:dispatch_get_global_queue
1 | enum { |
我们当前分析的libdispatch定义了6个全局队列(最新的版本有8个全局队列)
1 | static struct dispatch_queue_s _dispatch_root_queues[] = { |
do_vtable
看看全局队列的函数指针do_vtable的指向:_dispatch_queue_root_vtable
1 | static const struct dispatch_queue_vtable_s _dispatch_queue_root_vtable = { |
do_ref_cnt && do_xref_cnt
可以参考主队类
do_ctxt
注意全局队列有一个do_ctxt,它是上下文,是我们要传递的参数
1 |
|
其中的_dispatch_thread_mediator定义如下:
1 | static struct dispatch_semaphore_s _dispatch_thread_mediator[] = { |
自定义队列
1 | dispatch_queue_t dispatch_queue_create(const char *label, dispatch_queue_attr_t attr) |
_dispatch_queue_init
来看下内联函数_dispatch_queue_init的实现
1 | inline void _dispatch_queue_init(dispatch_queue_t dq) |
通过前面的代码可以发现,全局队列的并发数dq_width均为UINT32_MAX,而这里_dispatch_queue_init中的dq_width为1,说明这是一个串行队列的默认设置。
另外dq->do_targetq = _dispatch_get_root_queue(0, true),它涉及到GCD队列与block
的一个重要模型,target_queue。向任何队列中提交的
block,都会被放到它的目标队列中执行,而普通串行队列的目标队列就是一个支持
overcommit 的全局队列,全局队列的底层则是一个线程池。
引用苹果的一张经典图
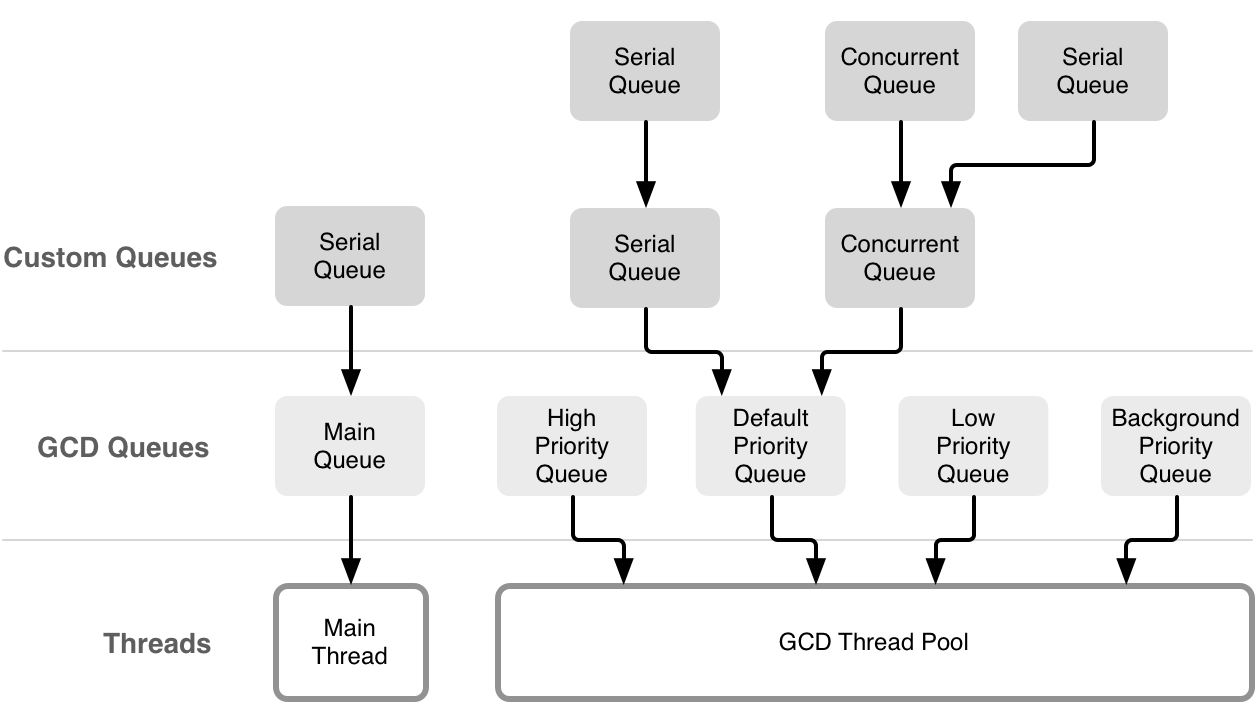
其他的属性基本上可以参考前面的信息,这里着重理解下dq_serialnum:
1 | static unsigned long _dispatch_queue_serial_numbers = 10; |
1 | // skip zero |
可以看到,0被跳过,3未使用,1用于主队列,2用于管理队列,4~9用于全局队列。自定义队列从10开始,每次自定义一个队列时,都会先原子操作_dispatch_queue_serial_numbers变量,然后减1,这样保证了每个自定义队列的dq_serialnum的唯一性。
dispatch_queue_attr_t特殊处理
如果在自定义队列时,传递了attr参数,那么表示支持overcommit,带有overcommit
的队列表示每当有任务提交时,系统都会新开一个线程处理,这样就不会造成某个线程过载。
同时如果finalizer_func == _dispatch_call_block_and_release2需要对dq_finalizer_ctxt进行retain
1 | void _dispatch_call_block_and_release2(void *block, void *ctxt) |
常用API解析
dispatch_async
1 | void dispatch_async(dispatch_queue_t dq, void (^work)(void)) |
dispatch_async主要将参数进行了处理,然后去调用dispatch_async_f`
- 1、
_dispatch_Block_copy在堆上创建传入block的拷贝,或者增加引用计数,这样就保证了block在执行之前不会被销毁- 2
_dispatch_call_block_and_release的定义如下,顾名思义,调用block,然后将block销毁
1 | void _dispatch_call_block_and_release(void *block) |
dispatch_async_f
接下来分析一下dispatch_async_f的实现
1 | void dispatch_async_f(dispatch_queue_t dq, void *ctxt, dispatch_function_t func) |
- 1、我们首先来看下
_dispatch_continuation_alloc_cacheonly,它的目的就是从线程的TLS(线程的私有存储,线程都是有自己的私有存储的,这些私有存储不会被其他线程所使用)中提取出一个dispatch_continuation_t结构
1 | static inline dispatch_continuation_t _dispatch_continuation_alloc_cacheonly(void) |
- 2、如果线程中的TLS不存在
dispatch_continuation_t结构的数据,则走_dispatch_async_f_slow() 函数。- 3、如果dc不为空,设置其do_vtable为DISPATCH_OBJ_ASYNC_BIT(主要用于区分类型),把传入的block传给dc的dc_ctxt作为上下文,最后将dc的dc_func设置为_dispatch_call_block_and_release,最后调用_dispatch_queue_push进行入队操作
DISPATCH_OBJ_ASYNC_BIT是一个宏定义,是为了区分async、group和barrier。
1 |
继续往下分析_dispatch_async_f_slow
1 | DISPATCH_NOINLINE static void _dispatch_async_f_slow(dispatch_queue_t dq, void *context, dispatch_function_t func) |
1 | dispatch_continuation_t _dispatch_continuation_alloc_from_heap(void) |
从堆上获取dispatch_continuation_t之后,设置dc的成员,跟前面一致。之后同样走到了_dispatch_queue_push函数
_dispatch_queue_push
继续往下分析_dispatch_queue_push
1 |
_dispatch_queue_push是一个宏,实际上是调用了_dispatch_queue_push_list
_dispatch_queue_push_list
1 | static inline void |
_dispatch_queue_push_list 函数是
inline函数,说明这个函数会调用很频繁,inline
通常用在内核中,效率很高,但生成的二进制文件会变大,典型的空间换时间。
- 1、 如果队列不为空,那么直接将该dc放到队尾,并重定向dq->dq_items_tail,因为队列前面还有任务,所以此时把dc插入到队尾就OK了 这里解释一下为什么会重定向:
- 根据
dispatch_atomic_xchg的定义“将p设为n并返回p操作之前的值”,dispatch_atomic_xchg(&dq->dq_items_tail, tail)这行代码的含义等同于:dq->dq_items_tail = tail,重定向了队尾指针- prev是原先的队尾元素,prev->do_next = head则把tail结点放到了队尾。
- 2、如果队列为空,则调用
_dispatch_queue_push_list_slow:
1 | void _dispatch_queue_push_list_slow(dispatch_queue_t dq, struct dispatch_object_s *obj) |
_dispatch_queue_push_list_slow直接将dq->dq_items_head设置为dc,然后调用_dispatch_wakeup唤醒这个队列。这里直接执行_dispatch_wakeup的原因是此时队列为空,没有任务在执行,处于休眠状态,所以需要唤醒。
_dispatch_wakeup
接下来分析一下如何唤醒一个队列:这里的dou指队列
1 | dispatch_queue_t _dispatch_wakeup(dispatch_object_t dou) |
- 1、如果是主队列,则直接调用_dispatch_queue_wakeup_main
1 | void _dispatch_queue_wakeup_main(void) |
- 2、如果是全局队列,会进入到全局队列的dx_probe指向的函数
_dispatch_queue_wakeup_global中: 在这里面我们就真正的接触到pthread了
1 | bool _dispatch_queue_wakeup_global(dispatch_queue_t dq) |
- 1、如果队列上下文中的
dgq_kworkqueue存在,则调用pthread_workqueue_additem_np函数,该函数使用workq_kernreturn系统调用,通知workqueue增加应当执行的项目。根据该通知,XNU内核基于系统状态判断是否要生成线程,如果是overcommit优先级的队列,workqueue则始终生成线程,之后线程执行_dispatch_worker_thread2函数。
- 2、反之,如果
dgq_kworkqueue不存在,则调用pthread_create函数直接启动一个线程,执行_dispatch_worker_thread函数,但是这个函数中仍然调用到了_dispatch_worker_thread2,和第1条殊途同归。
_dispatch_worker_thread
1 | void *_dispatch_worker_thread(void *context) |
函数前面主要是设置新线程的信号掩码,真正的任务调度在_dispatch_worker_thread2里面,而我们也可以看到,这个任务调度结束后,这个线程在等待一个信号量,而等待的信号量就是前面dispatch_queue_wakeup_global里面的信号量,为什么要这样做?这样做的原因是不要频繁开启新线程,如果有一个新线程完成所有任务了,这个线程就要结束了,但这里并不是这样,而是等待一个信号量,大约等待65秒,如果65秒内接收到新的信号量(表示有新的任务),这个线程就会去继续执行加进来的任务,而不是重新开启新线程,65秒后没接收到信号量,则退出这个线程,销毁这个线程
_dispatch_worker_thread2
前面提到的两种方式实际上最终都调用到了_dispatch_worker_thread2函数,可见核心的执行逻辑都在这里,需要格外关注:
1 | void _dispatch_worker_thread2(void *context) |
这个函数里面进行任务的调度,两个函数很重要,
- 1、一个是
_dispatch_queue_concurrent_drain_one,用来取出队列的一个内容;- 2、另一个是
_dispatch_continuation_pop函数,用来对取出的内容进行处理;
_dispatch_queue_concurrent_drain_one
先来分析下_dispatch_queue_concurrent_drain_one
1 | struct dispatch_object_s * |
_dispatch_continuation_pop
接下来分析一下_dispatch_continuation_pop
1 | static inline void _dispatch_continuation_pop(dispatch_object_t dou) |
从上面的函数中可以发现,压入队列的不仅是续体任务,还有可能是队列。如果是队列,直接执行了_dispatch_queue_invoke,否则执行dc->dc_func(dc->dc_ctxt)
接下来分析一下_dispatch_queue_invoke的执行过程,即pop出来的队列是如何被执行的
1 | DISPATCH_NOINLINE void _dispatch_queue_invoke(dispatch_queue_t dq) |
如果是直接触发,即直接调用dx_invoke,那么会返回NULL
流程整理
dispatch_async 的实现比较复杂,主要是因为其中的数据结构较多,分支流程控制比较复杂。但思路其实很简单,用链表保存所有提交的 block,然后在底层线程池中,依次取出 block 并执行,具体的函数调用流程如下图:
1 | dispatch_async |
dispatch_sync
说完了dispatch_async,再来看下dispatch_sync。
1 | void dispatch_sync(dispatch_queue_t dq, void (^work)(void)) |
- 1、 如果是主队列,则调用_dispatch_sync_slow,可以看到,这个方法最终还是调用了
dispatch_sync_f。
1 | static void _dispatch_sync_slow(dispatch_queue_t dq, void (^work)(void)) |
- 2、否则,调用dispatch_sync_f:
1 | void dispatch_sync_f(dispatch_queue_t dq, void *ctxt, dispatch_function_t func) |
- 3、如果是向一个串行队列压入同步任务,则调用dispatch_barrier_sync_f:
1 | void dispatch_barrier_sync_f(dispatch_queue_t dq, void *ctxt, dispatch_function_t func) |
- 4、如果向一个并发队列中压入同步任务,如果队列不为空,或者挂起,或者有正在执行的任务,则调用
_dispatch_sync_f_slow,进行信号等待,否则直接调用_dispatch_wakeup唤醒队列执行任务
1 | static void _dispatch_sync_f_slow(dispatch_queue_t dq) |
流程整理
dispatch_sync同步方法的实现相对来说更简单,只需要将任务压入响应的队列,并用信号量做等待,具体调用栈如下:
1 | dispatch_sync |
总结
队列的内容比较多,而且比较复杂,由于本人能力有限,难免有些地方理解不够到位,写的不够清晰,请多多指教。

