前言
词法分析是编译程序进行编译时第一个要进行的任务,主要是对源程序进行编译预处理(去除注释、无用的回车换行找到包含的文件等)之后,对整个源程序进行分解,分解成一个个单词,这些单词有且只有五类,分别是 标识符、关键字、常数、运算符、界符。以便为下面的语法分析和语义分析做准备。可以说词法分析面向的对象是单个的字符,目的是把它们组成有效的单词(字符串),那么该阶段的主要任务就是构造一个词法分析器。有以下两种方法:
- 手工写,就是对于一种特定的语言,例如
JavaScript,我们手工敲代码根据该语言规则来模拟出这个转化过程,这种方法虽然复杂,并且容易出错,但这样对词法分析各个部分都有比较精确的控制,并且效率可能会比较高。- 自动生成一个词法分析器,过程就是:声明式的规范–>自动生成–>词法分析器,这里自动生成是一个工具,那么它所接受的输入是声明式的规范,输出是一个词法分析,我们先来看下输入声明式规范,声明式规范的意思是我们只需写出识别字符流的规则是什么,不需要指出怎么识别,然后放进自动生成器就行了,那么这个声明式的规范是什么?它就是我们所学的正则表达式,我们所学的C语言的关键字,标识符,整数都是正则表达式,也就是说我们将这些正则表达式放进自动生成器,那么就会生成词法分析器,这个词法分析器就是DFA,确定状态有限自动机。那么很明显这个自动生成器整个过程实际上是正则表达式转化为非确定的有限状态自动机(NFA),最后非确定的有限状态自动机转化为确定状态有限自动机,然后通过DFA的最小化,就生成了最后的DFA,也就是我们的输出词法分析器。如果输入的代码可以被有限自动机所接受,那么将会进入语法分析的阶段
词法分析及语法分析,最著名的工具就是lex/yacc,以及后继者flex/bison(The LEX & YACC Page)。它们为很多软件提供了语言或文本解析的功能,相当强大,也很有趣。
虽然JavaScriptCore并没有使用它们,而是自行编写实现的,但基本思路是相似的。
数据类型
按照惯例,还是从一些用到的基本数据类型说起.
CharacterType类型
JavaScript语言中有如下的字符类型,是针对每一个字符而言的
1 | // JavaScriptCore/parser/Lexer.cpp |
JSTokenType类型
JavaScript中的JSTokenType类型如下,可以看到JavaScript的每个关键字,算术运算符、逻辑运算符都被列为一种JSToken类型(由于JSTokenType较多,有一些尚未列出…)
1 | // JavaScriptCore/parser/ParseTokens.h |
在如下文件中可以看到上述枚举和关键词的映射关系(同样,由于篇幅关系,有些尚未列出)
1 | // JavaScriptCore/parser/Keywords.table |
Token类型
同时在源码中还可以看到一个枚举TokenType类型,这个类型是专门针对json的解析定义的,不要和前面的JSTokenType混淆(本来不应该在这里讲的,但是为了避免看源码混淆,还是提一下)
1 | // JavaScriptCore/runtime/LiteralParser.h |
JSToken类型
这个类型就比较重要了,将JavaScript源码通过词法分析过程之后,我们得到的就是一个个的JSToken了。可以看到它是一个复合类型
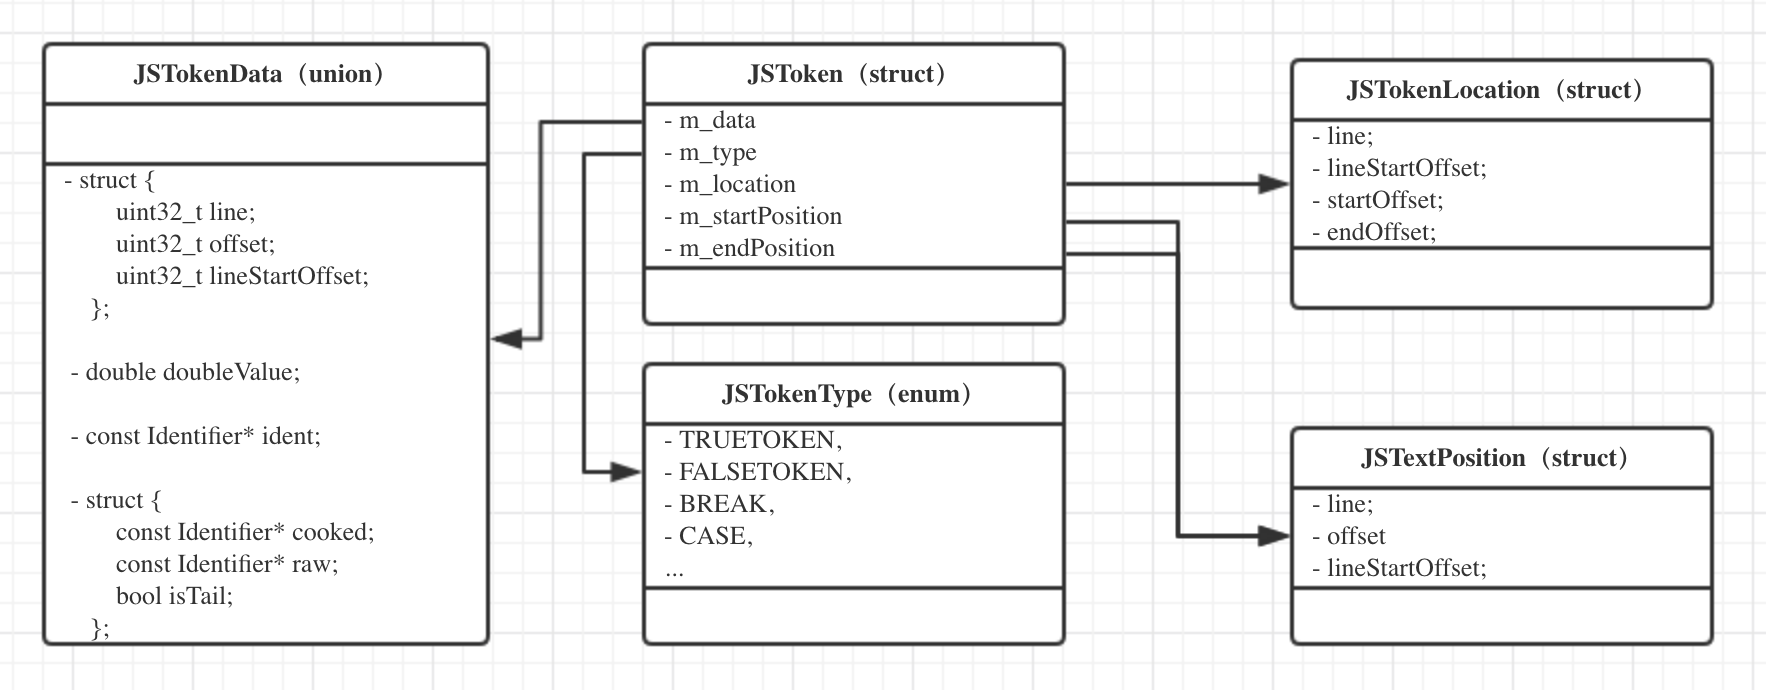
1 | struct JSToken { |
JSTokenData是一个联合体,可以存放以下4种成员,每个Token的数据的表示方式可能是不同的,例如
- 1、解析出来的数字字面值就可以用doubleValue来表示;
- 2、如果是字符串,可能就需要用第一个结构体来表示;
- 3、如果是方法名字或者变量名,需要Identifier来胜任;
1 | union JSTokenData { |
JSTokenLocation结构体包括行号、行起始位置、源文件起始位置、源文件结束位置
1 | struct JSTokenLocation { |
JSTextPosition作为一个位置,有行号、源文件偏移、行偏移
1 | struct JSTextPosition { |
词法分析过程
Lexer初始化
项目工程中,词法分析类Lexer类是辅助Parser类的,在Parser类中有一个成员变量m_lexer,在构造函数中对m_lexer进行了初始化:
1 | // 定义 |
标识符解析
然后在函数Parser类的方法nextExpectIdentifier中进行了调用,顾名思义,返回下一个期望的标识符
1 | ALWAYS_INLINE void nextExpectIdentifier(unsigned lexerFlags = 0) |
逻辑在lexExpectIdentifier方法中(删除了其中的一些Alert,便于代码清晰)
1 | template <typename T> |
该方法存在的意义在于为标识符开了一条快速通道:因为源码中存在着大量的标识符,相对来说,关键字、常数、运算符、界符的数量就少一些,从概率角度来说,源码中每解析一个JSToken,结果是标识符的概率是比较大的,这样就可以节省时间,正如方法名所示,下一个期望的标识符。
核心逻辑
除了标识符的解析外,剩下的词法分析核心逻辑在lex方法中,具体逻辑请看代码以及注释(代码较长)
1 | template <typename T> |
代码篇幅有些长,但是这是本篇最重要的一个函数,所以未作任何篇幅省略或缩减。 不过换一种方式看下,就会觉得比较清晰了,不妨结合来看。
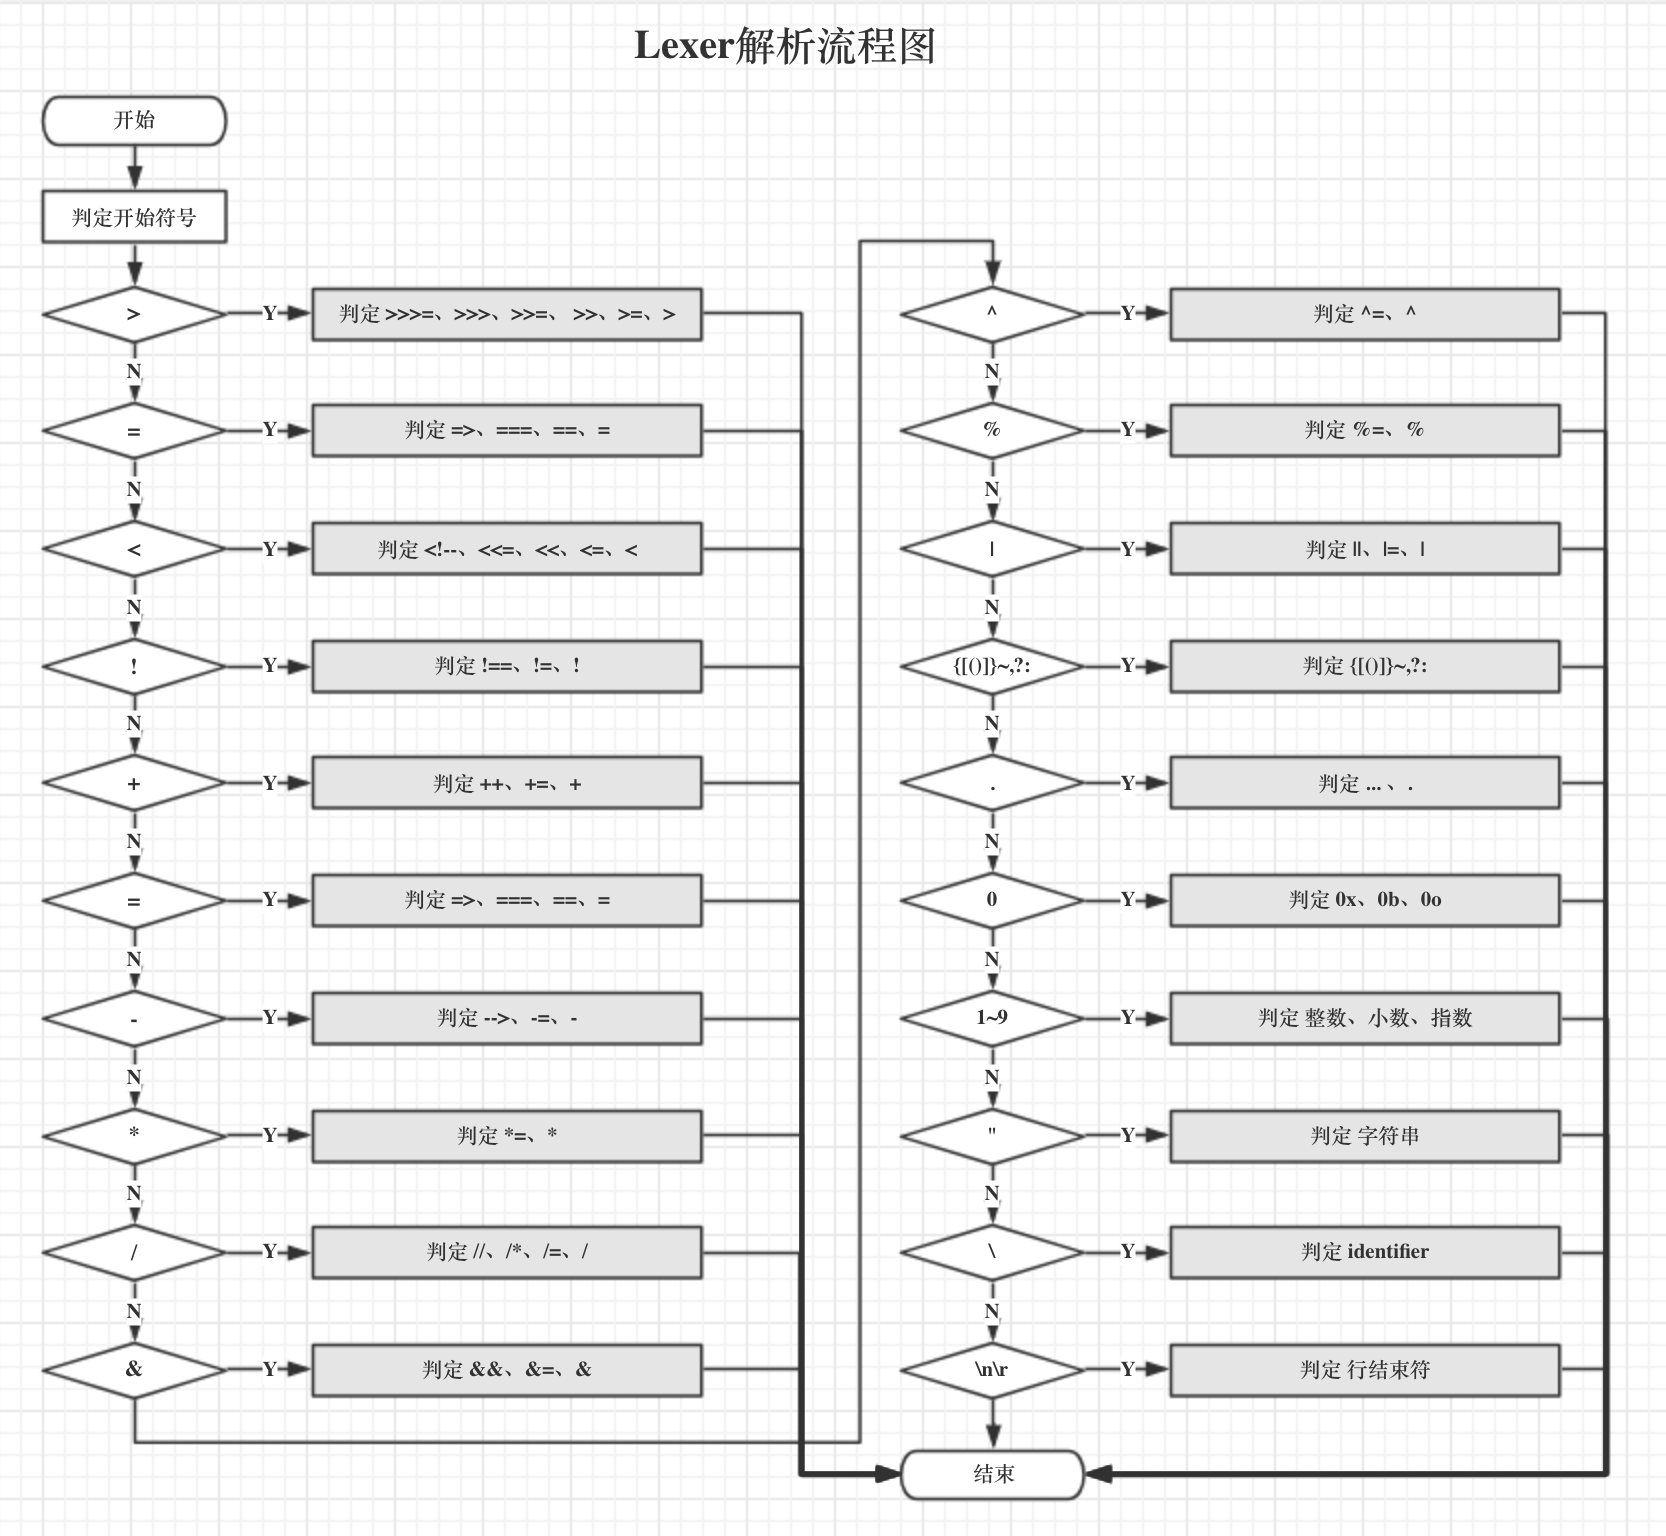
上述的switch语句过后,就产生了一个JSToken,其中大部分case都简单明了,易于理解,不过其中有几个重要的方法值得细看一下
字符串解析
1 | template <typename T> |
parseStringSlowCase的流程和和parseString的流程非常相似,都有转义字符、换行符的处理,以及最后的标识符的创建,不同的是parseStringSlowCase用的容器是m_buffer16,而parseString用的是m_buffer8
1 | typedef unsigned char LChar; |
1 | template <typename T> |
确定好了字符串的起始位置、长度和内容后,再来看下标识符的创建逻辑
1 | template <typename CharType> |
无论上述哪条路径,都离不开Identifier::fromString这个方法,这个方法已经涉及到了虚拟机,想一下:创建标识符肯定得经过虚拟机的记录,以便后续访问或者重复性的处理。这里不太适合分析下去,要不然泥潭就就出不去了,感兴趣的同学可以去看看。
10进制解析
先看下10进制数字的DFA图
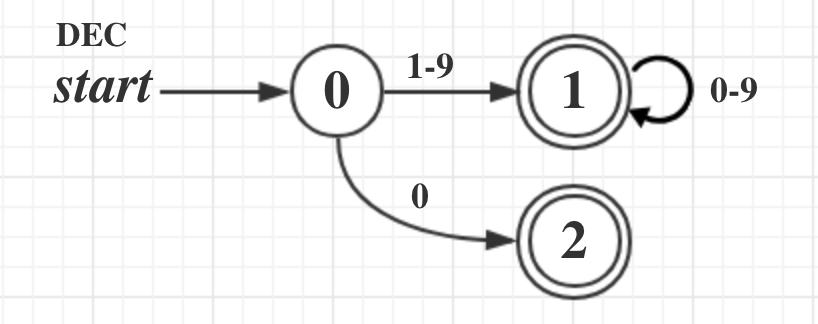
之后对解析到的10进制字符串进行求值,并将结果存放到returnValue中。
1 | template <typename T> |
16进制解析
首先看下如何去分析出一个16进制数字
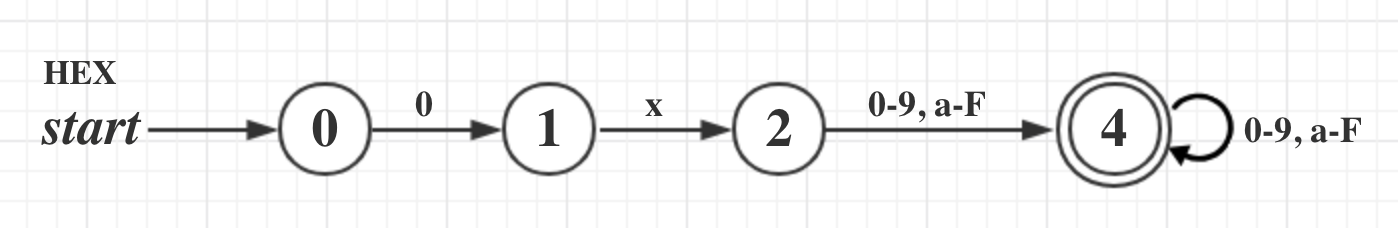
然后计算该16进制的数字的值
1 | template <typename T> |
8进制解析
一样的套路,不再赘言
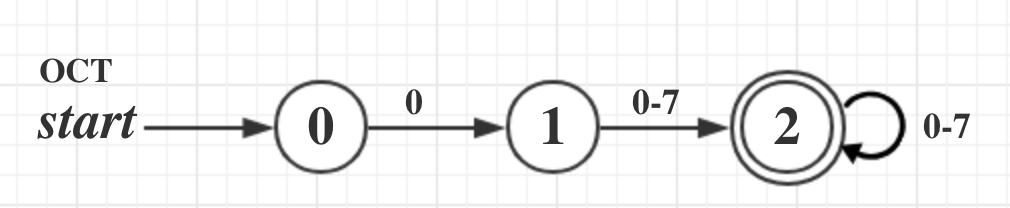
1 | template <typename T> |
N进制整数溢出解析
接下来就是标准的整数解析过程了,2进制、8进制、10进制和16进制的整数,都可以通过此函数进行解析,radix代表进制
1 | double parseIntOverflow(const LChar* s, unsigned length, int radix) |
小数点和指数解析
用DFA转移图来表示下浮点数的解析:
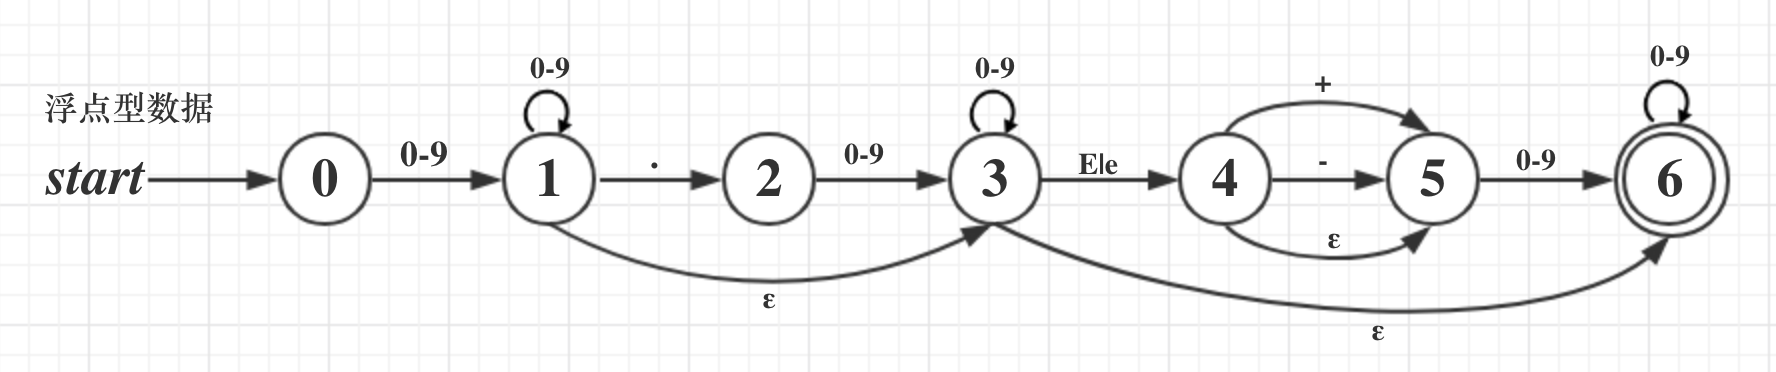
1 | template <typename T> |
多行注释解析
多行注释的DFA转移图:
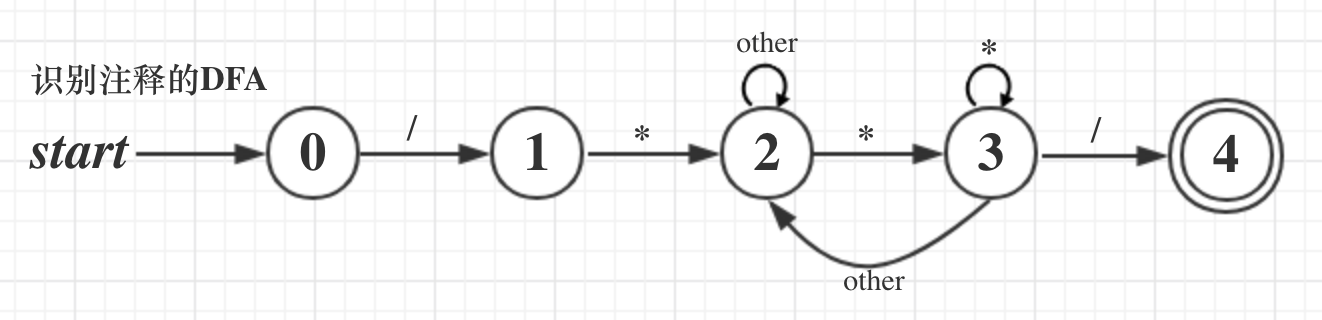
1 | template <typename T> |
示例(更新)
例如有这么一段js代码,包含一个函数、一个变量以及函数的调用
1 | function test(age){ |
在经过Esprima词法分析后,会得到下面的结果:
1 | [ |
总结
经过此过程,一个完整的JSC世界的Token就生成了,整个世界清静了…

