背景
中心重定向,顾名思义,就是将某些流程统一流转到某个中心,然后进行一些切面操作,之后再继续回到原有后续流程。某种意义上来说,中心重定向和
iOS 中的 Hook
非常相似,但是不是同一个东西,中心重定向必须要有1个中心,而Hook可以没有。
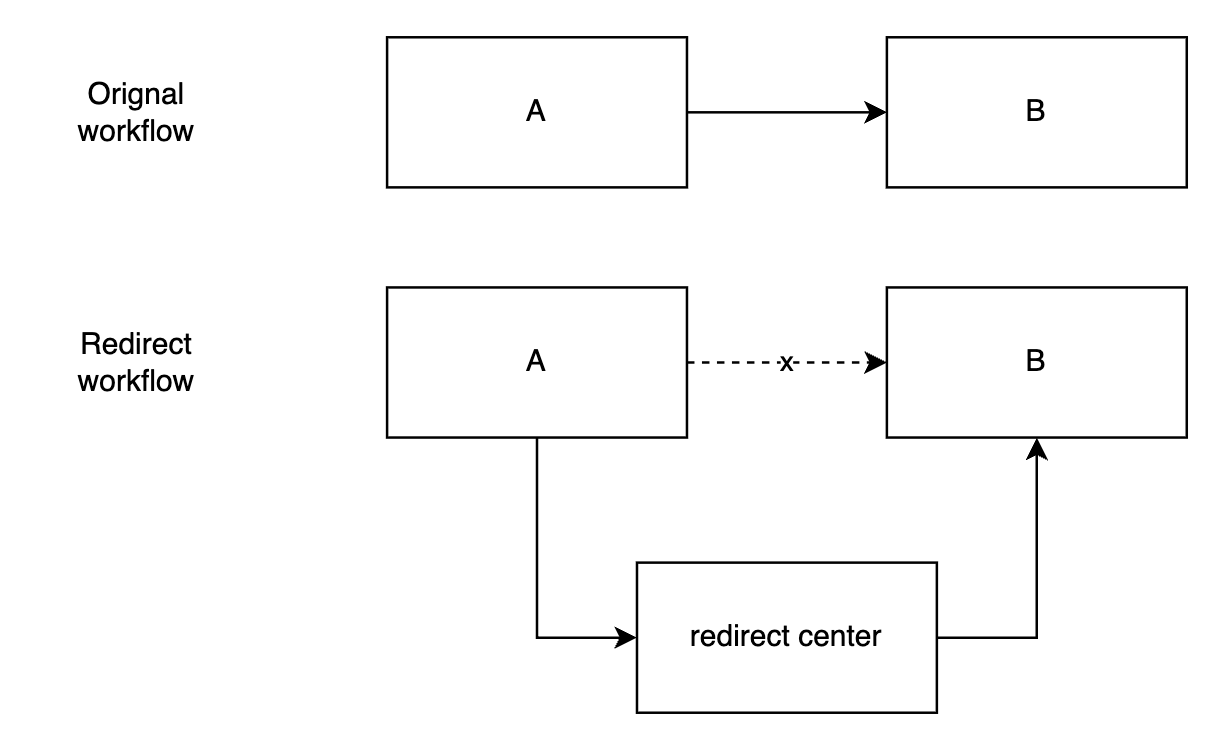
如何中心重定向任意一个Block?
我们知道,所有的 OC 方法最终都会调用到
objc_msgSend 家族,所以如果想重定向 OC
方法,只需要去 hook objc_msgSend
家族即可。那么如何去重定向任意 1 个 Block
呢?
Block虽然本质上也是OC对象,但是它并不会走消息转发逻辑,而是类似于C方法,直接调用。- 不同的
Block的签名是不同的,参数的个数和返回值类型也是不确定的,要重定向任意一个Block会特别困难,很难从OC语言层面去解决这个问题。
经过调研了解到,中心重定向汇编框架 TrampolineHook
可以用于拦截指定函数,在函数被调用时,收到一个回调通知。它是一个不用关注底层架构
Calling Convention(因为涉及到汇编),不用关心上下文信息保存、恢复,不用担心引入传统
Swizzle 方案在大型项目中有奇奇怪怪 Crash
问题的中心重定向框架。那么这个机制能不能用于 Block
的重定向呢?通过调研发现是可行的,我决定使用其原理机制,来实现一个
Block
的重定向框架:TrampolineBlockHook,并同时支持
arm64 和 x86_64 架构。
Git地址: https://github.com/tsuijunxi/TrampolineBlockHook.git
目前效果
TrampolineBlockHook 提供了非常简单的 API
来重定向 Block 和撤销重定向
1 | extern BOOL hook_block_with_stub(void *replaced, void *replacement, void *pre, void *post); |
深入讨论之前,先看下目前的效果
1 | void pre(void *p1, void *p2) { |
输出结果如图所示:
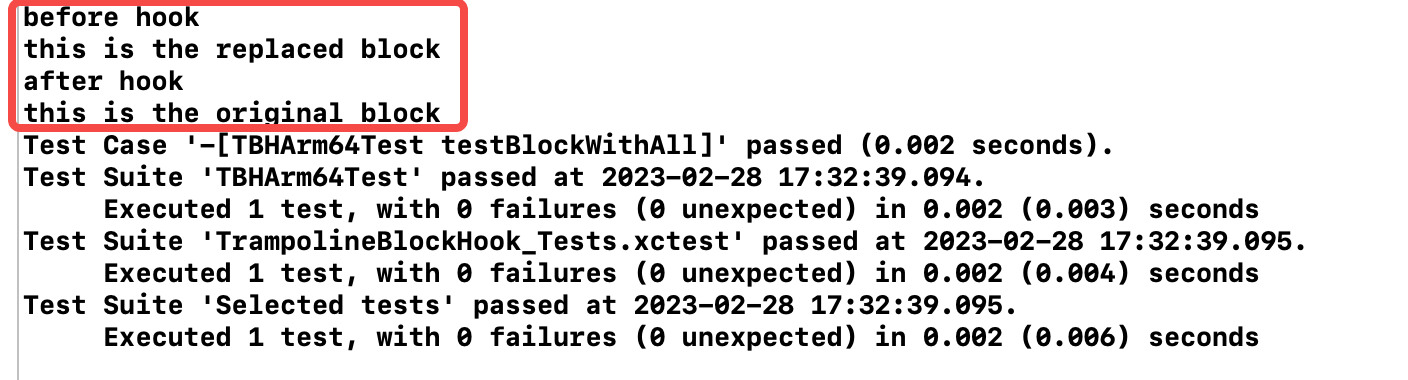
hook_block_with_stub 方法的第 2
个参数可以和第 1 个参数相同,代表并没有替换
Block 的实现,只是在Block的前后添加了
2个函数插桩:pre 和 post。
vm_remap 技术
原理
iOS 系统存在限制,我们没有权限创建可写可执行内存,但
vm_remap 可以间接突破这个限制。
On Darwin, vm_remap() provides support for mapping an existing code page at new address, while retaining the existing page protections; using vm_remap(), we can create multiple copies of existing, executable code, placed at arbitrary addresses.
vm_remap 可以让内存页具备被 map
的页的特性,如果是可执行页被
map,那新创建的页自然而然也具备了可执行权限。 使用
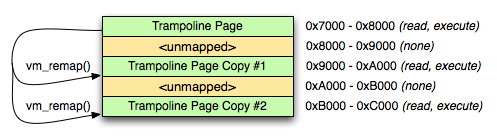
vm_remap,我们可以创建可执行代码的多个副本,并且可以放置在任意地址。如图(
来自 Implementing
imp_implementationWithBlock() ),我们可以事先编写一页可执行代码
Trampoline Page,在运行的时候可以可以通过
vm_remap 机制创建副本:Trampoline Page Copy #1
和 Trampoline Page Copy #2,用于执行代码。
然而,这仅仅解决了一半的问题。每个
Trampoline Page可能包含多个
Trampoline Entry(每有 1 个 Block
被重定向,就会有 1 个相应的
Trampoline Entry),但是这些 Trampoline Entry
需要一些对应的信息(例如 Block
的原有地址,前后的插庄函数地址等),这些信息则需要在对应的
Trampoline Data 页面进行配置。
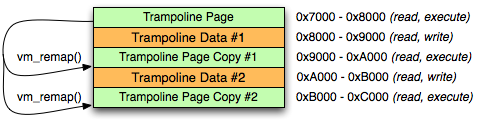
如果将Trampoline Data 页面映射到
Trampoline Page 页面旁边,则可以使用 PC
相对寻址从相邻的 Trampoline Data
页加载需要的数据。如图,如果 Trampoline Page Copy #1
中的某个 Trampoline Entry 需要一些信息,则可以到
Trampoline Data #1 页对应的位置去加载。
代码实践
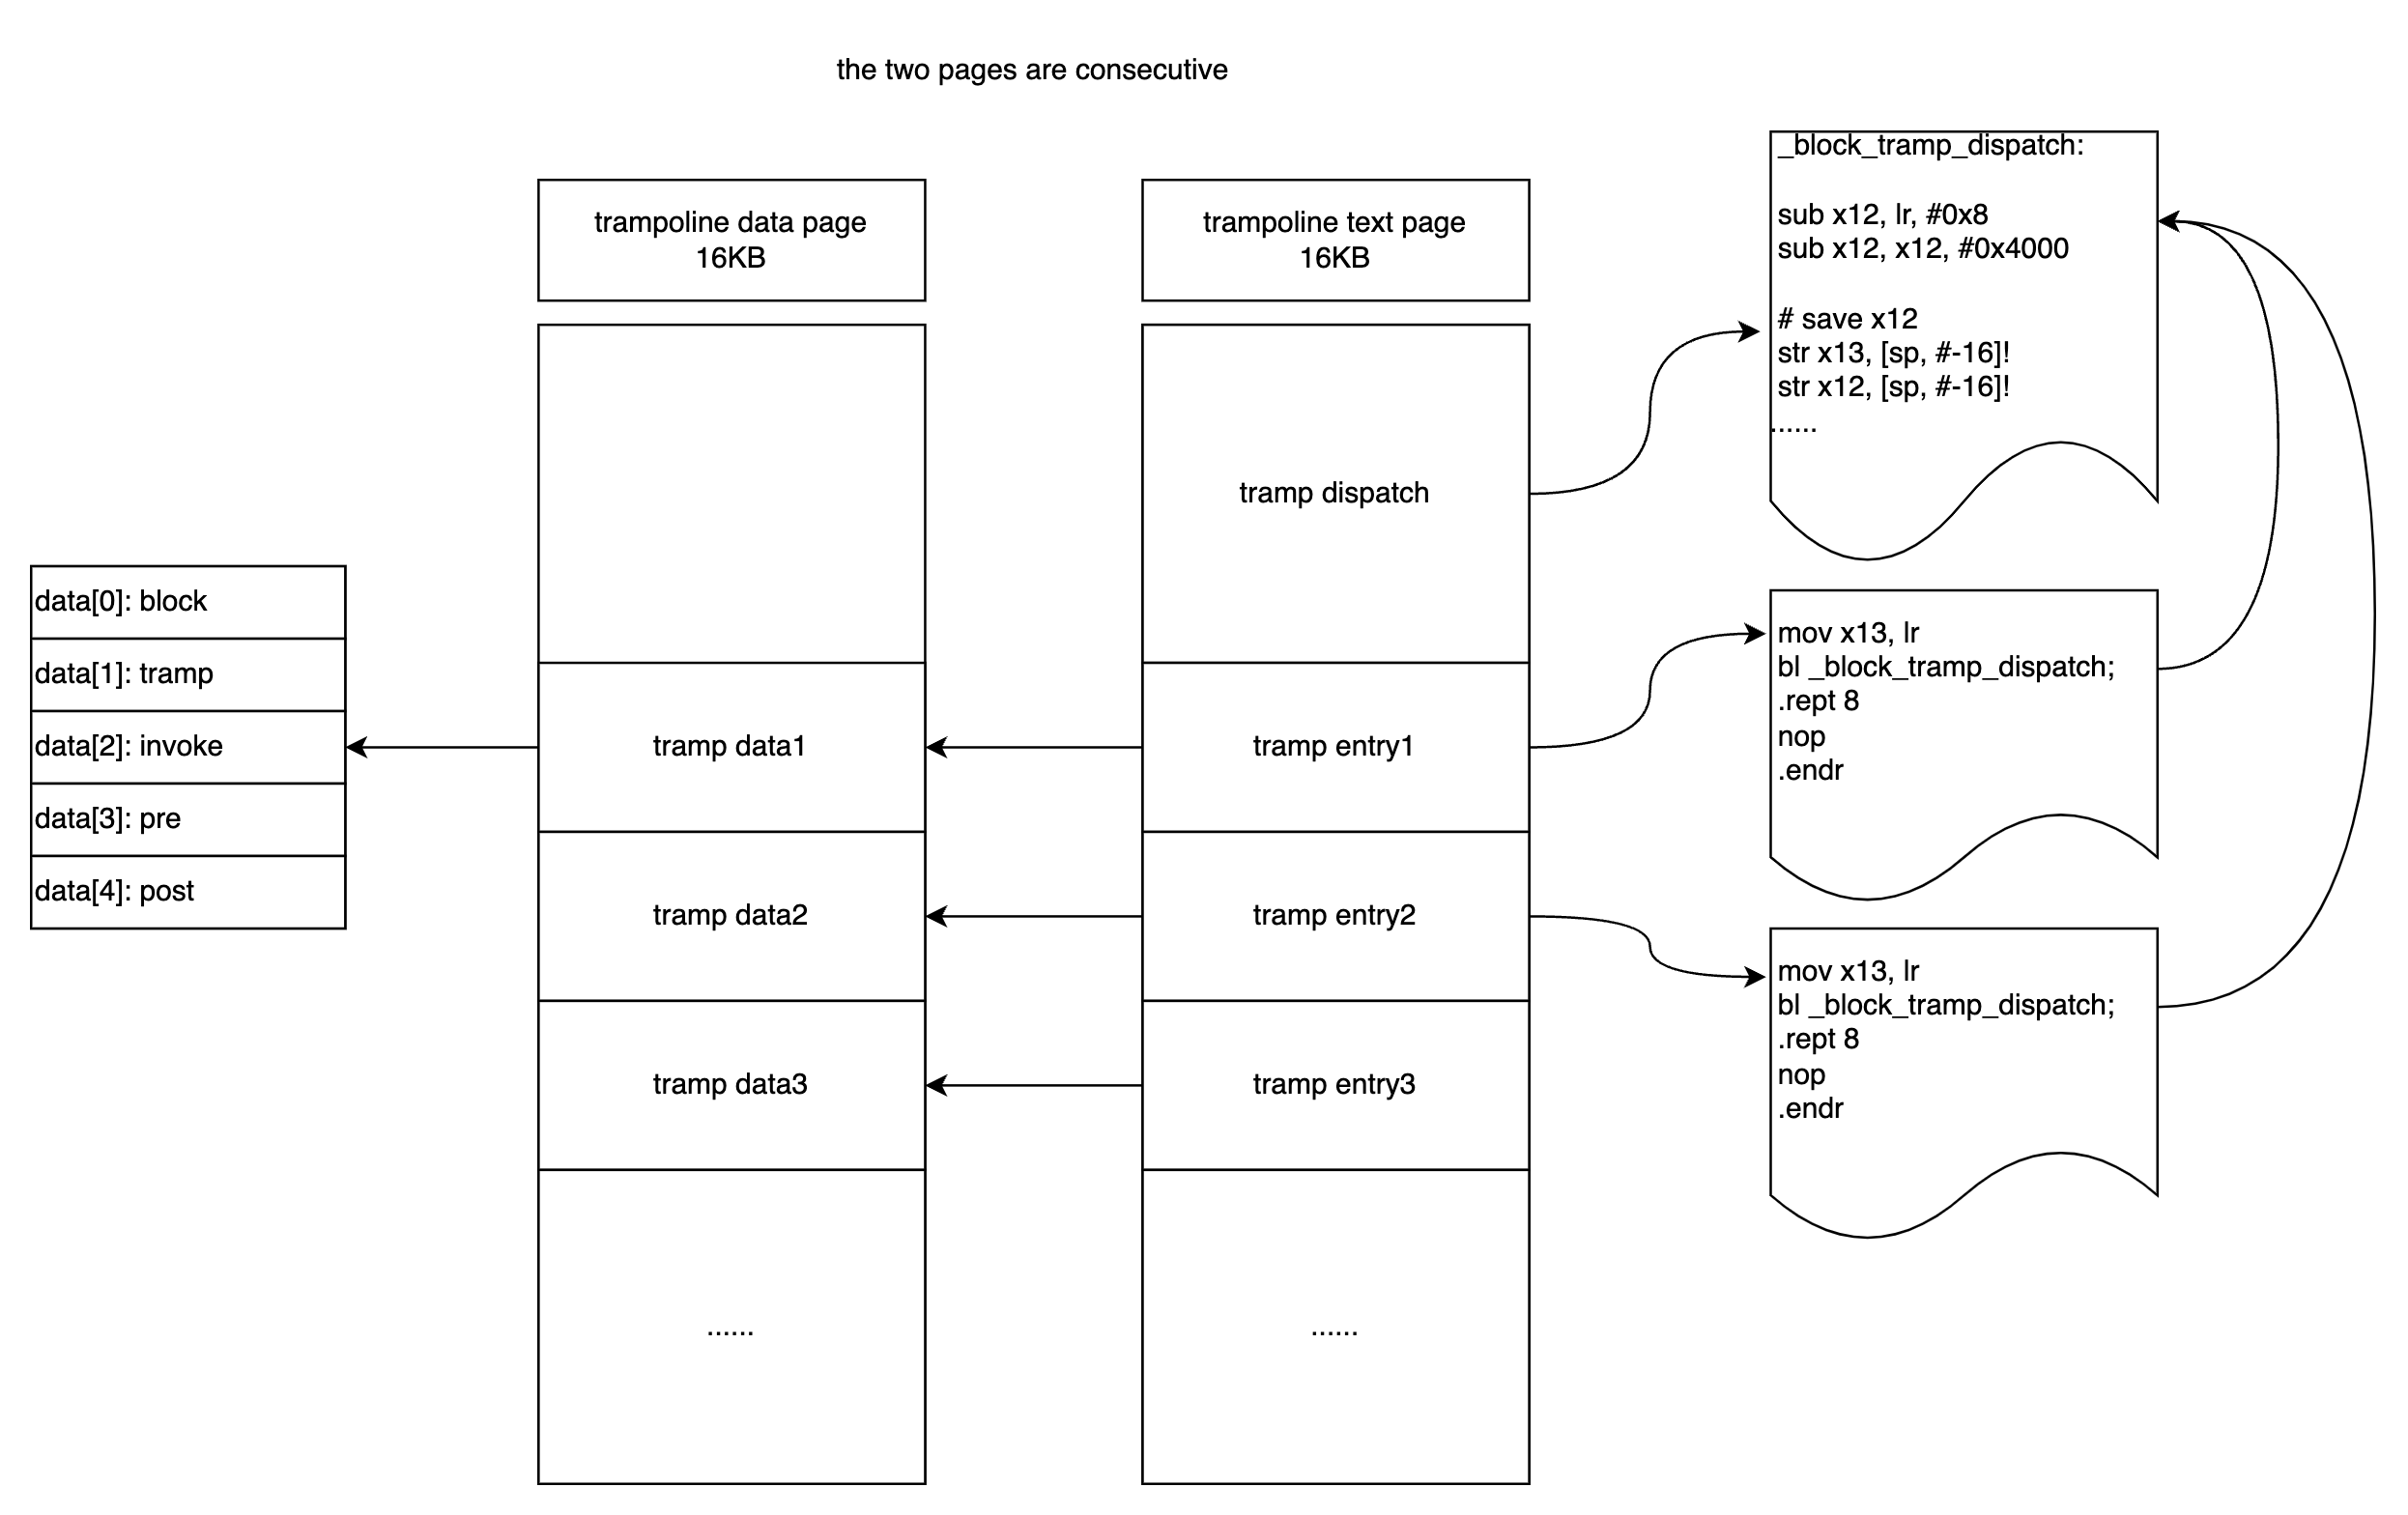
这里我们通过 vm_allocate 分配连续的两页内存,通过
vm_deallocate 释放第二页内存,最后通过
vm_remap将 trampoline_page
映射到第二页内存。这就构建好了我们需要的两页内存,第一页空的,用于存储一些数据信息,例如
Block 地址、插桩函数地址(例如 pre 和
post)等,第二页映射好了所有的动态可执行地址。反映到图中,第一页对应
trampoline data page,第二页对应
trampoline text page。
1 | // alloc two pages |
仔细的同学会发现,第一个 tramp entry1 的前面有一段代码
tramp dispatch,这段代码的大小决定了
tramp entry1
的偏移。有两种方式来计算这段代码的大小,一个是手动计算,另一种是利用工具
Hopper。
Block 的结构表达
为了可以重定向任意的Block,而不用关心其参数、返回值等,需要找一种结构体来描述Block。这里可以借助 https://github.com/apple-oss-distributions/libclosure/blob/main/Block_private.h 中的Block_layout来描述。
1 | struct Block_descriptor { |
流程跳转逻辑
- 把一个我们要替换的
Block地址A取出来,保存起来; - 给这个
Block重定向一个动态分配的可执行地址B; - 当执行这个
Block的时候,会跳转到可执行地址B; - 这个
B经过一段操作,可以获取到原先保存的 地址A; - 在跳转回地址
A之前,跳转到pre stub做一些事情; - 跳转到地址
A,执行原有逻辑; - 执行完原有逻辑后,跳转到
post stub再做一些事情。
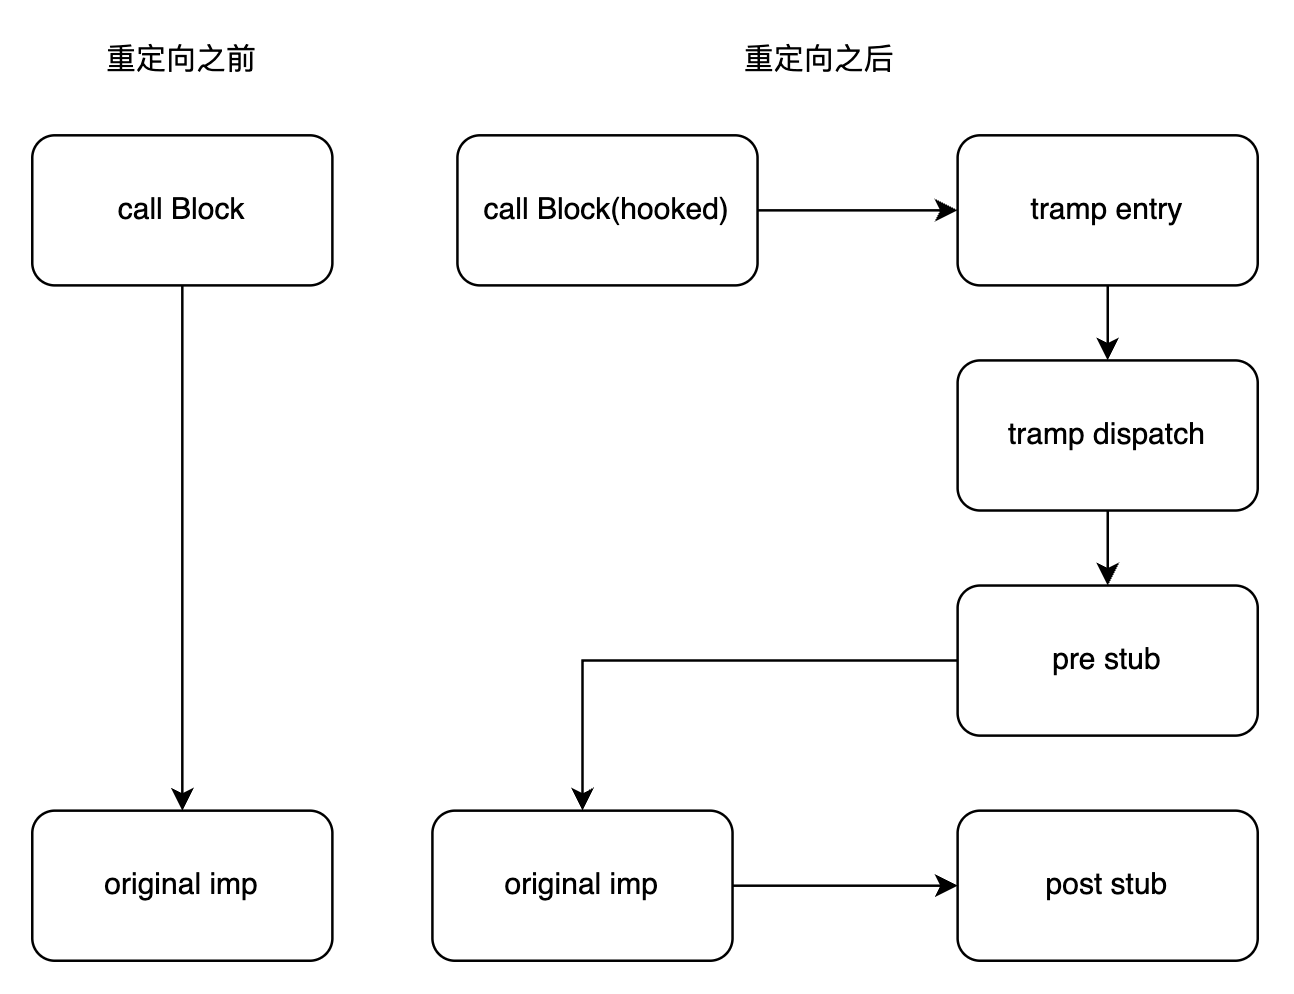
上述重定向之后的跳转流程中,我们需要拿到 Block 的
pre stub 和 post stub
信息,这些代码的地址配置在数据页面,那么我们需要在重定向的时候完成这些配置操作。
1 | extern BOOL hook_block_with_stub(void *block, void *replacement, void *pre, void *post) { |
红色区域即相关数据,代表 1 个 tramp data
:包含 5 个槽,依次放置 ReplacedBlock
、tramp
、ReplacedBlock->invoke、pre 和
post。 另外我们需要将原 Block 的
invoke 指针指向代码区的 tramp entry,这样
Block
执行的时候就可以直接跳转过去。同时为了能够正常撤销重定向,需要将 原
Block 原先的实现逻辑保存下来,正好这里可以借助于
layout->descriptor->reserved 字段来存放。
重定向之后,如果想撤销重定向,则很容易理解
1 | BOOL unhook_block(void *block) { |
arm64 汇编实现
那么接下来最关键的就是汇编中怎么处理这些跳转逻辑
寄存器
先简单温习下 arm64 的寄存器基础
1 | - x0 - x7:用于传递子程序参数和结果,使用时不需要保存,多余参数采用堆栈传递,子程序返回结果写入到 x0 |
汇编代码
1 | #if defined(__arm64__) |
在 arm64 中,一页是 0x4000,也就是 16KB,这里 .align 14 来确保 在 arm64 中,每行指令无论长短,一律为4个字节
接下来我们将逐行解释:
由于
Block被重定向到tramp entry(81~87行),所以Block的调用会跳转到81行(这里假设是第1个被重定向的Block,因为81行 ~87行的外面包着.rept指令,会重复404次)。为什么要重复404次呢?这是通过计算得到的:每个页面的大小16KB=16384B,减去偏移224B,每个tramp entry的大小为40B,那么就(16384-224) / 40 = 404。也就是说每个页面可以容纳404个Block被重定向。代码
81~87行实际上展开如下所示,总共占40个字节。此时lr寄存器保存了Block之后的地址,执行完汇编代码我们要能跳回去,所以这个地址需要保存下来,这里保存到x13寄存器。然后跳转到_block_tramp_dispatch。为什么后续要跟着8个nop?这是由于每个tramp data的大小是40字节,为了使得每个tramp data和每个tramp entry的大小和偏移都一一对应,所以这里需要凑够40个字节,每个指令4个字节,所以一共需要10个指令
1 | mov x13, lr |
39~40行,由于是从83行跳转过来的,所以此时lr里面存着84行的地址。lr减去8则为81行地址,81行地址减去一个页面大小#0x4000,则为对应的数据页面的tramp data地址。
1 | sub x12, lr, #0x8 |
43行,将刚刚计算的tramp data地址存储到栈帧上
1 | str x12, [sp, #-16]! |
46行,x13寄存器此时存着Block之后的地址,这里也把它存储到栈帧上。
1 | str x13, [sp, #-16]! |
49~50行,x12寄存器存着tramp data,tramp data地址偏移24个字节,取出pre stub的地址,进行判空,如果为空,直接跳转到block标签。这里为什么是24个字节呢?可以看到我们在重定向的时候,把pre放到了config[3],前面的config[0]~config[2],每个占8个字节,一共24个字节,所以需要偏移24个字节。
1 | ldr x13, [x12, #0x18] |
53~56行,此时x13寄存器保存着pre的地址,blr可以直接跳转调用。但是汇编过程中调用别的函数时,需要保存caller save寄存器,调用完毕后,需要恢复caller save寄存器。
1 | pre: |
59~61行,x12寄存器存着tramp data,tramp data地址偏移16个字节,则为Block的原先实现地址,加载到x13寄存器,直接跳转。注意这里我们并没有保存和恢复caller save 寄存器,主要是因为这里要保持和重定向之前相同的现场:想想看,如果原来的Block返回某个值,我们也希望被重定向之后,还能返回相同的值。
1 | block: |
64~71行,重新从栈帧中把tramp data地址加载到x12,x12寄存器存着tramp data,tramp data地址偏移32个字节,则为post的地址。接下来的调用类似于pre,不再赘述。这里为什么要重新加载tramp data呢?主要是因为上一步block的调用没有保存caller save寄存器,可能会破坏掉x12中的值。
1 | ldr x12, [sp], #16 |
74~76行,把Block后面的地址从栈帧中加载到x13寄存器,然后进行跳转。
1 | end: |
Hopper示意图
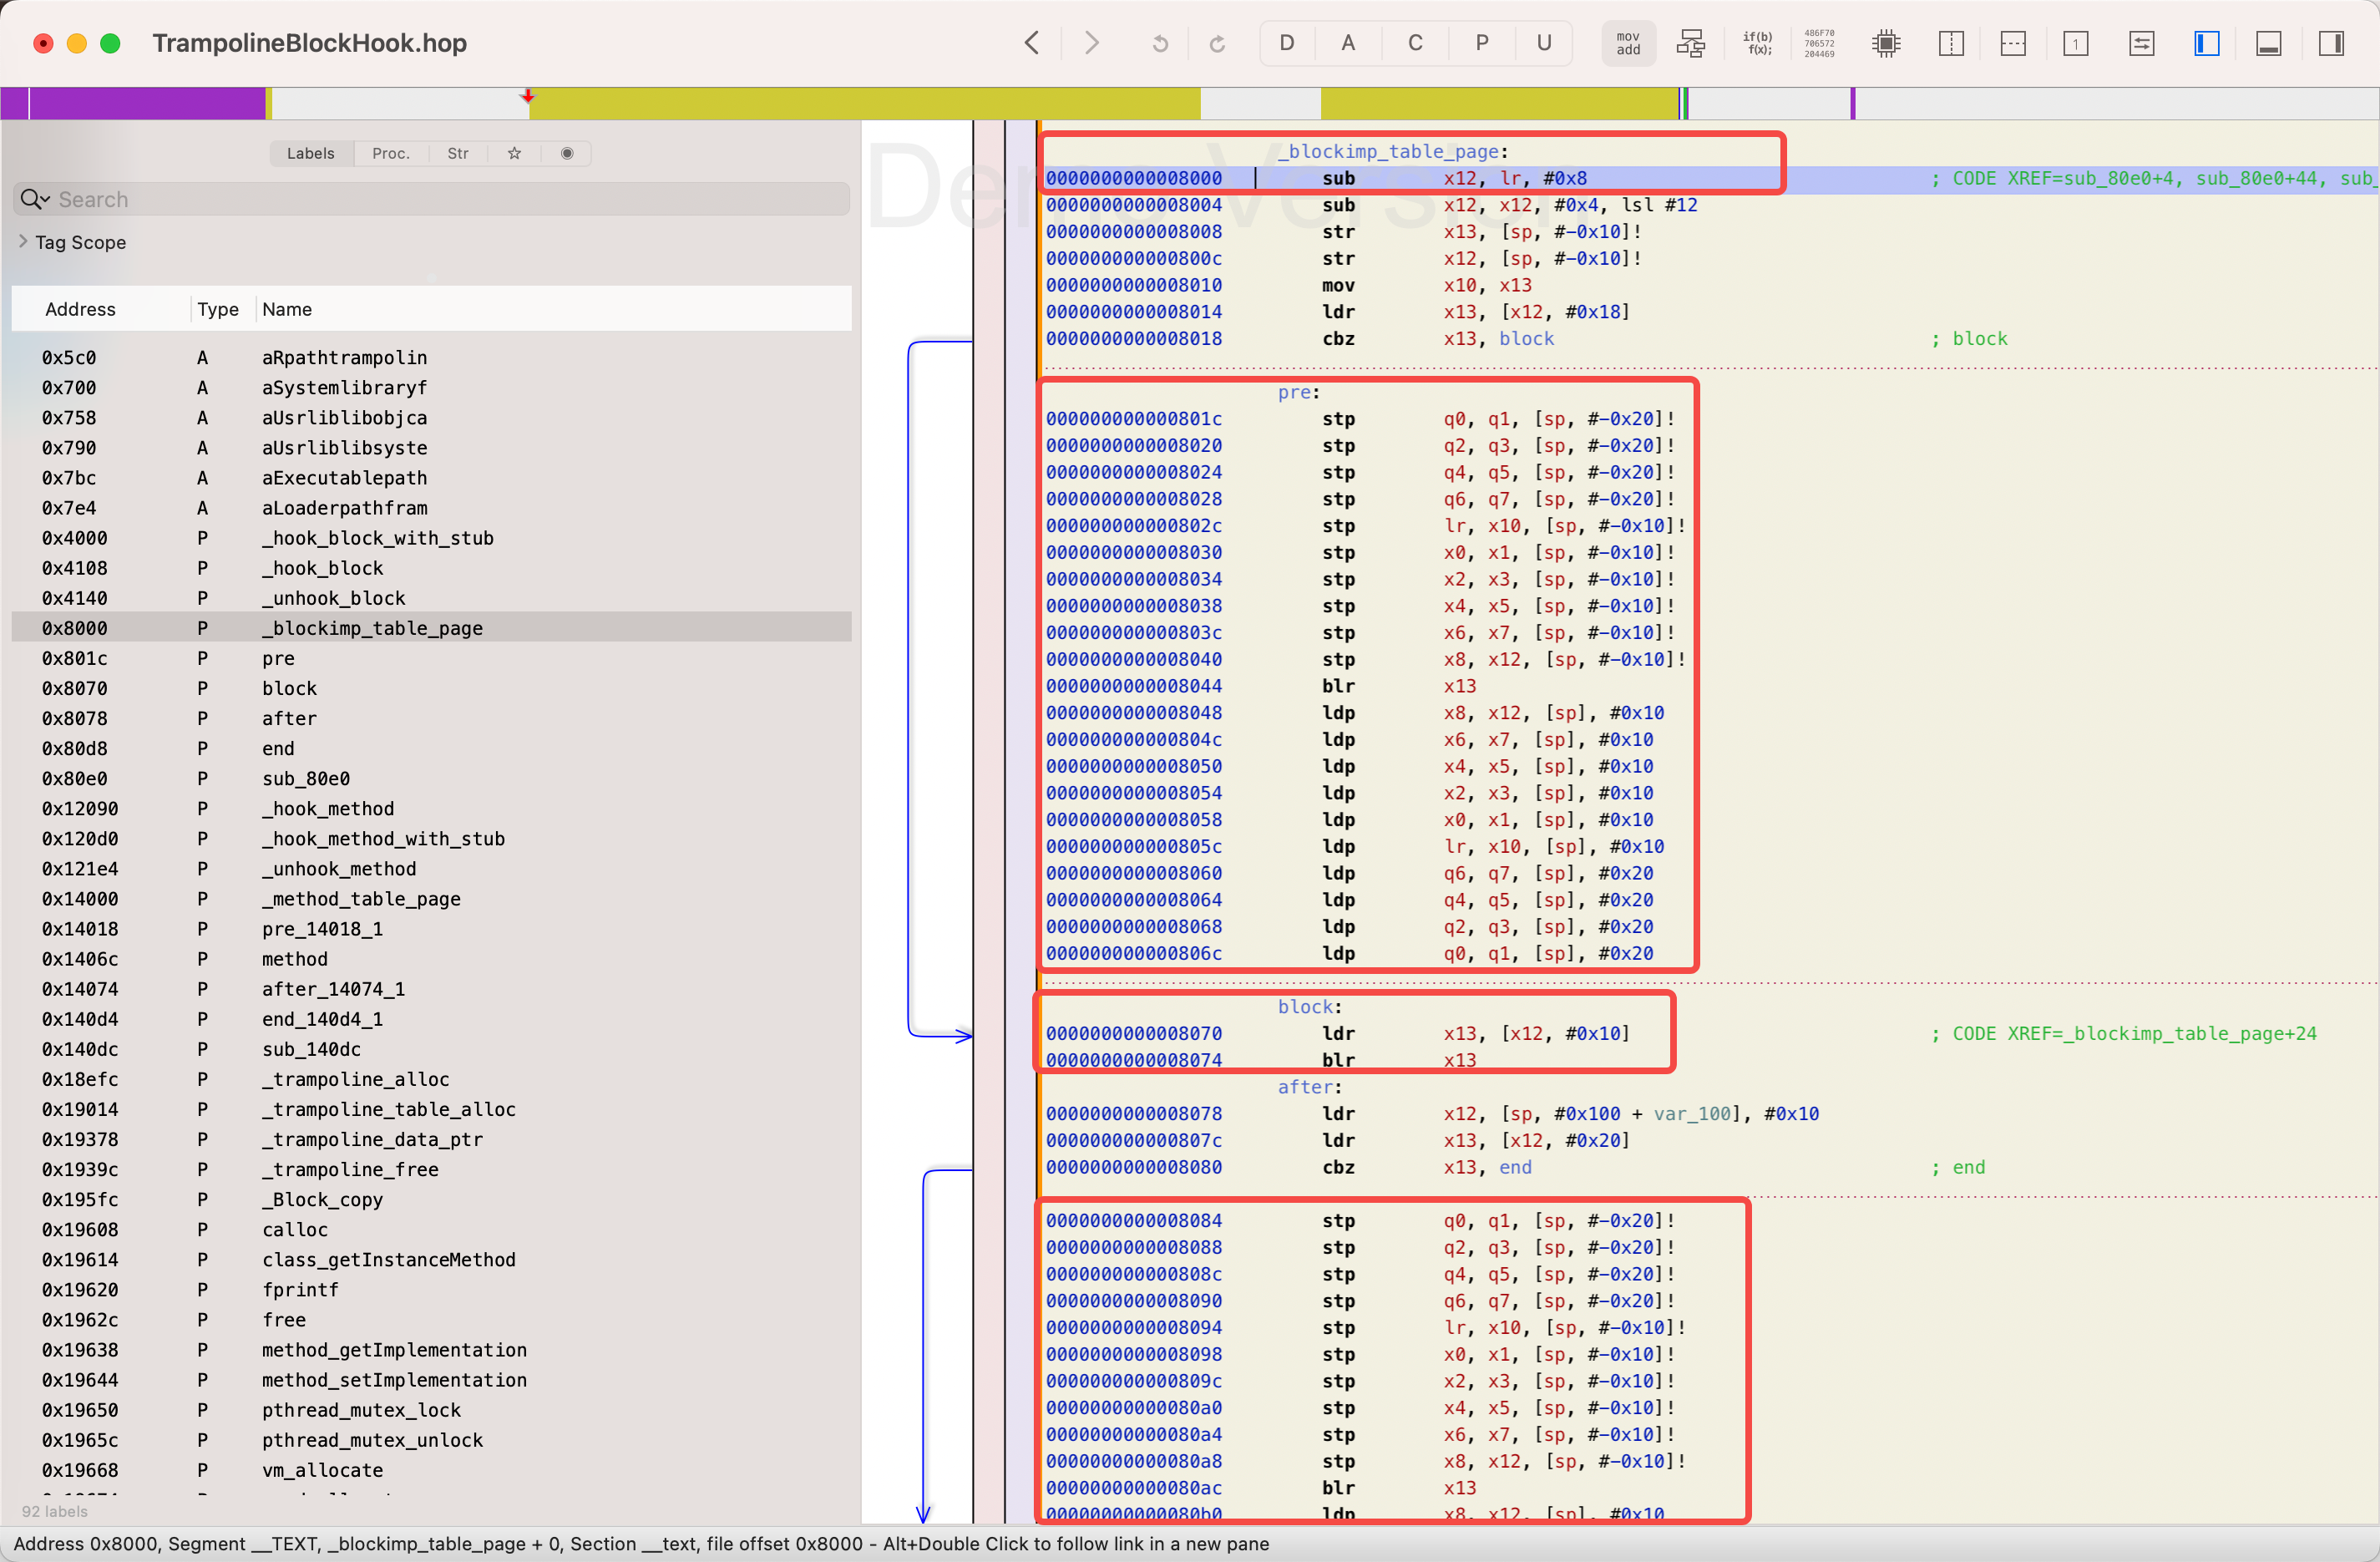
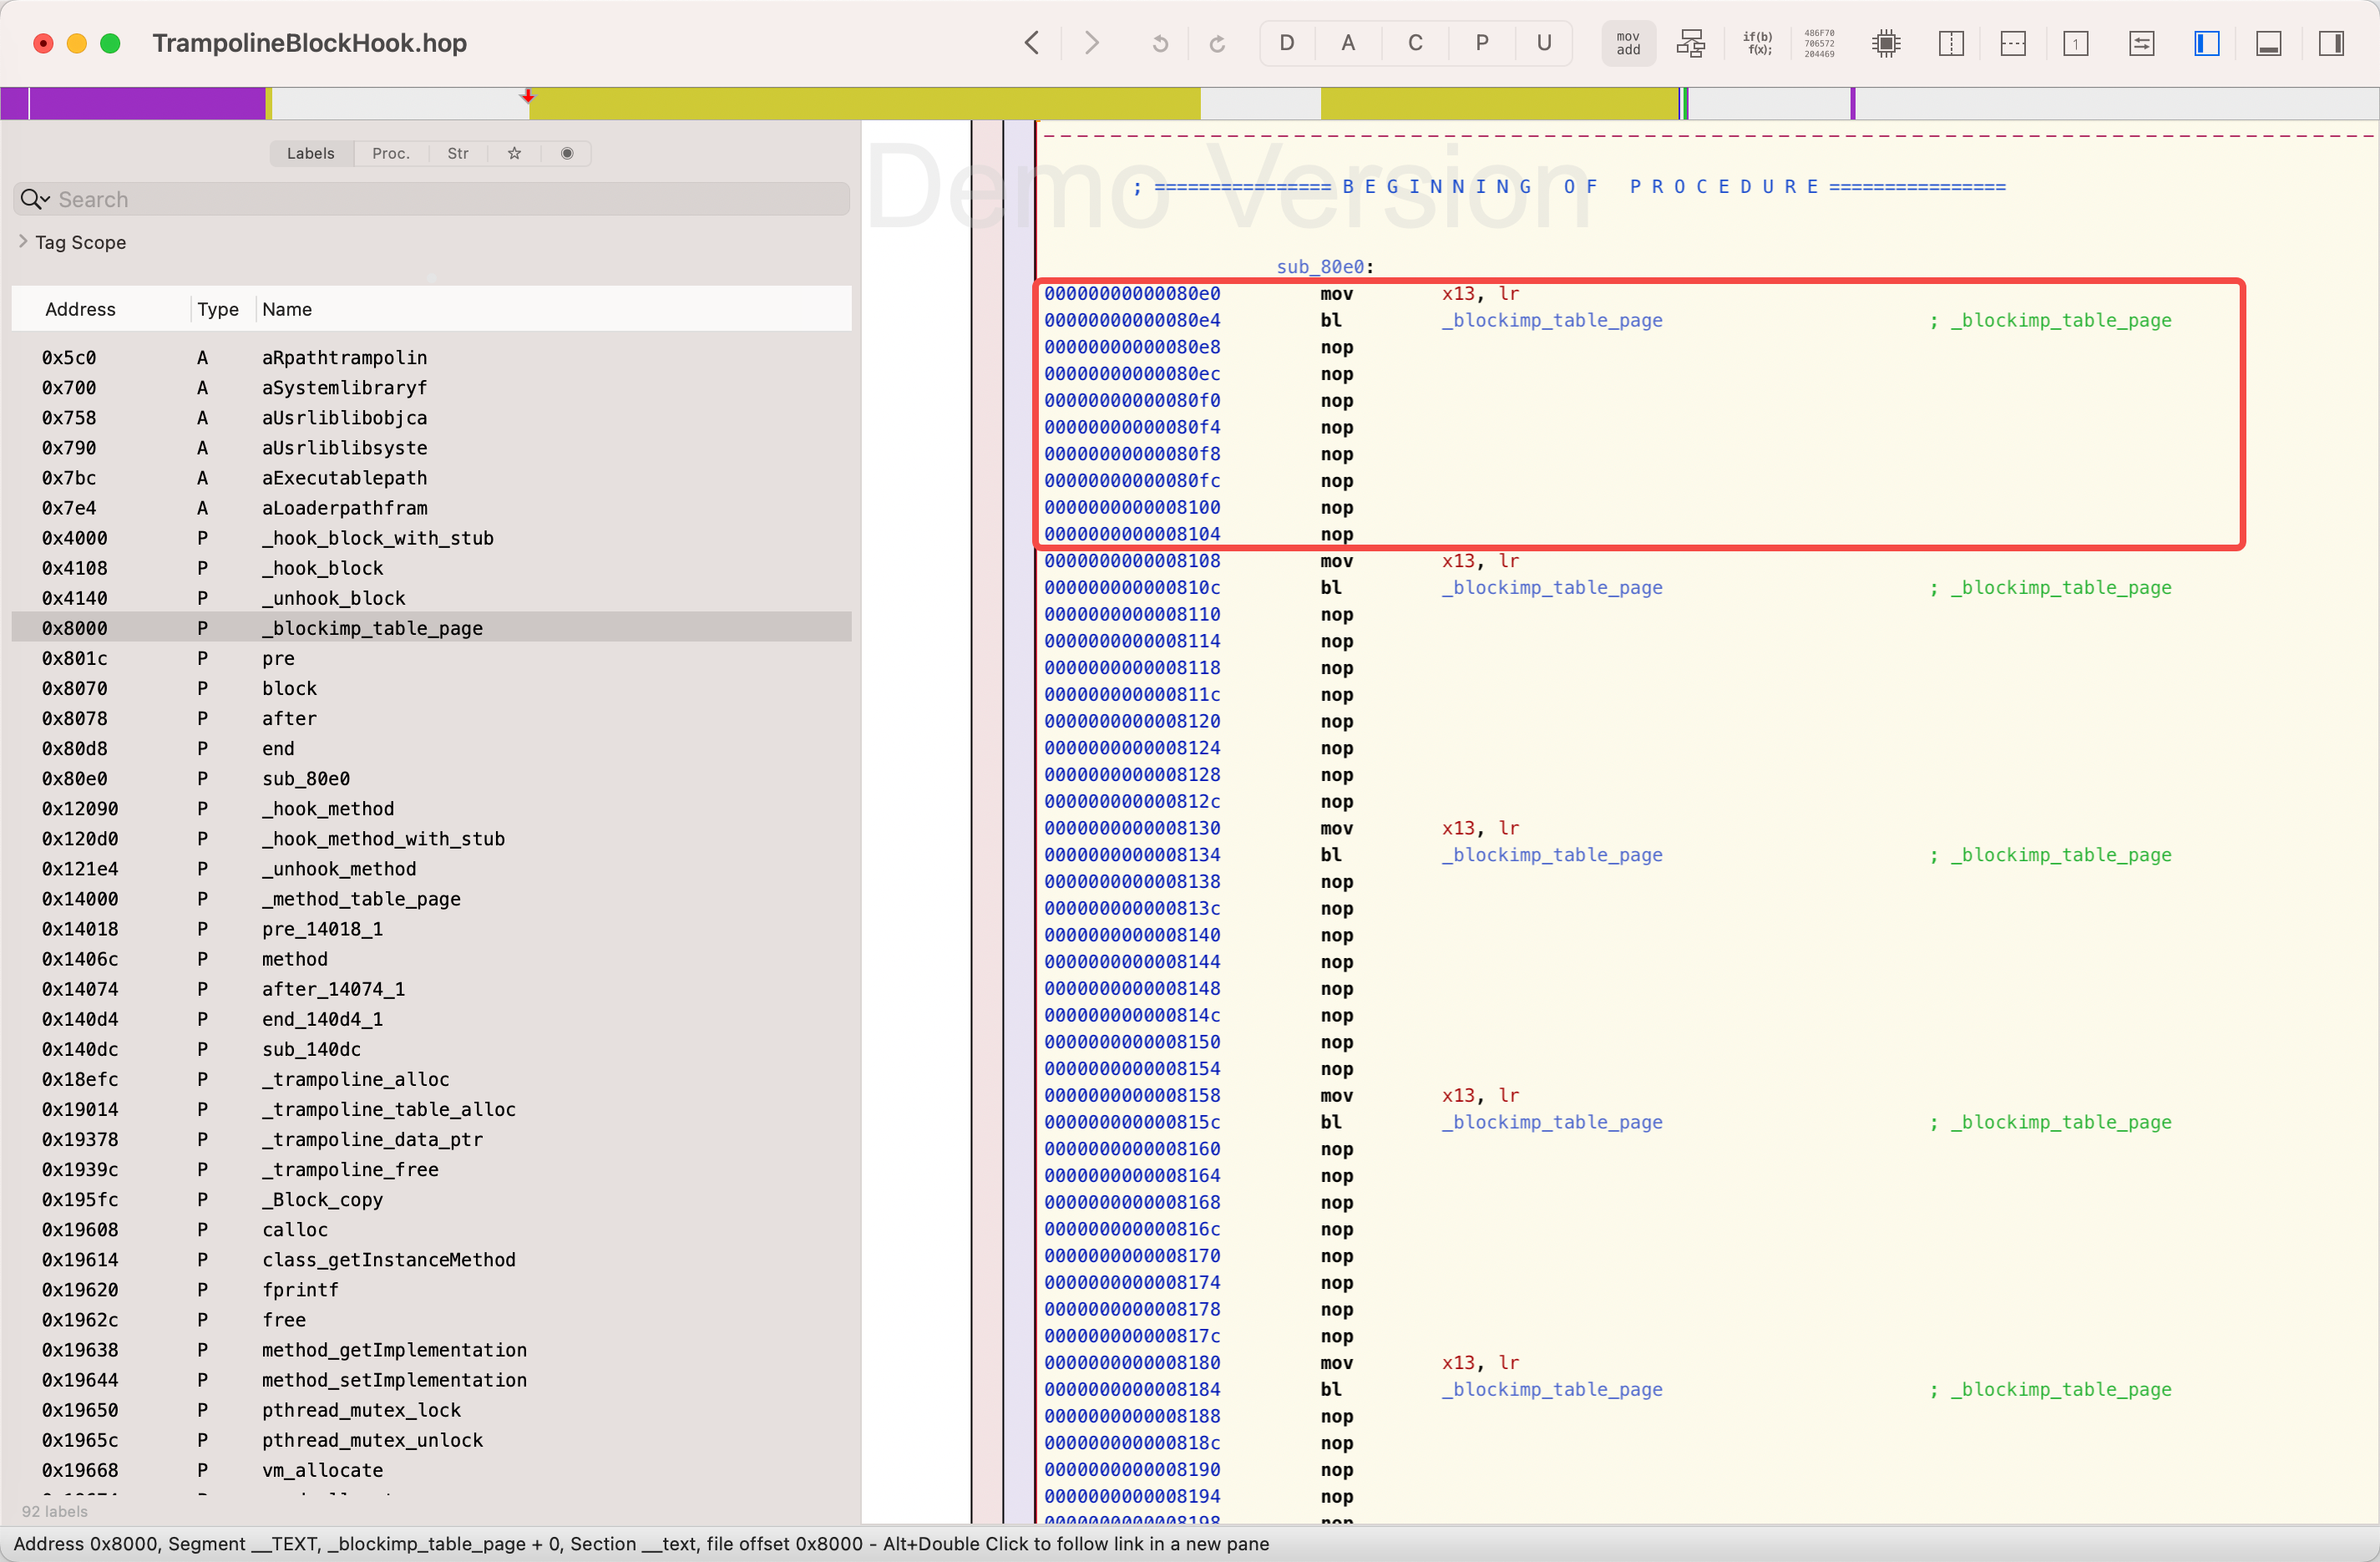
仔细观察,会发现左图中 _block_tramp_dispatch 的地址为
0x0000000000008000,是一个页面的首地址,同时从右图中可以看到首个
tramp entry 的地址为
0x00000000000080e0,那么偏移为
0xE0,正好是前面提到的224。
x86_64 汇编实现
寄存器
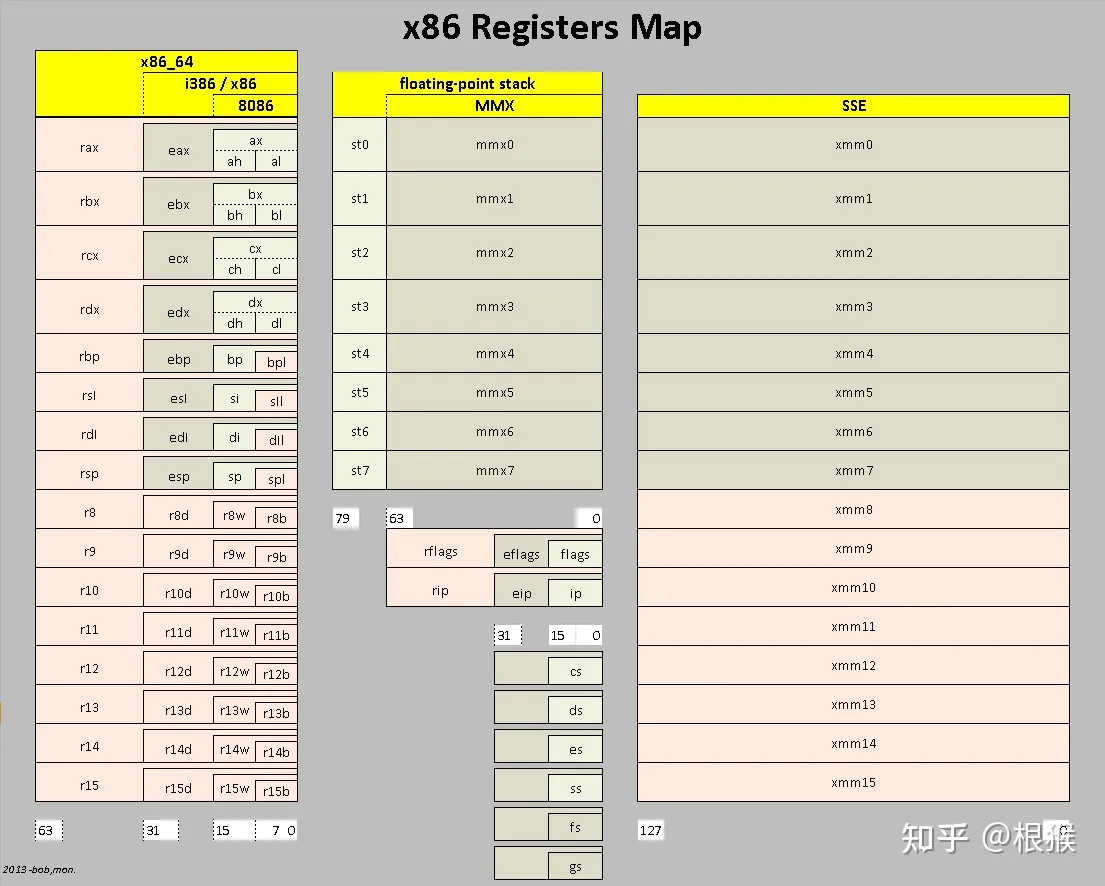
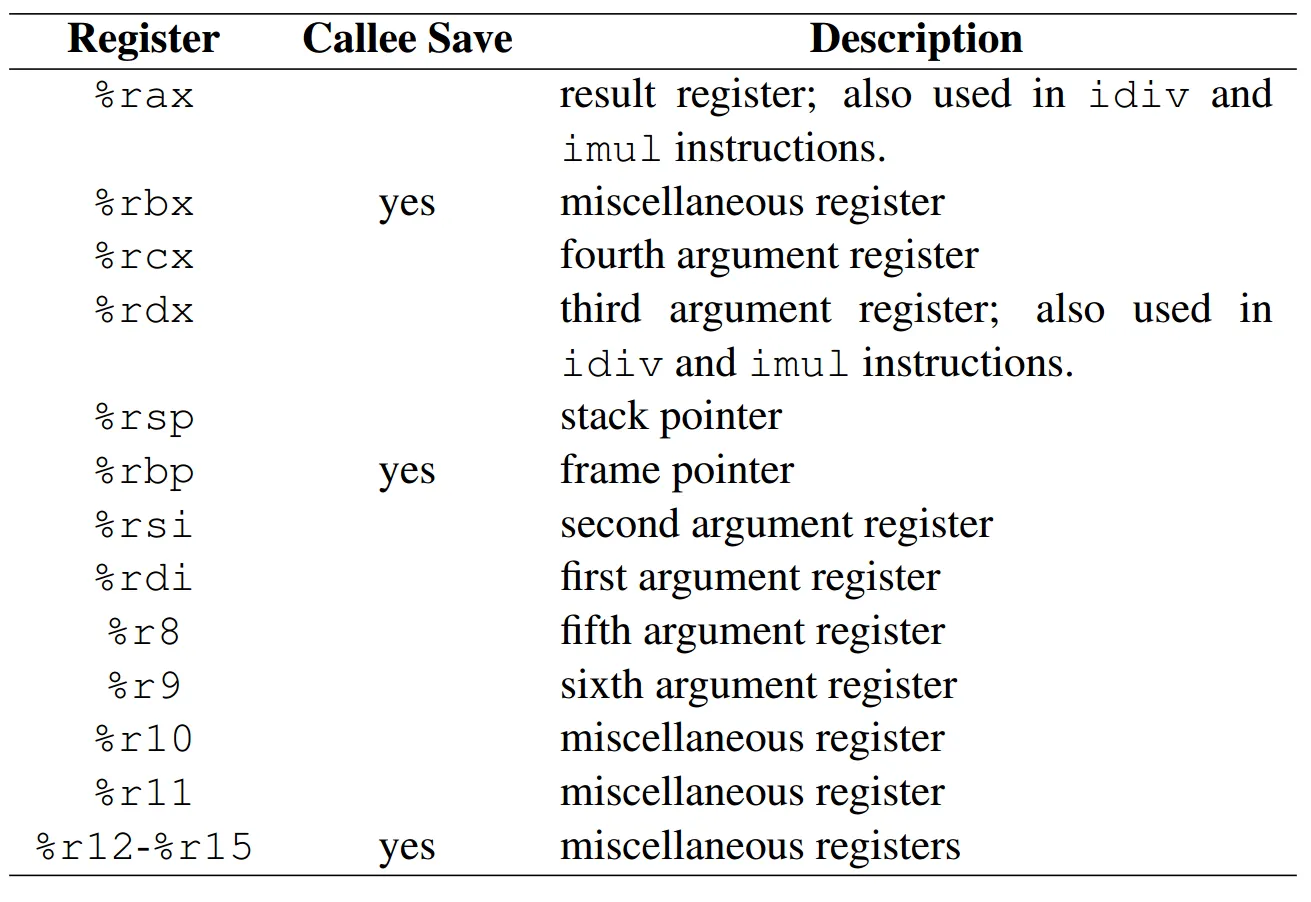
汇编代码
在 x86_64 中,一页是 0x1000,也就是 4KB,所以首先就是 .align 12 来确保 在 x86_64 中,指令的大小是不固定的。
x86_64 的汇编代码逻辑和 arm64
的逻辑基本一致,这里就不再逐行展开
1 | save_register |
Hopper示意图
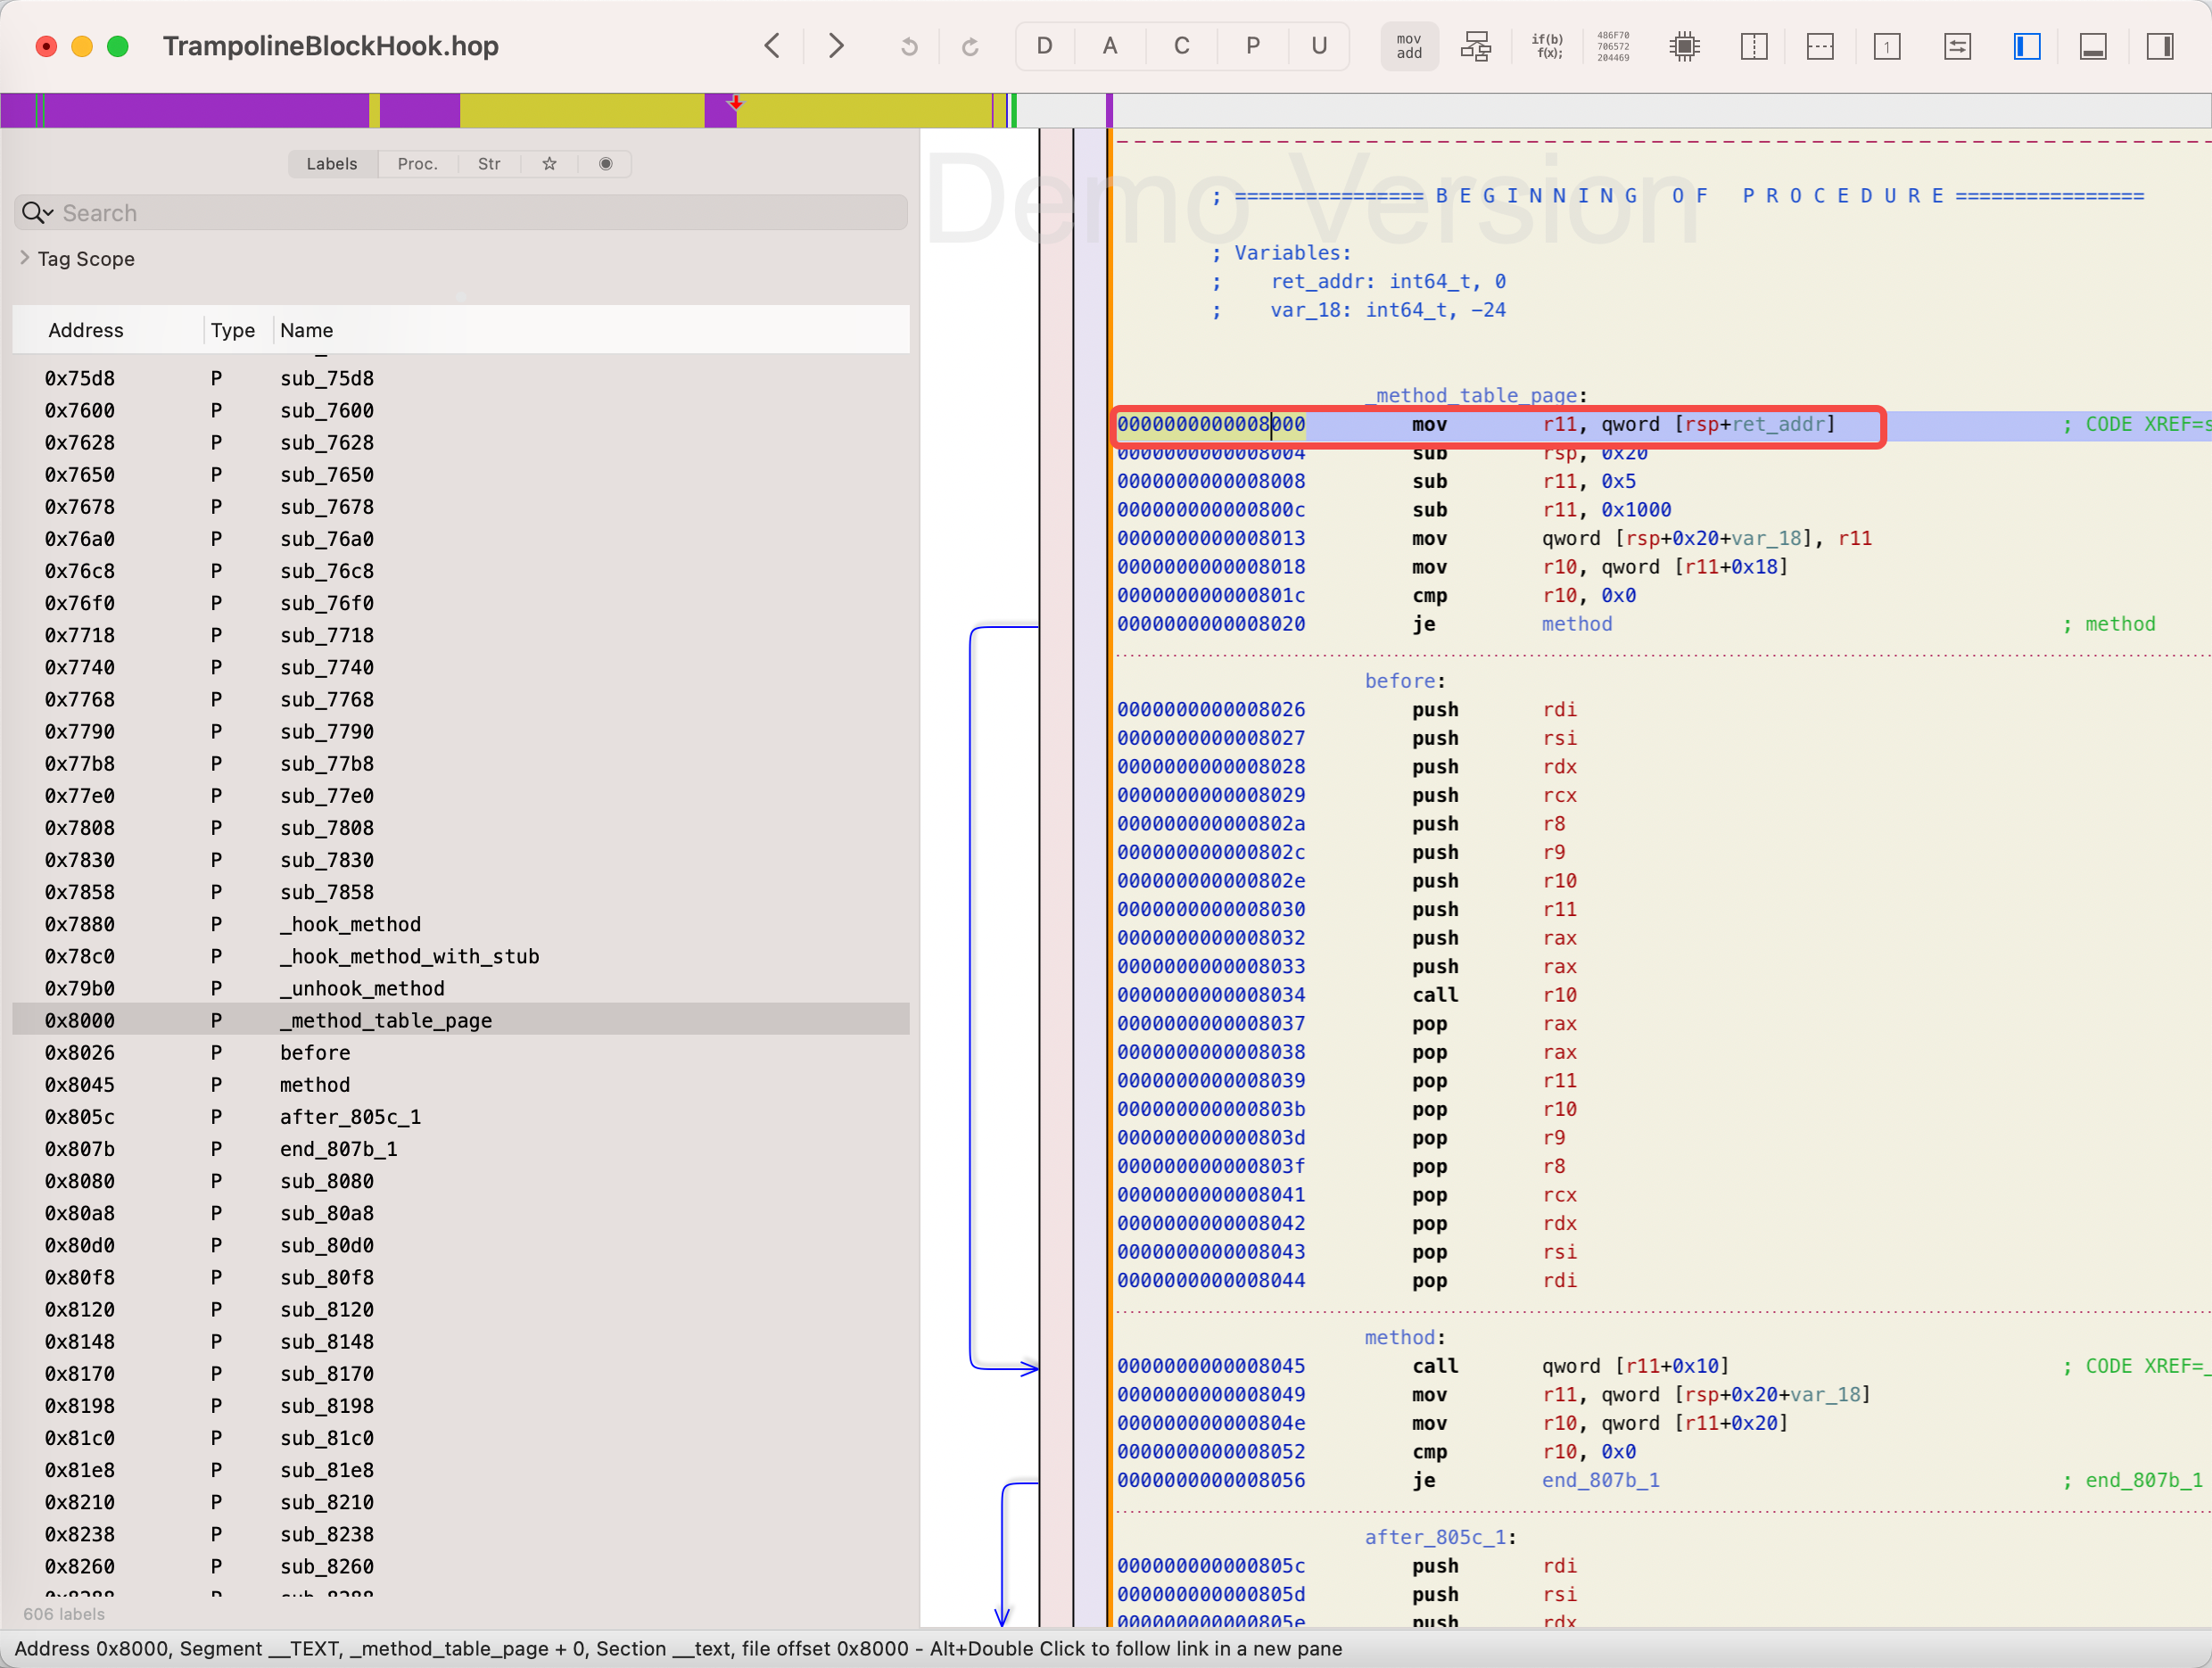
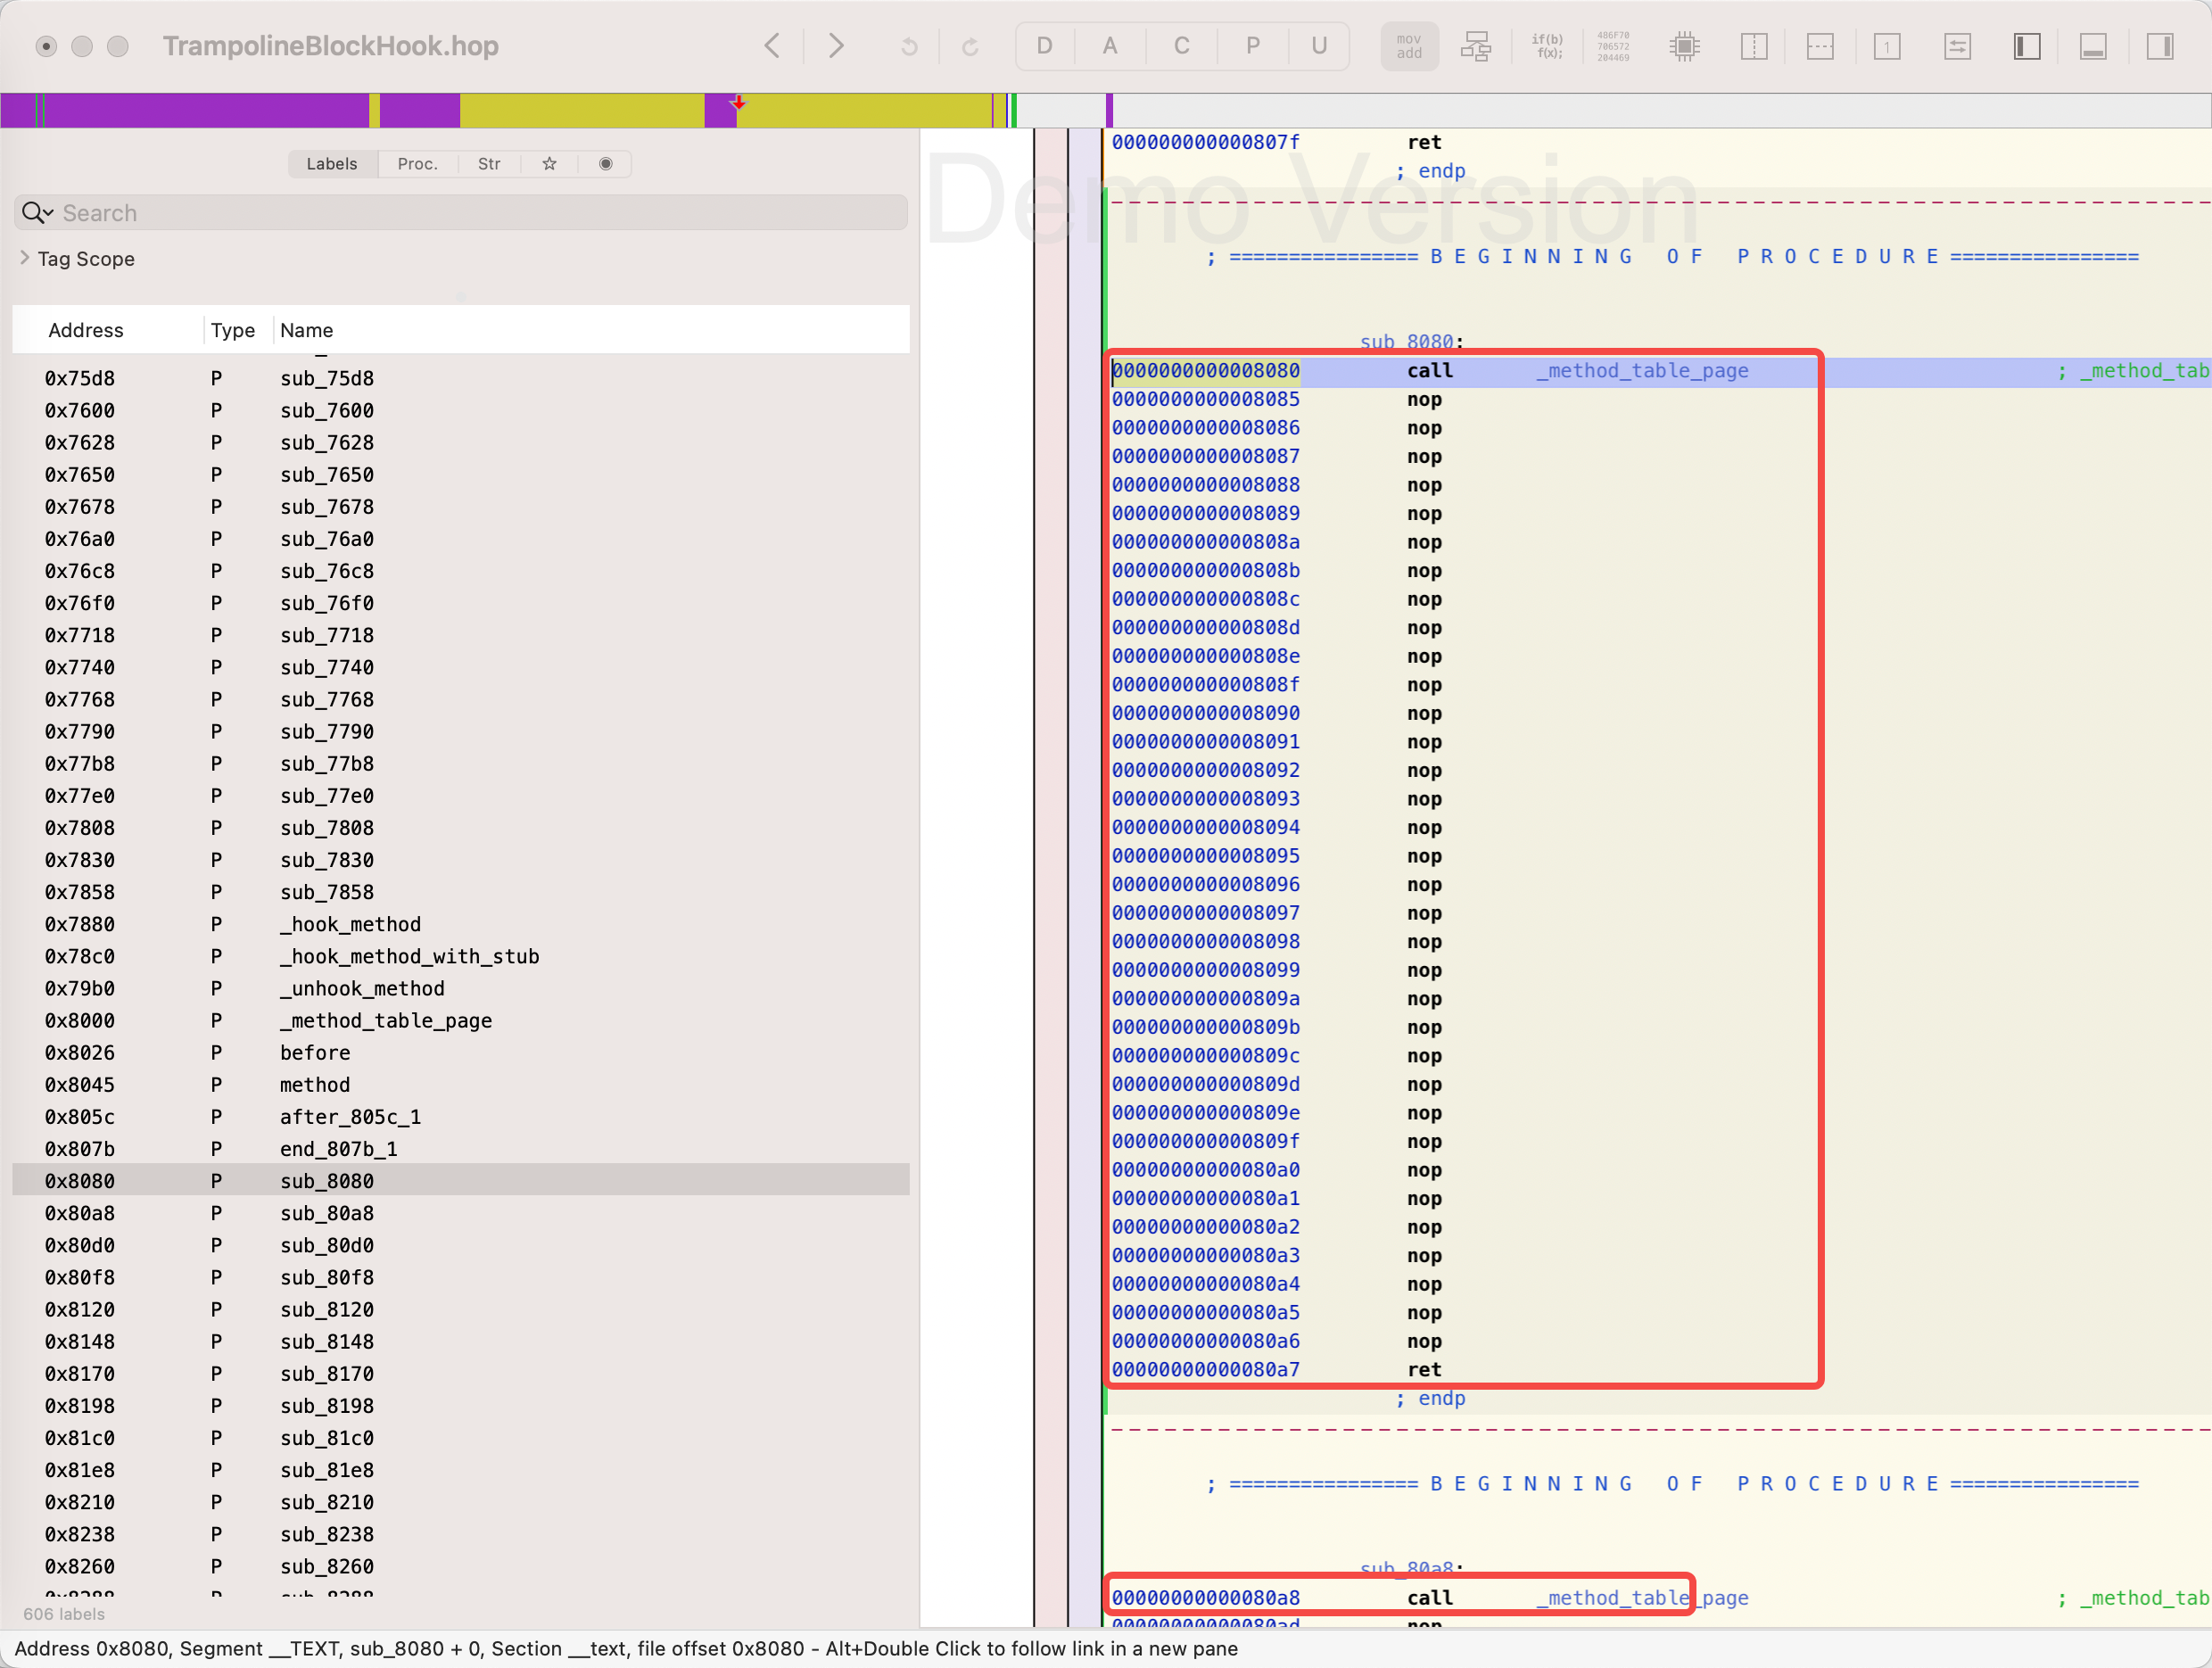
栈的对齐问题(坑点)
如图,在调试过程中,x86_64 经常会崩溃到 SSE
指令,例如 movaps 指令,十分诡异
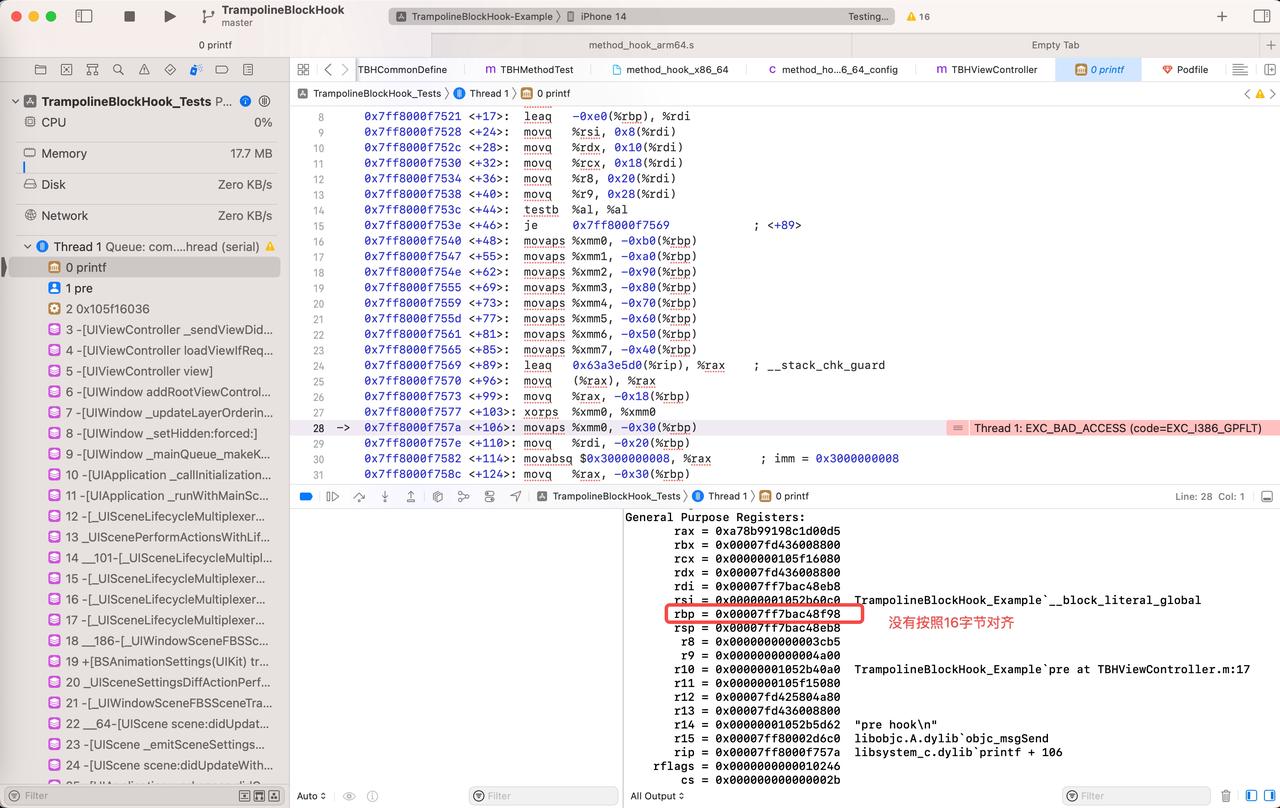
通过排查最终定位到是栈的字节对齐问题,在文档 https://jyywiki.cn/pages/OS/manuals/sysv-abi.pdf 有提到:
The end of the input argument area shall be aligned on a 16 (32 or 64, if __m256 or __m512 is passed on stack) byte boundary. In other words, the value (%rsp + 8) is always a multiple of 16 (32 or 64) when control is transferred to the function entry point. The stack pointer, %rsp, always points to the end of the latest allocated stack frame.
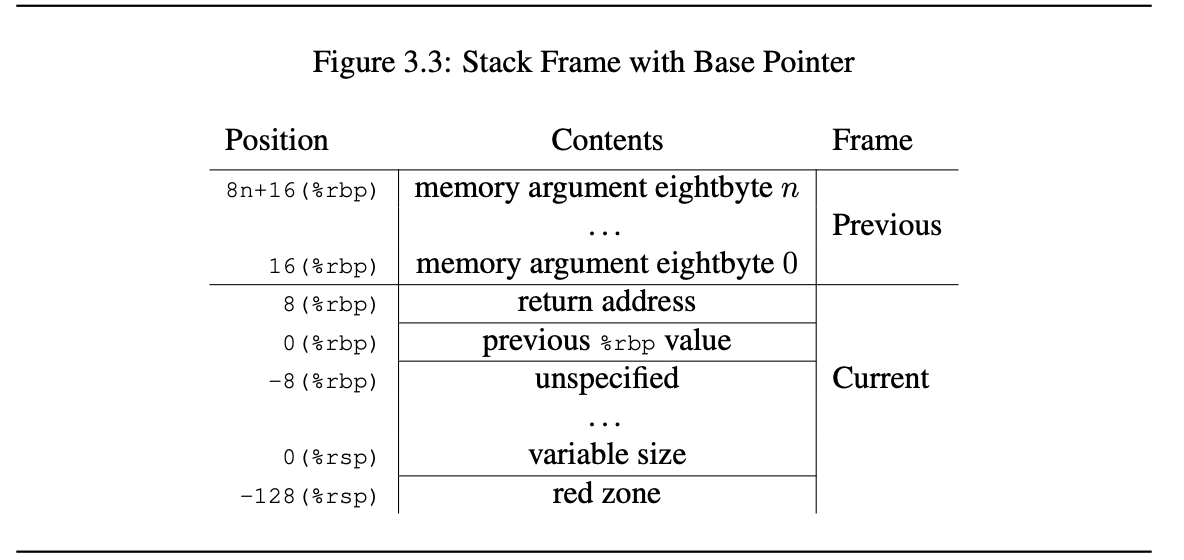
System V AMD64 调用约定要求栈必须按 16
字节对齐,也就是说,在调用 call 指令之前,%rsp
指针必须是16 的倍数(对应 16
进制是最后1位是0)。按 16
字节对齐的原因是,现代x86_64 计算机引入了 SSE
和 AVX 指令,这些指令支持
SIMD,能极大提升处理速度。但是这些指令要求必须从
16
字节的整数倍的地址处取数据,为了顾及这些指令,才有了上述对齐要求。
回到上述崩溃点,打印一下寄存器的值,发现 movaps
指令涉及到的 rbp
寄存器的值为:0x7ff7bac48f98,没有按照 16
字节对齐,偏移 -0x30,仍然不会按照 16
字节对齐。通过进一步排查发现是由于保存 caller-save
寄存器的时候,入栈了奇数个寄存器,导致栈的地址没有按照 16
字节对齐。
1 | save_register |
解决方案也很简单,再压入1个寄存器,把第10行重复1次即可。
1 | save_register |
为什么没有保存和恢复xmm0~xmm7?
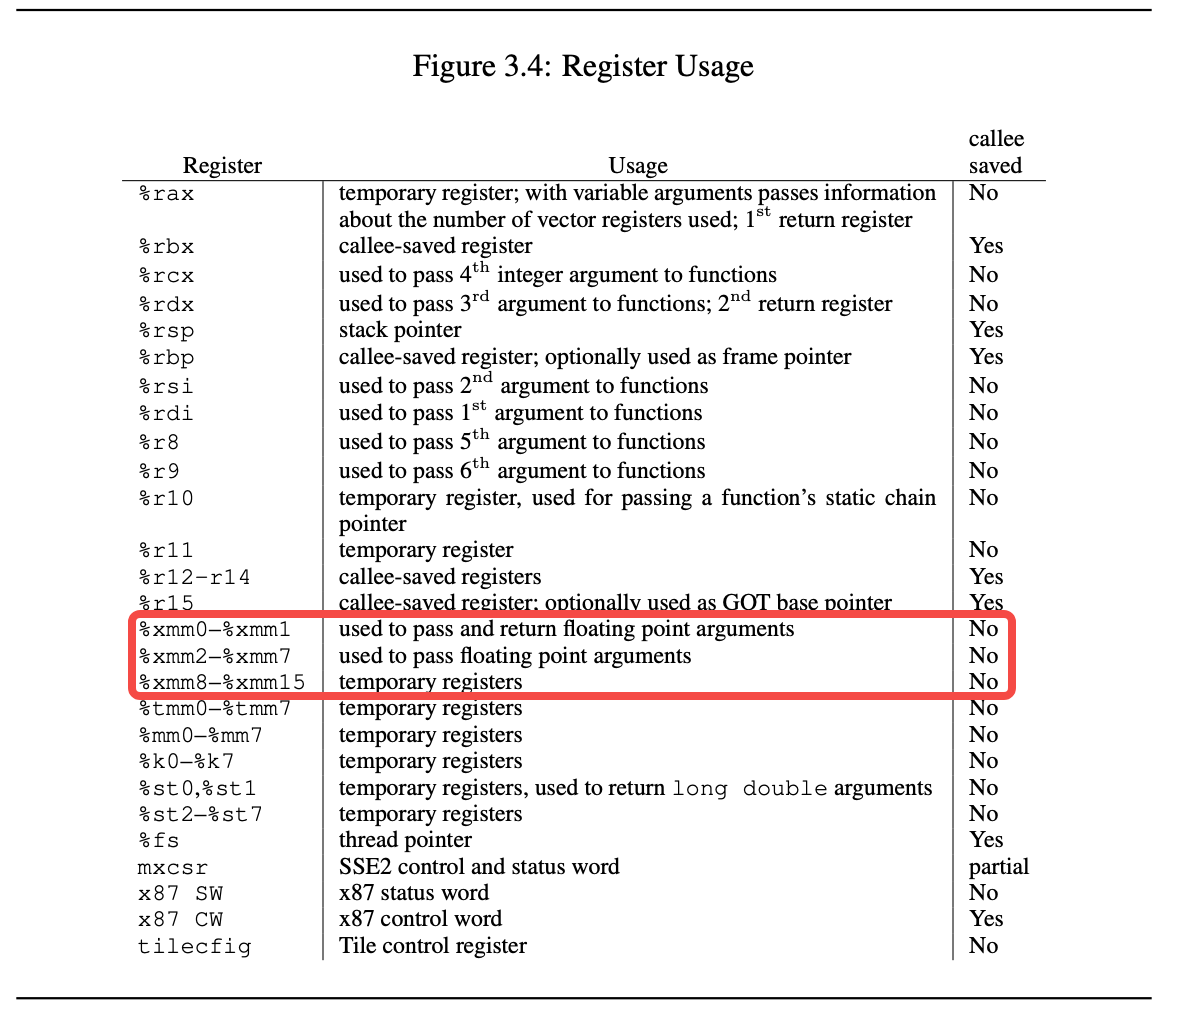
仔细的同学会发现x86_64汇编并没有保存浮点寄存器,目前的现状是在xcode中提示语法不支持,暂时还没有找到好的办法。
思考
TrampolineHook 中心化重定向机制可以用来做很多事情:
- 例如苹果自身的
imp_implementationWithBlock就是基于该技术实现的, - 比如苹果著名的
MainThreadChecker也用了类似的技术。
本文实现的 TrampolineBlockHook 相当于在
Block 的前后做了 2
个函数插桩:pre 和 post,围绕这 2
个插桩可以做很多事情,之后也将围绕这些方向点展开应用:
- 统计
Block的耗时 - 给
Block添加日志 - 埋点统计等
同时,TrampolineBlockHook
现在也还存在着一些问题,例如多线程问题、例如还没有经过大项目的实践,这些也都需要持续得打磨。
总结
文中聊到的几个中心重定向示例,虽然技术原理不曾相同,但是思想是相通的,而其中最关键的就是在于流转技术的实现。本文也是在实践TrampolineBlockHook
的时候有感而发,潦草落笔。另外在支持 x86_64
架构的时候的确碰到了比较严重的崩溃问题,走了不少弯路,正好也借此文档做个笔记。
参考链接
- x86_64架构下的函数调用及栈帧原理
- x86_64汇编之四:函数调用、调用约定
- GCC汇编语法与Intel汇编语法的几个差异点
- x86-64 下函数调用及栈帧原理
- 静态拦截iOS对象方法调用的简易实现
- 浅谈ARM64汇编
- 基于桥的全量方法 Hook 方案(2) - 全新升级
- 基于桥的全量方法 Hook 方案(3)- TrampolineHook
- 为什么使用汇编可以 Hook objectivec_msgSend(上)- 汇编基础
- 为什么使用汇编可以 Hook objc_msgSend(下)- 实现与分析
- x86_64 Linux 运行时栈的字节对齐
- https://github.com/g0dA/linuxStack/
- https://github.com/bang590/JSPatch/wiki/
- http://seanchense.github.io/2019/12/04/block-flags/
- https://clang.llvm.org/docs/Block-ABI-Apple.html
- Guide to x86-64
- https://juejin.cn/post/6844904098580398087
- https://blog.csdn.net/Desgard_Duan/article/details/107829106
- https://nickdesaulniers.github.io/blog/2014/04/18/lets-write-some-x86-64/
- https://evian-zhang.github.io/index.html
- https://en.wikipedia.org/wiki/X86_calling_conventions#System_V_AMD64_ABI
- https://juejin.cn/post/6988867705637961742
- https://satanwoo.github.io/2017/04/23/ARM64IndirectReturn/
- https://landonf.org/code/objc/imp_implementationWithBlock.20110413.html
- https://opensource.apple.com/source/libclosure/
- https://docs.oracle.com/cd/E19120-01/open.solaris/817-5477/eojde/index.html

