背景
业务最近有朗读LaTex公式的需求,而TTS引擎目前并不支持对LaTeX语法的理解,如果直接把LaTeX文本输入给TTS引擎,会出现较多的朗读错误。
经过调研,目前市面上已有的方案有:
这两种方案虽然开源,但是不支持中文,组装规则和中文差异比较大;均为非
Native 方案,性能比较差;
因此决定将LaTeX文本投喂给TTS引擎之前做一层转换:解析LaTeX语法,构建语法树,将LaTeX的原始文本转换为可供TTS引擎朗读的自然语言文本,最后将自然语言文本输入给TTS引擎。由于
LaTeX
渲染引擎已经做了语法解析的工作,语法树是现成的,那么所要做的工作就是基于已有的语法树,在树上面的各个节点中按照规则进行组装。由于
LaTeX涉及命令和符号众多,所以工作量会比较大,本文将结合数学和化学两个学科描述其实现原理,以及在实践过程中碰到的一些难点。
本文涉及到的所有的 LaTeX 朗读逻辑只针对中文
目前效果
视频中有语音朗读
实现原理
架构图
熟悉LaTeX的同学会了解到:LaTeX原始文本经过解析会生成一个
Atom 多叉树,然后基于 Atom 多叉树会递归生成
Box 多叉树,而 Box
会根据坐标位置,使用平台无关接口 Graphics2D 进行绘制。由于
TTS 朗读不涉及渲染逻辑,所以只需要在 Atom
多叉树的节点上进行组装,生成 TTS
朗读所需的自然语言文本,在这个生成过程中,可能需要构建一些生成规则,也需要构建一些数据表。由于
TTS
文本的整个生成逻辑都是平台无关的,所以这部分逻辑是跨端的,可以同时为多端复用。
语法树节点
由于Atom节点也是可以递归嵌套的,那么组装过程也是递归嵌套的。这意味着每个Atom的子类都需要去实现这个接口。
接口定义
1 | class Atom : public std::enable_shared_from_this<Atom> { |
接口实现
以 \sqrt[3]{(x-y)^3}=x-y 为例,其生成的 Atom
多叉树如下所示:
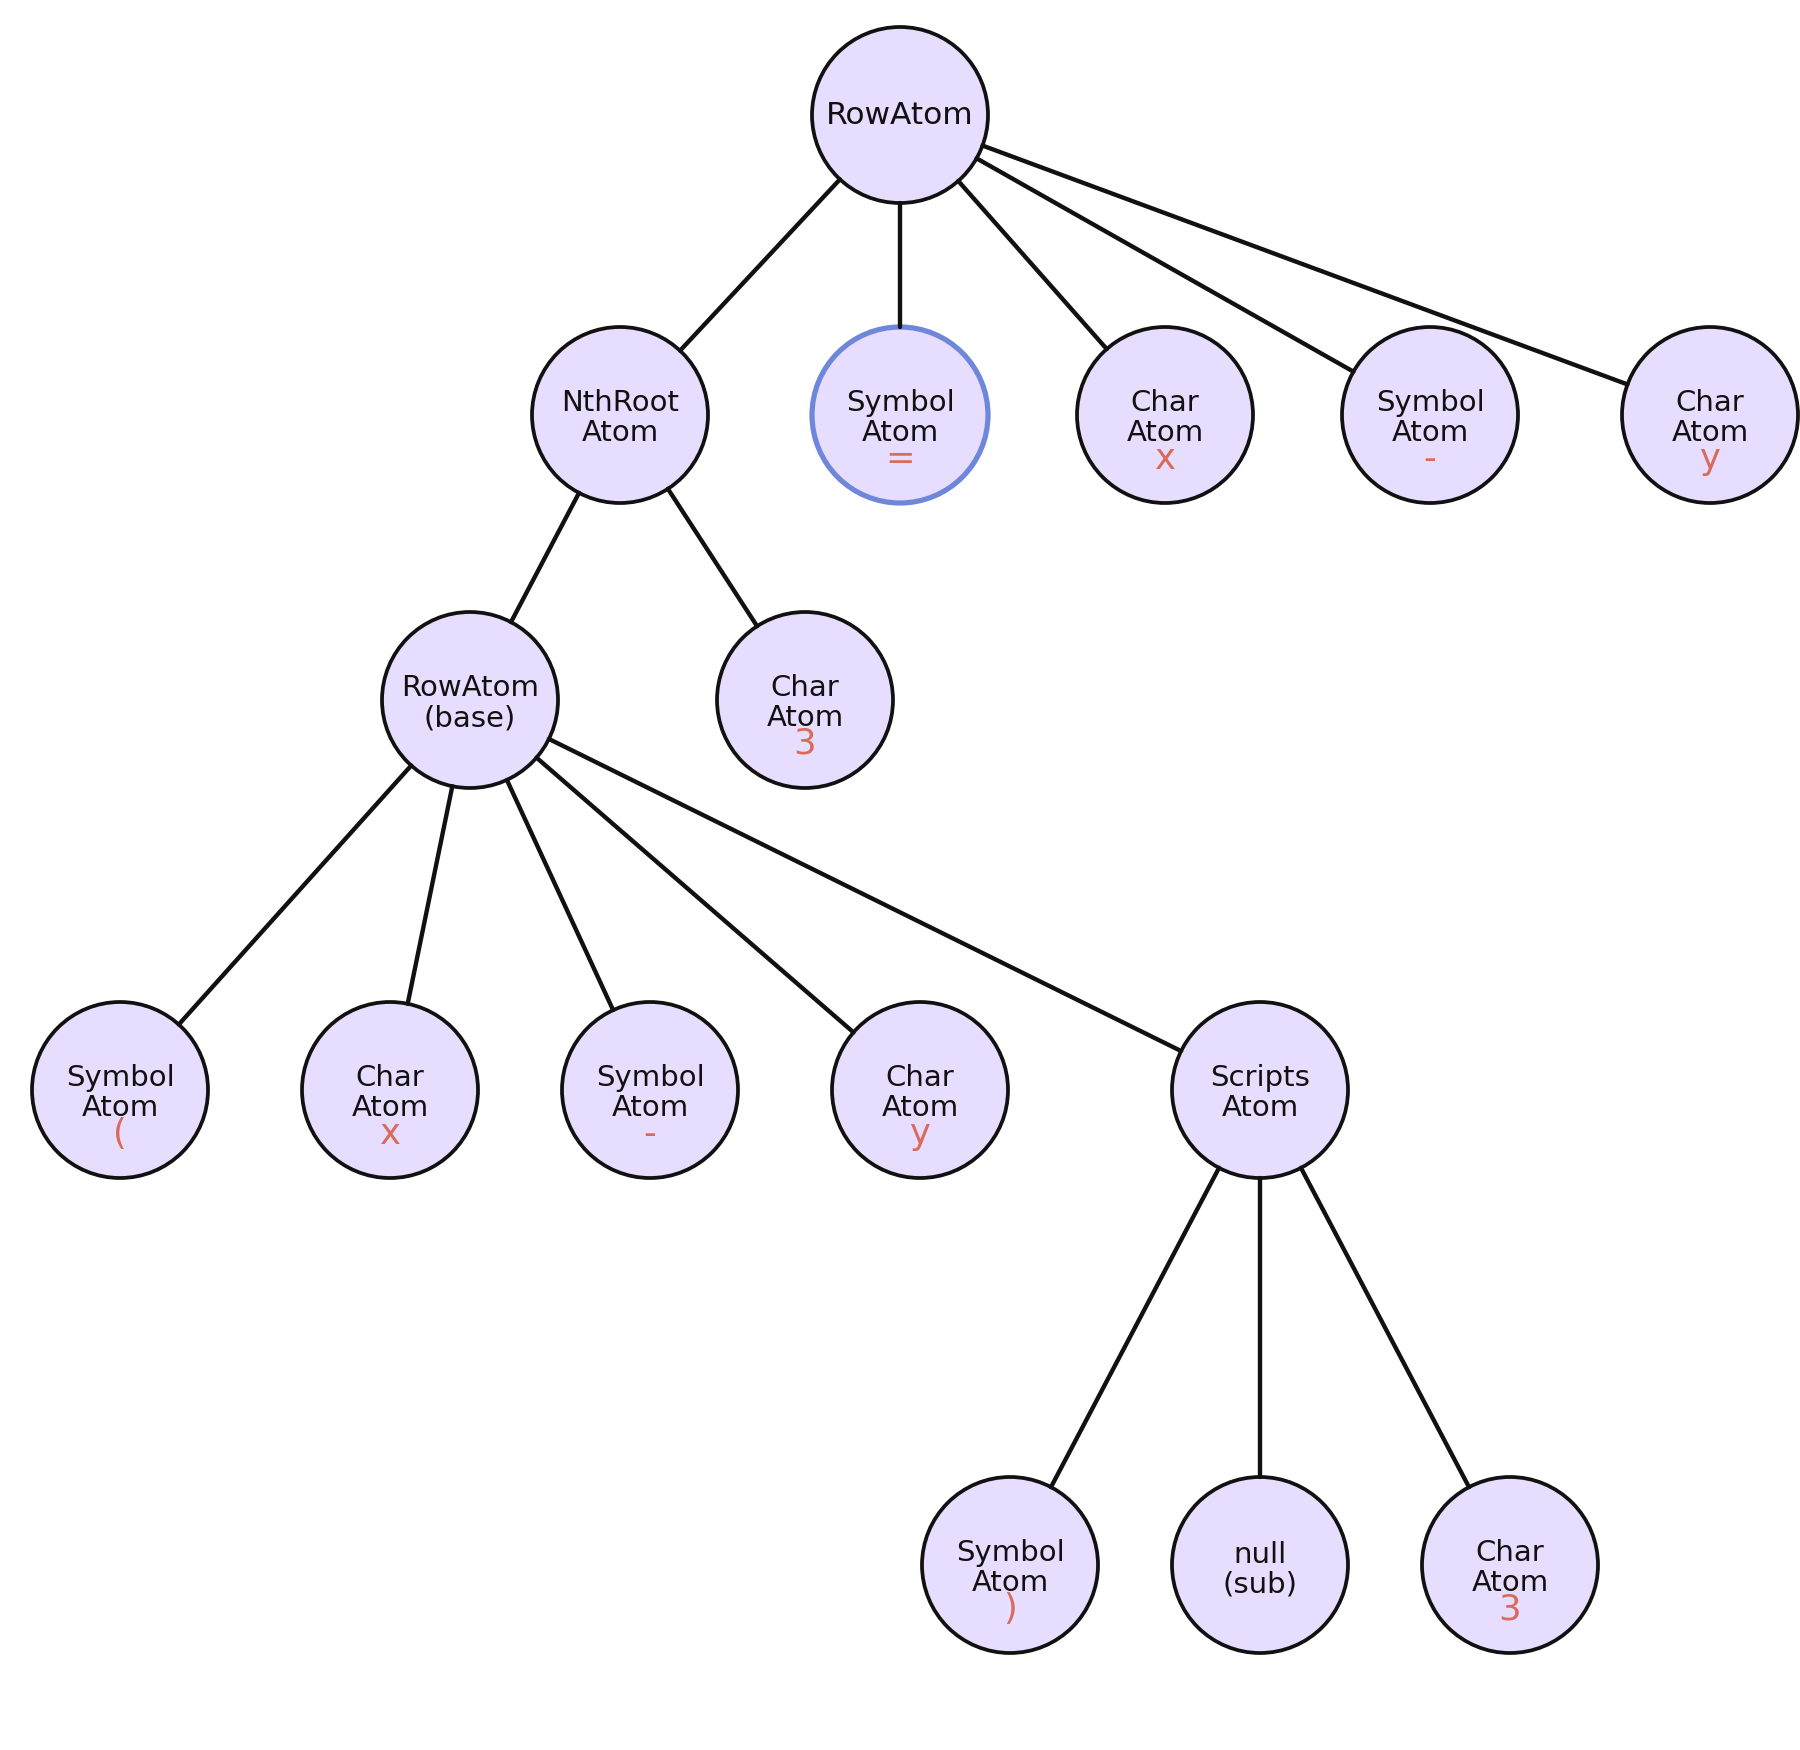
那么这里面涉及到 5 种 Atom
子类都需要去实现getSpeechText接口,下面的示例将看到一些简单的组装规则。
- NthRootAtom
1 | std::wstring NthRootAtom::getSpeechText() { |
- ScriptsAtom
1 | std::wstring ScriptsAtom::getSpeechText() { |
- CharAtom
1 | std::wstring CharAtom::getSpeechText() { |
- SymbolAtom
1 | std::wstring SymbolAtom::getSpeechText() { |
- RowAtom
1 | std::wstring RowAtom::getSpeechText() { |
在这些节点都实现了getSpeechText接口的基础上,就可以按照先序遍历的方式遍历节点树,组装出最终的TTS文本:
1 | 括号 x减 y括号 的立方的立方根 等于 x减 y |
数学规则
Unicode
LaTeX中有大量表达数学符号的unicode符号,其中有很多TTS引擎是无法识别的,因此可以维护一张专用的哈希表来翻译unicode值的读法
1 | static std::unordered_map<wchar_t, std::wstring> unicodeMap = { |
专用符号
LaTeX中有大量表达数学符号的专用表达,TTS引擎也是无法识别的或者说可以识别但是发音不准确的,同样维护了一张专用的哈希表来翻译这些专用符号的读法
1 | static std::unordered_map<std::wstring, std::wstring> speechMap = { |
命令组合
有的时候会出现这样的情况,需要结合前后两个命令,才能绘制出正确的结果和获取到正确的TTS文本,例如
1 | \root{A} \of{B} |
最后的渲染结果为
其TTS文本为 “B的A次方跟”。
在解析root的时候,并不知道后面还有of,所以根据解析规则,会前后生成2个命令:CommandRoot和CommandOf,并且各自有对应的参数。然而因为这是一个组合命令,二者结合才能渲染出正确的结果。此时就需要CommandOf在初始化的时候,试探性地检测上一个命令,如果是CommandRoot,那么就需要窃取CommandRoot的参数,并忽略掉CommandRoot命令。最后CommandOf会根据最后获取到的所有参数正确地生成NthRootAtom。
1 | bool CommandOf::init(const std::shared_ptr<TeXParser>& tp) { |
同时,也可以很便捷地组合出其TTS文本。
推理提前截断
有些符号看起来很简单,例如 \equalparallel 这个命令,其渲染效果如图所示
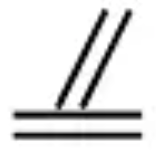
但是其渲染逻辑对应的Atom节点比较复杂:
1 | shared_ptr<Atom> Commands::CommandEqualParallel::newI(const std::shared_ptr<TeXParser> &tp) { |
如代码所示,如果从最后的结果TypedAtom节点上推断出它的TTS文本为“平行且等于”,十分困难。针对这个问题,引擎定义了一个特殊的节点,ContainAtom,从命令开始就截取到名字,同时它不会影响原先的渲染逻辑。在getSpeechText方法中直接返回名字即可,无需推断过程。
1 | class ContainerAtom : public Atom { |
那么上述代码可以改造为:
1 | shared_ptr<Atom> Commands::CommandEqualParallel::newI(const std::shared_ptr<TeXParser> &tp) { |
参数窃取的艺术
1 | 37^\circ\rm{C} |
这个latex文本的最终渲染效果是:
对于渲染逻辑来说,实际上非常简单,挨着绘制3个节点即可(如栈所示),然而要推理TTS文本却比较麻烦,问题在于他们不在一颗节点上。如图所示,在LaTeX文本解析的过程中,实际上会生成一个“命令栈”,正常情况下这些命令正常出栈即可,然而此时由于命令和命令之间有一些关联关系,需要做一些特殊处理:
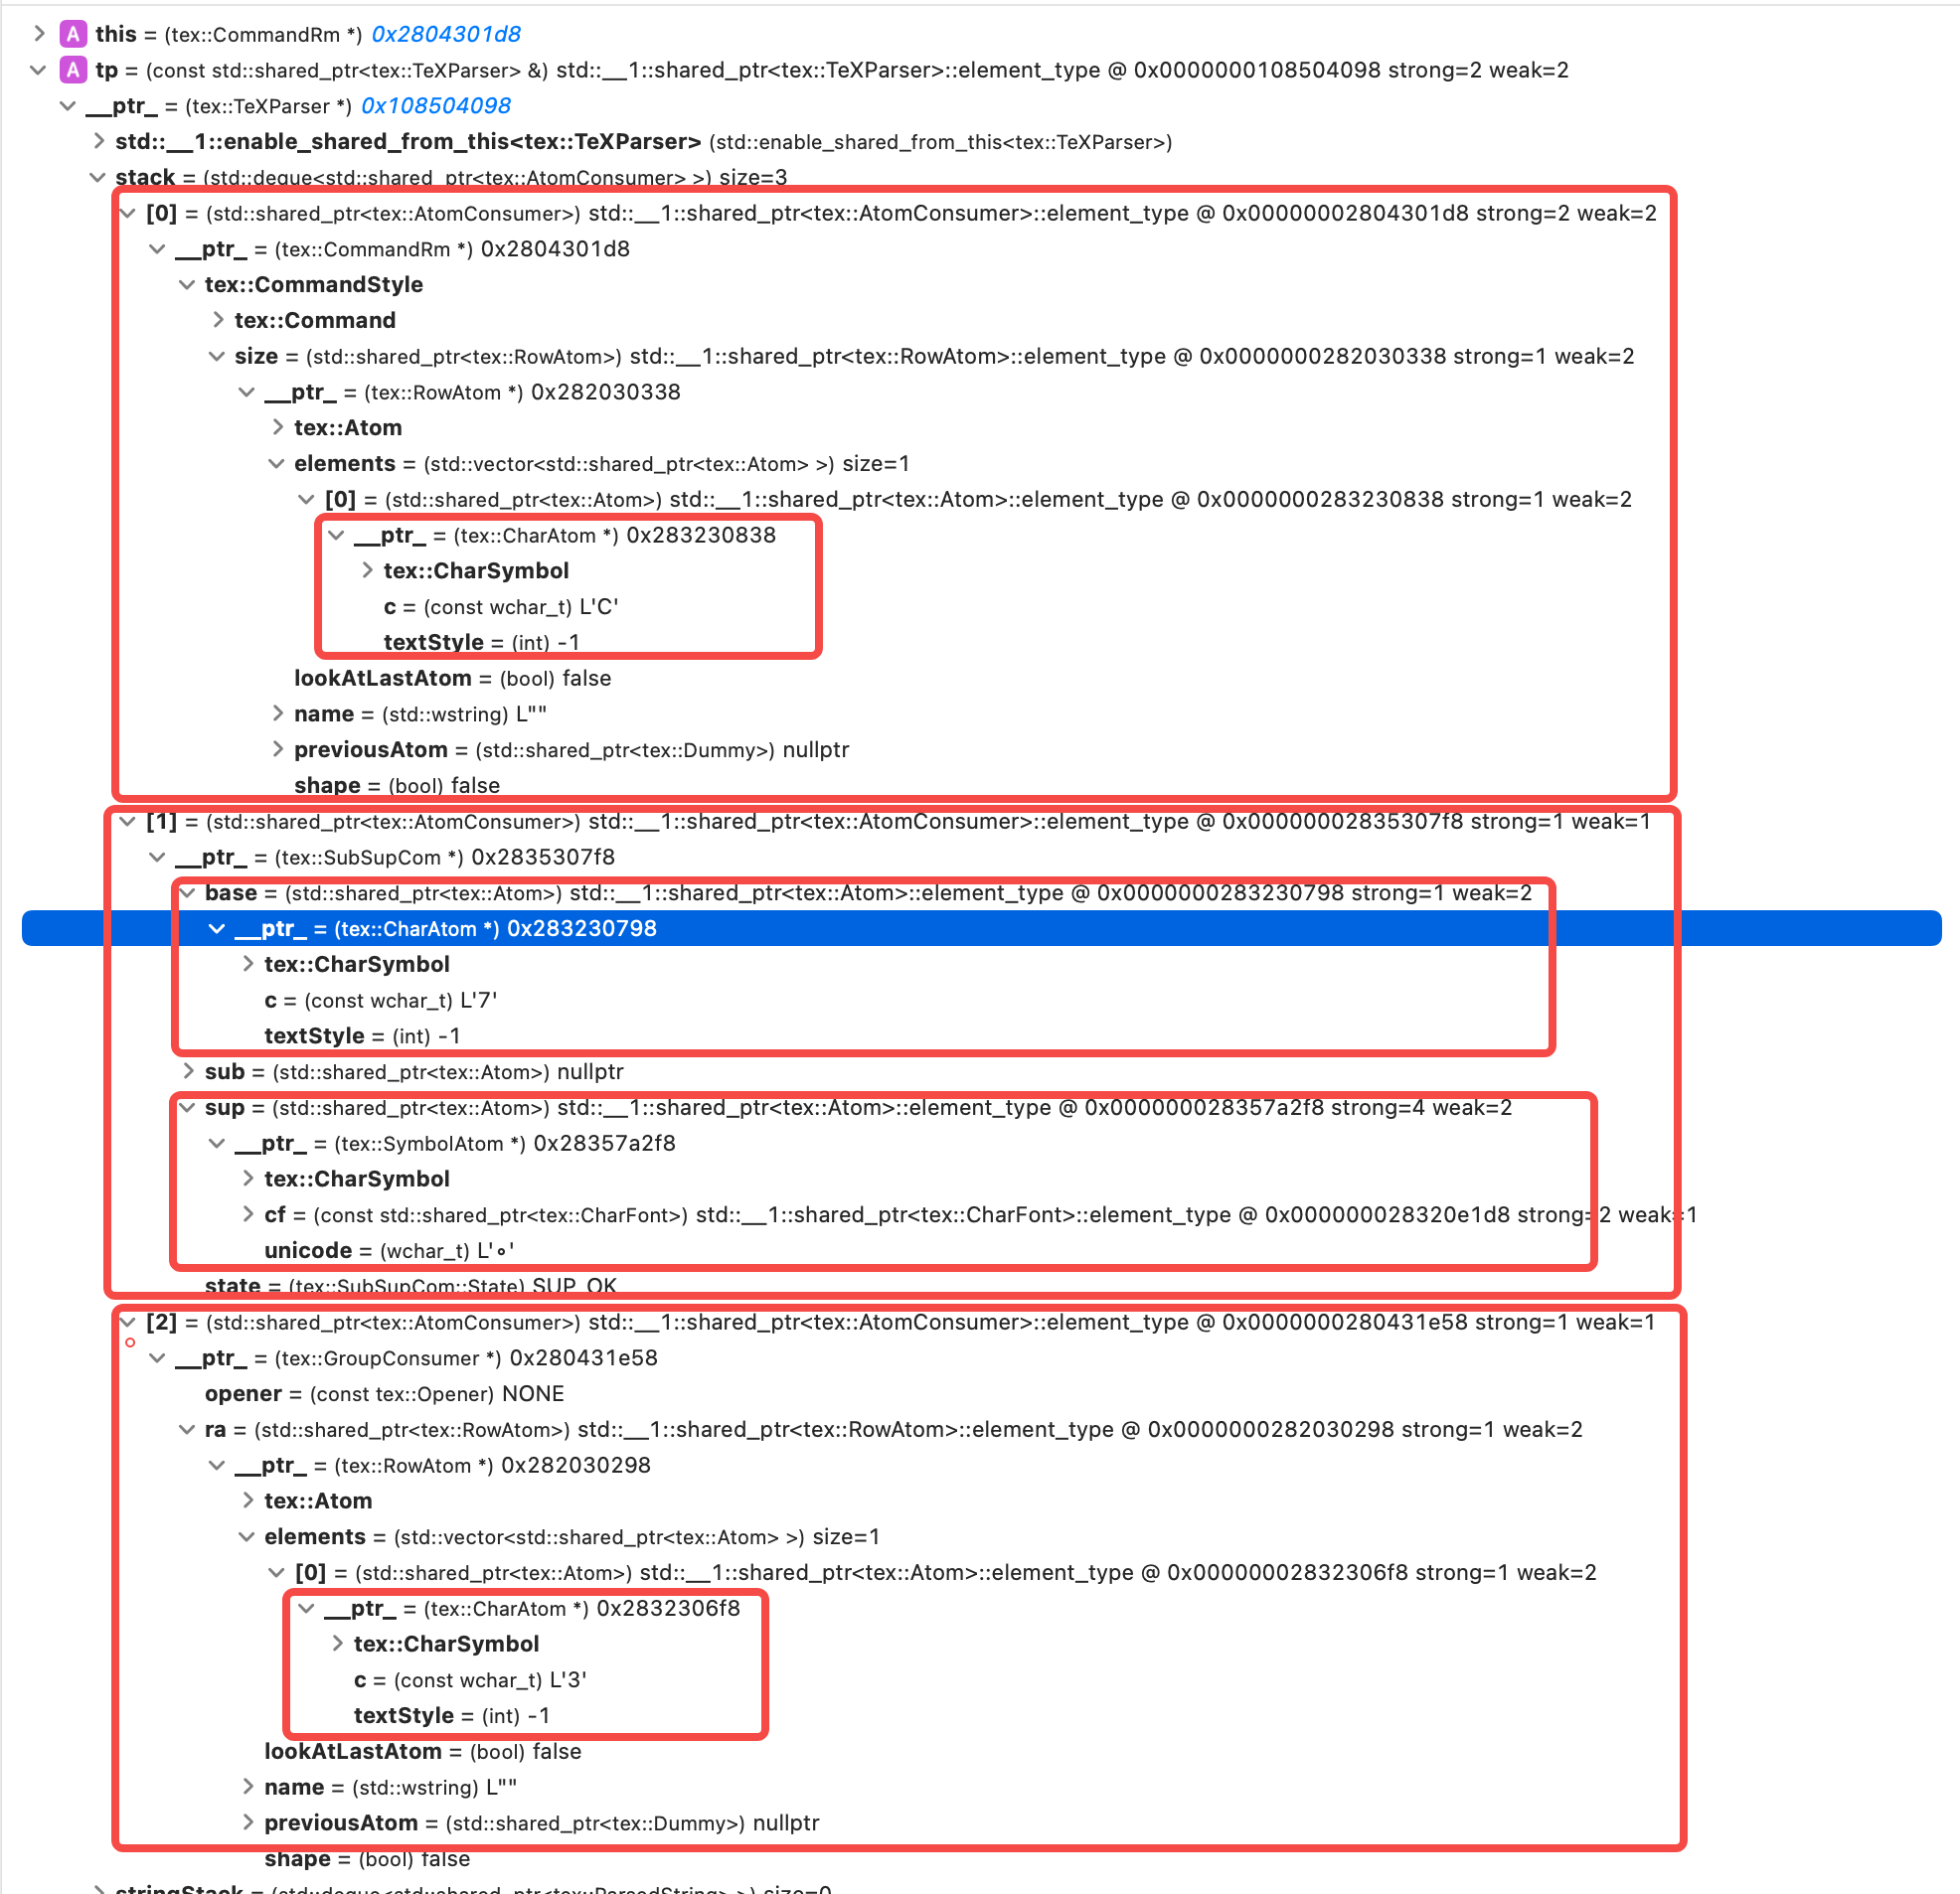
在CommandRm进行闭合的时候,做一些判定。
- 先把栈顶的
CommandRm出栈,同时要判定当前的CommandRm的内容为C; - 继续判定当前栈顶的命令类型是否为
SubSupCom,并且其sub为空,sup为°; - 1和2都满足的前提下,将
SubSupCom的sup窃取过来,并结合当前的内容C,一起生成一个新的SubSupCom,并将其放置于ContainerAtom中,命名为“摄氏度”; - 如果1或者2不满足,走正常的出栈逻辑
1 | bool CommandRm::close(const std::shared_ptr<TeXParser>& tp) { |
入栈出栈规则
标准的绝对值表示方式是这样的,因为很容易判断左右,所以生成一个绝对值的节点也比较简单
1 | \lvert xxx \rvert |
然而有的情况下,Latex会直接用“|”来表达绝对值
1 | |a-1|=0 |
由于无法区分左右,因此需要通过入栈出栈的方式来判定是否是绝对值,并将绝对值里面的内容进行聚合,最终生成一个FencedAtom节点
1 | std::vector<std::shared_ptr<Atom>> RowAtom::getElementsByAggregatingABSSymbols() { |
而FencedAtom节点TTS文本的生成逻辑如下所示:
1 | std::wstring FencedAtom::getSpeechText() { |
从中也可以看出,
|xxx|除了表达绝对值,还可以表达“模”和“行列式”
二义性读法
有些符号在不同的场景下有不同的读法,因此需要做一些判定。
负 or 减?
-,在-b中应该读作“负”,(-b)中也应该读“负”,而在a-b中应该读作“减”,规则如下:
- 如果前一个符号为空,读“负”;
- 如果前一个符号的类型为
SymbolAtom- 如果其内容为(、[,读“负”;
- 否则读“减”;
- 剩下的读“减”;
和 - 类似的符号还有如下符号,就不再详细展开:
- ±,也存在加减和正负的歧义读法
- +,存在正和加的歧义读法
点 or 乘以 or 点乘
·,有的情况下应该读“点”,有的情况下应该读“乘以”,还有的情况都“点乘”,规则如下:
- 如果前面的符号或者后面的符号为空,读“点”;
- 如果前后的符号同时为向量,读“点乘”;
- 剩下的读“乘以”;
实际上
·还可以组合,形成不同的读法,例如···表达省略号或者余数。
隐形符号
有的情况下,有些符号是缺失的,但是TTS文本还必须把它们包含进来。
以乘号为例,例如(a+b)(c+d),或者2(a+b)中间必须加一个“乘以”,才符合朗读习惯。规则如下:
- 如果当前符号是FencedAtom,且内容为(xxx)的形式
- 如果上一个符号是CharAtom,补充“乘以”;
- 如果前一个符号是FencedAtom,且内容为(xxxhe)的形式,补充“乘以”;
- 不做处理;
- 不做处理;
假分数
有些符号,虽然逻辑上应该是一个整体,但是渲染上是可以独立的,例如假分数:latex
文本为“3\frac{1}{2}”。渲染引擎会解析成前后两个Atom,一个CharAtom,表示3,另一个FracAtom,表示1/2,对于渲染来说,他们之间无需有什么瓜葛,只需要依次绘制即可,因为渲染只需要表形。而对于TTS文本,他们之间是有语义关联的,因此如果当前Atom为FracAtom,需要结合前一个Atom进行结合判定是否有可能组成假分数。
发音不准
在测试过程中,会有一些发音不准的情况,那么此时可以借助 TTS 引擎的 SSML技术 来纠正发音
1 | // a和A |
化学规则
化学的TTS读法和数学完全不同,这是因为化学涉及到一些化学式学名、化学方程式、离子等的识别,基本上无法复用已有的树形遍历规则。这意味着为了实现化学的TTS能力,需要构建一套完全不同于数学的框架。
树结构局部打平
考虑下面的化学式:
1 | \ce{H2SO4} |
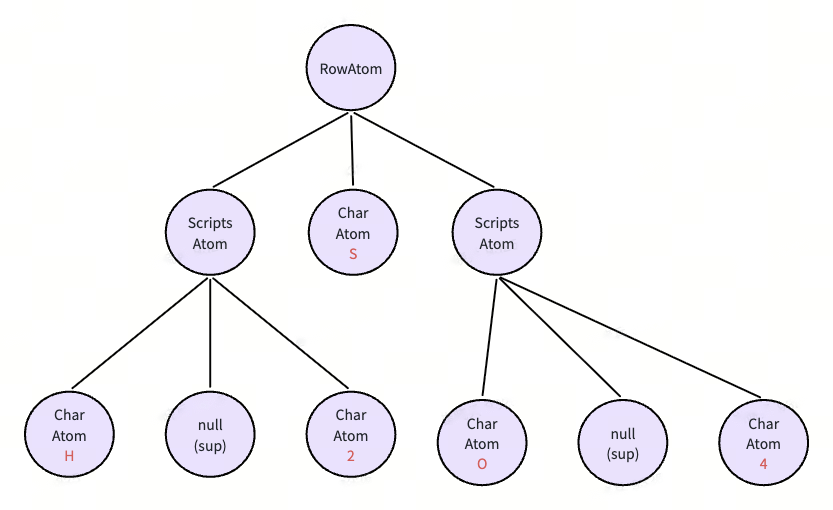
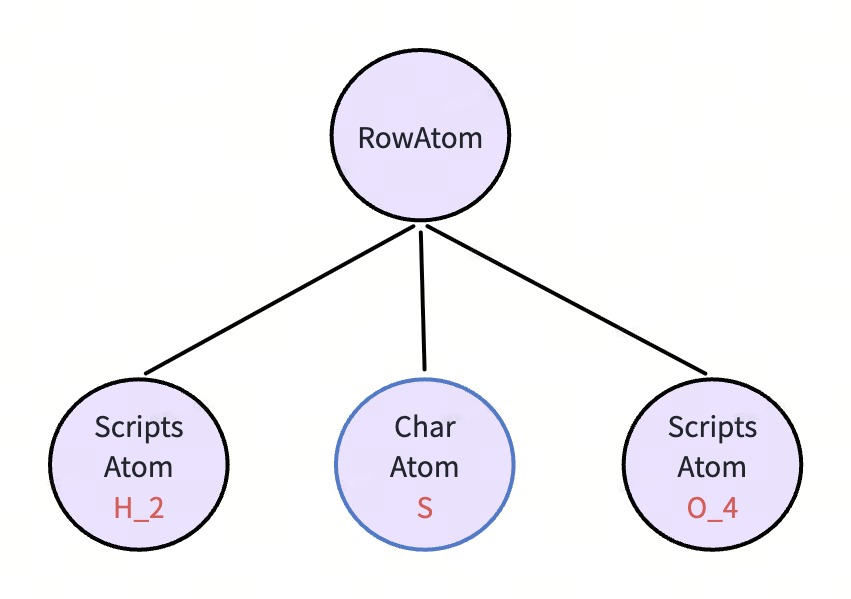
其生成的节点树如图所示,如果还是按照前文的树形遍历方法来读,很难将其与“硫酸”这个名字关联起来,这个矛盾也主要来自于树形结构和线性拆分查找之间的天然冲突。考虑到大部分化学的结构都比较扁平,大部分分子式的层次并不会特别深(这里面以ScriptsAtom居多,用于表达化学式的右下角标),所以可以考虑局部打平树结构,即在读ScriptsAtom的时候,不再去遍历其子节点,而是按照某种规则将其抹平为一层。
具体规则如下,由于ScriptsAtom有base、subscript和superscript
3个元素,其打平规则如下:将每个元素转成字符串,然后下角标前面添加_,上角标前面添加^,最后拼接到一起
1 | class ScriptsAtom : public Atom, public HasTrueBase { |
在这样的规则下,前面的树结构被打平为如下图所示:
化学式的识别
在打平的基础上,遍历上述化学式的TTS文本结果依次为H_2、S、O_4,如何将这几个散装的文本转换为化学式的学名呢?字典映射可能是一种方式,但是仔细考虑会发现有很多问题无法解决:
- 在遍历的时候,如何确定H_2SO_4就是一个组呢?
- 又如何来确定H_2SO_4就有对应的化学学名呢?
- 如果没有学名,又如何回退呢?(毕竟H_2S也有对应的学名硫化氢)
如果再仔细考虑下,会发现这里的问题和搜索引擎高度相似:当你输入某些字符的时候,搜索引擎就能展示一系列的联想词语。
因此可以参考搜索引擎的做法,引入Trie树,来解决化学式学名的识别问题
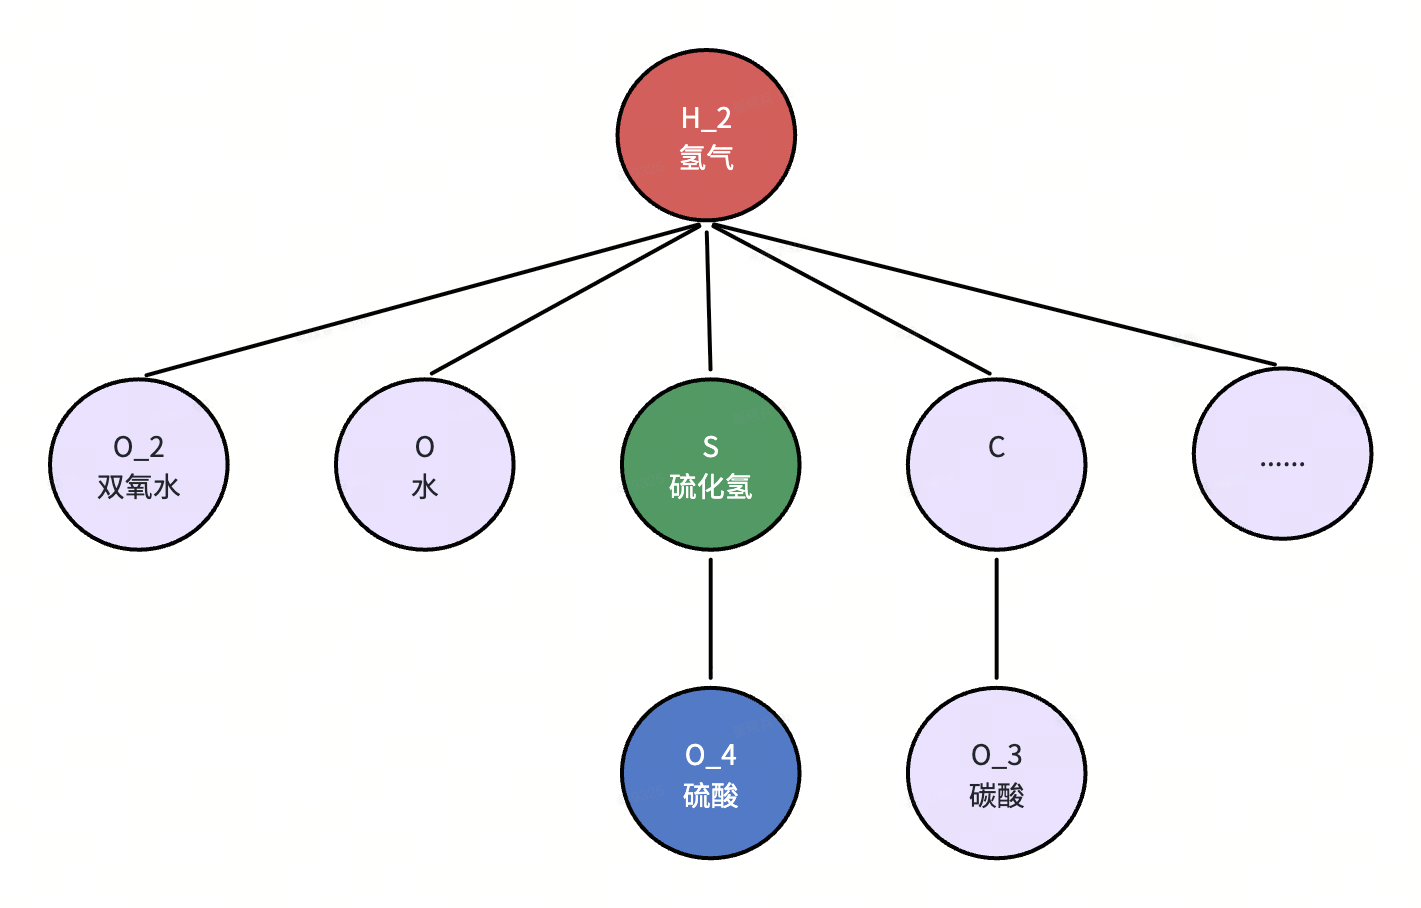
如图所示,这是构建的化学式学名的Trie树,每个节点都存储着一个名字(如果有的话),用来表达从根节点到当前节点的路径代表的化学式。而搜索过程采用贪婪的搜索算法:
- 当输入H_2,来到了红色节点,因为有学名,记录下学名“氢气”;
- 当继续输入S,来到了绿色节点,同样有学名,覆盖学名为“硫化氢”;
- 当继续输入O_4,来到了蓝色节点,同样有学名,覆盖学名为“硫酸”;
至此搜索完毕,最后获取到的化学式学名为“硫酸”,核心代码如下所示
1 | std::wstring ChemTTSEngine::getSpeechText(const std::shared_ptr<RowAtom> &atom) { |
化学式数据表的构建
由于涉及到化学式学名的识别逻辑,所以自然需要建设一套化学式学名数据库。
参考 Wikipedia 构建了一些数据表,预计最终的规模应该在3000~4000,甚至更多。
数据表中的Key值有一些构建规则:
- 字符和字符之间用 # 隔开;
- 数字和数字之间保持连续;
- 对于ScriptsAtom,下角标添加_前缀,上角标添加^前缀,并且保持一个整体
1 | std::unordered_map<std::wstring, std::wstring>& ChemTTSDatabase::getChemicalNameMap() { |
这个体力活可以交给ChatGPT,教给它一些规则,帮忙构建数据库
化学式数据表的加载
如何构建化学式的Trie树呢?实际上这个构建过程和搜索过程是高度相似的,是Trie树节点的插入生成过程:依次寻找节点,如果没有就创建对应的节点。
1 | struct TrieNode { |
化学方程式的识别
在已经识别化学式的基础上,来进一步来识别化学方程式。相比于化学式,化学方程式包含了以下概念:
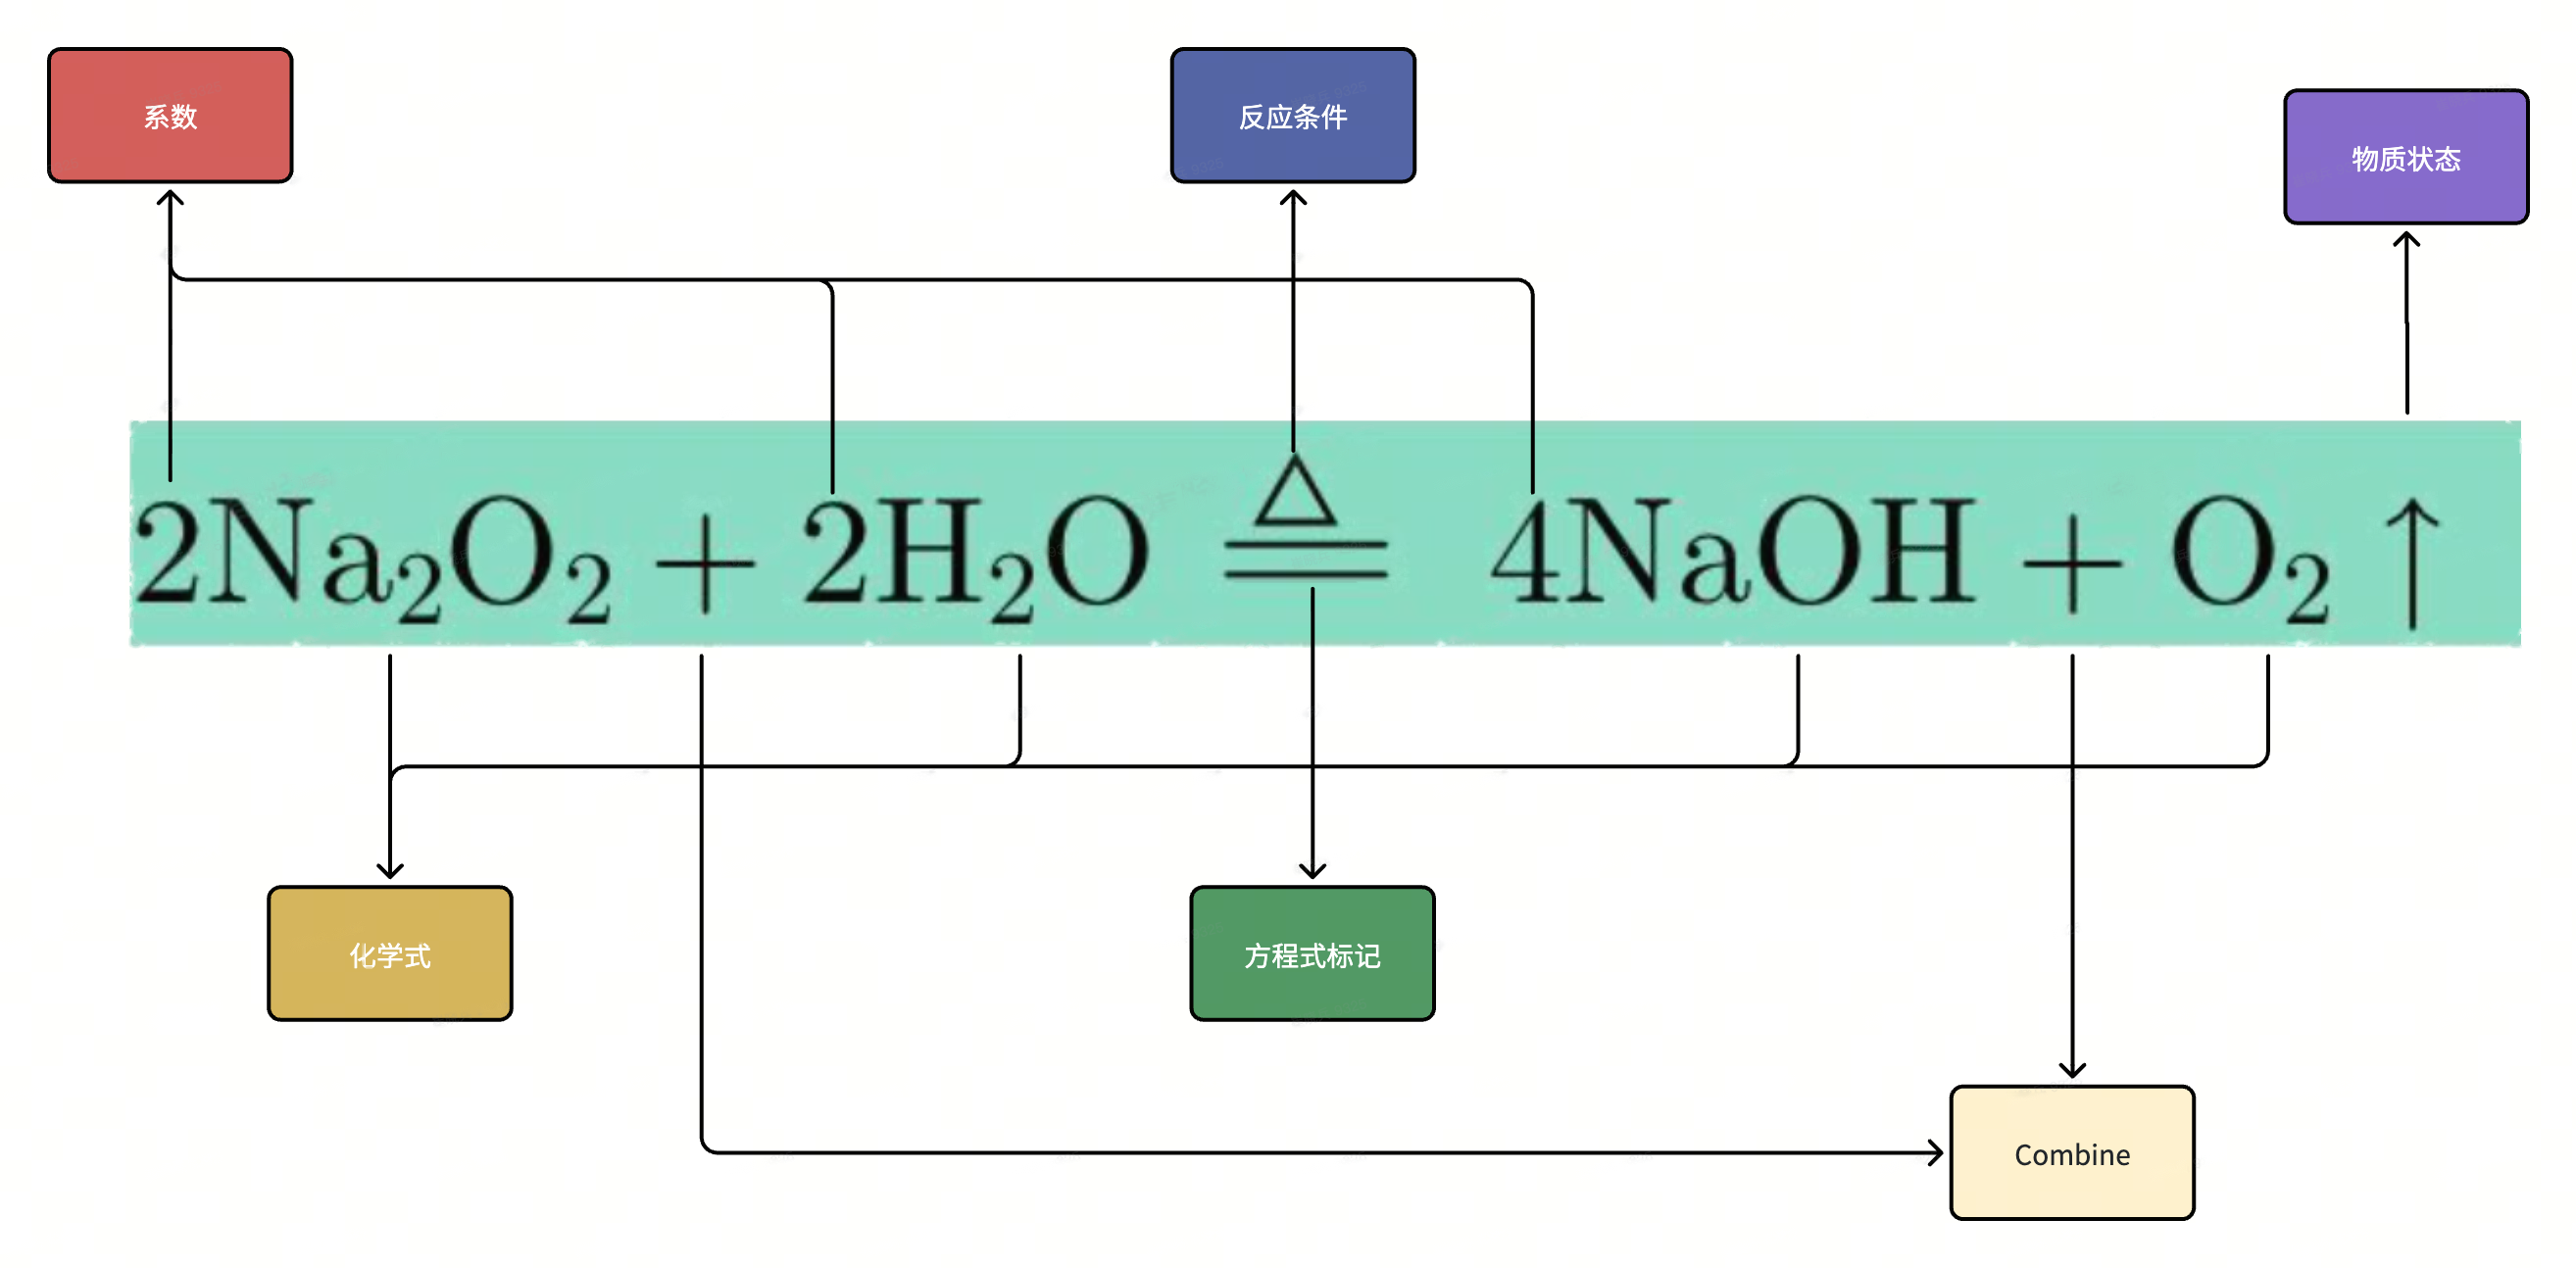
因此定义了以下数据结构,并且把是否有Equation作为是否是化学方程式最根本的判断。
1 | enum class ChemElementType { |
一般情况下将遍历出来的元素入栈,如果碰到XArrowAtom或者XLongequalAtom等,会认为当前是一个化学方程式,那么在出栈的时候,会给没有系数的化学式(默认为1)添加系数。如果不是化学方程式,显然没有必要去添加系数。
核心代码如下所示:
1 | for (int i = 0; i < elements.size(); ++i) { |
上述化学方程式最后的TTS文本输出如下:
1 | 2个过氧化钠和2个水在加热的条件下反应生成4个氢氧化钠和1个氧气气体 |
浓度的读法
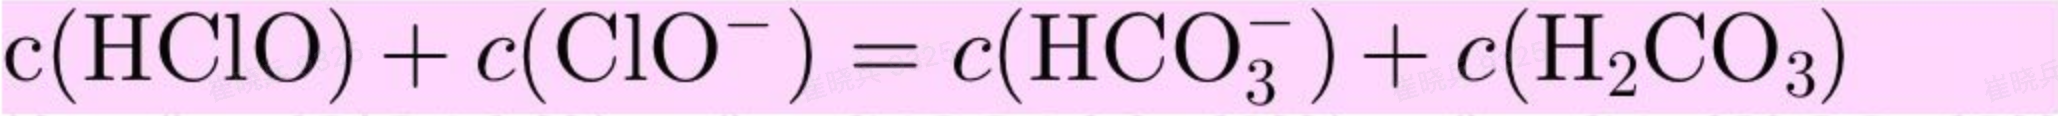
离子浓度的读法不同于化学方程式,中间的等号就是表达等于的意思,所以只需要识别浓度c(xxx)即可,还是采用类似于绝对值的进栈出栈的方式,来判定是否在表达浓度,核心代码如下所示:
1 | std::vector<std::shared_ptr<Atom>> ChemTTSEngine::getElementsByAggregatingMolaritySymbols(const std::vector<std::shared_ptr<Atom>>& elements) { |
读法如下:
1 | 次氯酸的浓度 加 次氯酸根离子的浓度 等于 碳酸氢根离子的浓度 加 碳酸的浓度 |
结晶水合物
化学里面有许多物质在水溶液里析出,形成晶体时常结合一定数目的水分子,这样的水分子叫结晶水合物。他们的读法都是“x 水合 y“,x指水的个数,y指·前面的化合物名称,例如:
- CuSO4·5H2O :五水合硫酸铜
- Na2CO3·10H2O :十水合碳酸钠
如果将这些结晶水都存储到表中,会有 2 个问题
- 一个是无法穷举,会产生遗漏;
- 另一个是存在着极大的浪费
如果能提取到结晶水合物里水的个数,那么可以一举两得:只要在数据表中查询出前面的名称,最后的化学名称即可确定。具体思路如下:
遍历 Trie 树的过程中,如果碰到“·”符号,确认后面的物质是否是数字和H2O,或者是H2O,则跳出循环,结合前面遍历出来的化学符号y,组成最终的名称: x 水合 y
1 | for (int i = 0; i < elements.size(); ++i) { |
但是也有一些水土不服的情况,例如
NH3·H2O,如果按照上述规则,最后的名称为“一水合氨气”,会有一些别扭,正确的名称应该是“一水合氨”,针对这种情况,可以考虑加一些白名单来解决:遇到·的时候先查表,查表失败的情况下才走上述逻辑。
1 | {L"N#H_3#·#H_2#O" , L"一水合氨"}, |
总结
冰冻三尺非一日之寒,LaTeX的TTS文本能力绝非一蹴而就,仍然需要较长的人力和时间投入进行持续的打磨

