背景
在ChatGPT火遍天际之际,许多应用程序都试图以聊天机器人的形式接入访问它。由于ChatGPT的回复文本是markdown格式,所以移动端上需要支持markdown语法,调研良久发现:
- 很多方案都是基于
WebView的方式来实现的,这对于移动平台会存在性能不佳的问题; iOS方向的CocoaMarkdown是为数不多的Native渲染库,但是其功能不够全面,且不易扩展;Android方向有一款架构比较优秀的库Markwon,遗憾的是只支持单端。
最终我决定构建一款适合于移动双端接入的跨平台渲染引擎,并命名为Markdown。本文将介绍如何实现一个markdown
跨平台渲染库,如果你对跨平台技术感兴趣的话,那么一起来享受这趟跨平台之旅吧。
为了区分,小写
markdown指语法,大写Markdown指SDK。
简介
基本信息
Markdown 的初步定位是一个动态的、跨平台的、可嵌入的
markdown
渲染库,可以被嵌入到各种平台的应用程序中,它的主要目的是显示
markdown 语法文本,以及嵌入在 markdown
中的一些 html
标签。到目前为止,Markdown已经针对 iOS 和
Android
进行了平台适配,而对其它平台的支持尚未列入规划。
- Git 地址:待提供
支持语法
渲染效果
左边iOS,右边Android
这里是演示视频:
如何使用?
iOS
- Register ImageDownloader
由于markdown中有一些图片需要下载,但这并不是C++引擎所擅长的,所以需要借助于iOS/Android的能力,因此暴露了图片下载器接口ImageDownloaderDelegate,业务接入侧可以实现自己的图片下载器,并调用相关接口注入。
1 | // an example of image downloader |
- Setup the param
1 | MarkdownParam *param = [[MarkdownParam alloc] init]; |
- Build Icon
We strongly recommend you do this step in an asynchronous thread
1 | MarkdownIcon *icon = [MarkdownEngine buildIconWithParam:param]; |
- Create MarkdownView and bind icon to it.
1 | MarkdownView *view = [[MarkdownView alloc] initWithParam:param icon:icon]; |
Android
- Init library
1 | MarkdownInitializer.init(Application.getInstance()) |
- Register imageLoader
1 | // an example of IImageLoader |
- Setup param
1 | val content = "[Markdown语法](https://markdown.com.cn)" |
- Build icon
1 | val iconBuilder = MarkdownIconBuilder(param) |
- Bind icon to MarkdownView
1 | val view = findViewById(R.id.markdownView) |
实现原理
跨平台基石
首先来讨论下跨平台的基石问题:Markdown是一个重渲染的SDK,从根本上无法避免和UI打交道,而C/C++本身并不擅长此类工作,它更擅长的是一些逻辑性的非UI工作。那么为什么可以用C/C++来实现呢?这套跨平台方案之所以可行,就在于
C/C++
层抽象了一系列接口,使得排版和渲染可以摆脱对具体平台的依赖,在
C/C++
层就可以拿着虚拟的画板和画笔,统一完成排版和渲染工作,而双端只需要做好这些接口的适配,在真正排版和绘制前进行绑定即可。
它带来的优势:
- 双端可以保证几乎同样的渲染效果;
- 双端只需要开发和维护一份逻辑代码;
C/C++语言本身四通八达,非常容易扩展到其它平台;
当然它也有自己的劣势:
- 要对
C/C++比较熟悉,但众所周知C/C++是一门不太友好的语言; - 很多东西得摆脱对具体平台的依赖,意味着有些东西不能开箱即用。
架构图
如图所示,Markdown引擎架构主要由平台无关层和平台相关层构成:
蓝色区域为平台无关层,使用
C/C++实现,是Markdown的核心模块,主要实现markdown文本的解析、排版和渲染;三方库
md4c负责markdown文本的真正解析工作;NodeTree、AtomTree和BoxTree是非常重要的三树模型;Graphic2D以及其依赖的一系列抽象接口也非常重要,它们代表着虚拟的UI世界;BoxBreaker代表着排版的逻辑,其中包含着很多魔鬼细节;
橙色区域为平台相关层,目前已经适配
iOS和Android两个平台:iOS平台使用objc进行实现;Android平台使用Kotlin进行实现;
未来如果有其它平台的需求,例如
Flutter平台,可以进行规划适配。Flutter的适配不是指通过传统的Channel方式和iOS/Android平台通信,而是通过FFI让Dart和C++直接通信。
时序图
这里以Android的时序图为例
构建 Node 树
为什么选择 md4c?
目前有很多开源的项目支持markdown语法进行解析,因此没有必要重复造轮子。经过调研,最终选用了开源项目md4c
作为语法解析器,它具备以下优点:
符合
CommonMark 0.30标准;解析速度快;
简单易用;
具备可移植性;
业界著名的跨平台
UI框架QT就使用了该库来支持对markdown语法的解析。
如何使用 md4c?
md4c采用了Push模型:
MD4C parses the complete document and calls few callback functions provided by the application to inform it about a start/end of every block, a start/end of every span, and with any textual contents.
因此定义了一系列函数来处理这些回调:
1 | class MDParser { |
使用过程如下,设置好解析参数、回调函数,直接开始解析。
1 | // MDParser.cpp |
Markdown 节点定义
1 | // MDBaseNode.h |
那么SDK目前支持哪些语法树节点类型呢?
如何构建节点树?
1 | class MDParser { |
语法树的构建遵守如下进栈和出栈的规则:
- 当发生
enterBlock和enterSpan回调时,代表解析到节点开始,进行入栈操作:- 根节点
mRootNode为首个解析到的节点,只更新1次; mCurrentNode为当前的栈顶节点,每当解析到新的节点A,mCurrentNode会将该A添加为孩子,并将A赋值给mCurrentNode,代表栈顶节点已发生变化。
- 根节点
以无序列表为例:
1 | int MDParser::enterBlock(MD_BLOCKTYPE type, void* detail, void* userdata) { |
1 | void MDParser::pushNode(const std::shared_ptr<MDBaseNode> &node) { |
- 当发生
leaveBlock和leaveSpan回调时,代表节点解析结束,进行出栈操作。出栈之后需要更新mCurrentNode节点,这里为了保持入栈和出栈的一致性,会做一些平衡检查。
1 | int MDParser::leaveBlock(MD_BLOCKTYPE type, void* detail, void* userdata) |
1 | void MDParser::popNode(const std::string& name) { |
- 当发生
foundText回调时,代表解析到叶子节点,当前栈顶节点直接将其添加为孩子节点即可。
1 | int MDParser::foundText(MD_TEXTTYPE type, const MD_CHAR* text, MD_SIZE size, void* userdata) { |
1 | void MDParser::addChildNode(const std::shared_ptr<MDBaseNode>& node) { |
这个过程会一直递归下去,直到解析完成,最后可以通过
mRootNode 得到整个节点树。
如何处理html标签?
有的情况下,markdown语法中会内嵌html标签:
md4c会将其解析为叶子节点,且不会解析html标签其中的参数,所以需要额外解析标签,并根据其是开始标签还是结束标签决定是入栈还是出栈。此外html标签还有一些自闭合标签,例如<img/>,或者<br>,需要做一些额外的判断。md4c不会解析标签里面的属性,这也需要做额外的处理
1 | // MDParser.cpp |
1 | // MDParser.cpp |
这里定义了一个名为 HtmlTagParser 的类来专门解析
html 标签。
1 | // HtmlTagParser.cpp |
那么SDK目前支持哪些Html标签节点呢?
除了上角标和下角标节点,其余的很多Html节点都是和markdown节点都是共享的:
1 | // HtmlTagNodeAlias.h |
如何处理html实体?
有的情况下,markdown中会内嵌一些html实体符号,需要进行解析才能正常展示,解析后这些实体符号会被定义为MDTextNode节点。
1 | ₹ '−α⇒β∴–’γ&√≠ב"²±…≤≥÷λ°—½&OQ&Hintsº³­π∠Δ⊥“”·∼→θ′„∑≈≅ ⋅♠♥♦♣φ∈∀∉″∗∨∧∪δ∩¼⊂μ∫æö¶±±£»®§¯¹²³ßþ×úûù¨üý¥ÿ |
1 | // MDParser.cpp |
html实体符号的解析过程比较复杂,可以简单参考下面的代码
1 | // MDParser.cpp |
解析后,它们的展示效果如下:
1 | ₹ '−α⇒β∴–’γ&√≠ב"²±…≤≥÷λ°—½&OQ&Hintsº³π∠Δ⊥“”·∼→θ′„∑≈≅ ⋅♠♥♦♣φ∈∀∉″∗∨∧∪δ∩¼⊂μ∫æö¶±±£»®§¯¹²³ßþ×úûù¨üý¥ÿ |
示例
1 | 测试列表 |
以这段markdown文字为例,其生成的节点树如下所示
1 | MDDocNode |
构建 Atom 树
当通过递归下降法构建完一棵节点语法树之后,就需要生成对应的Atom树。一般来说,每种类型的Node节点都可以对应一种Atom节点,但是并非严格的一一对应。
Atom 类型
Atom 组装规则
由于递归下降解析规则,导致Atom也是可以递归嵌套的。一般情况下,最终会得到一个Atom或者一系列Atoms组成的RowAtom,其中每个Atom中又可以包含其他的Atom。
每一种Node节点都有getAtom虚方法,其中基类MDBaseNode的getAtom实现如下:
1 | // MDBaseNode.cpp |
通常情况下,当一个节点承载的是一个容器的功能,并且没有什么特殊的组装规则的时候,无需重写getAtom方法,例如MDDocNode节点、
MDParagraphNode节点等。除此之外,每个节点都应该重写
getAtom 方法。
例如,粗体节点MDBoldNode的getAtom方法,要把每个孩子生成的atom包装为BoldAtom,最后组装为RowAtom。
1 | // MDBoldNode.cpp |
有些节点规则比较复杂,例如MDTableNode节点,其getAtom如下所示:需要将节点的孩子,以及孩子的孩子节点取出来,并重新组装为MDTableAtom。
1 | // MDTableNode.cpp |
示例
继续以前面生成的节点树为例,其生成的Atom树如下所示:
1 | RowAtom |
构建 Box 树
每个Atom都会生成对应的Box,在Atom基类中会看到一个虚函数:
1 | // Atom.h |
Box代表着字符的绘制规则,具有几个比较重要的属性:
1 | class Box : public std::enable_shared_from_this<Box> { |
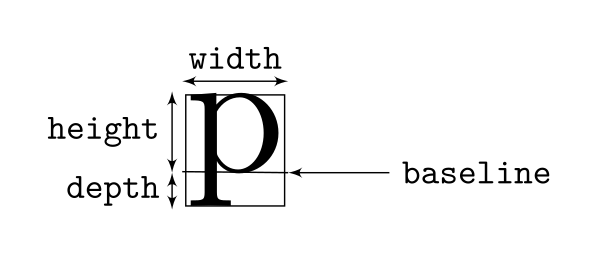
由于前面已经生成了一个节点类型为Atom的多叉树,所以createBox的过程也是一个递归下降过程:由每个子节点生成各自对应的Box,并在当前节点中按照规则进行组合。Box和Box之间会根据规则,基于baseline粘合到一起,最后也会形成一棵Box的多叉树,它和前面提到的Atom多叉树是对应的。
Box 类型
示例
继续以前面生成的Atom树为例,其生成的Box树如下所示:
1 | HorizontalBox |
此时不妨将这颗Box树和最终带有Debug方格的渲染效果图进行对比下。
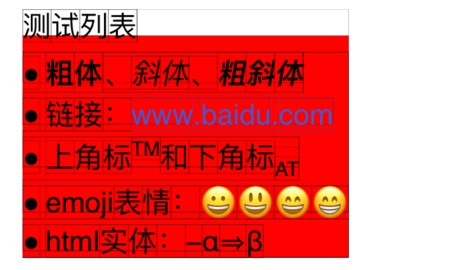
排版
前面的步骤最终形成了一颗Box的多叉树。解析完的Box都在C++层,并且C++层有天然虚拟的画板和画笔,只需要在画板上开绘就行。所以在绘制之前,需要进行排版,明确各元素的最终位置。
流式 Box 拆分
通常情况下,markdown元素的布局都是流式的,然而画板的宽度是有限的,所以要解决的第一个问题,就是如何根据给定的画布宽度,对Box树进行换行拆分。

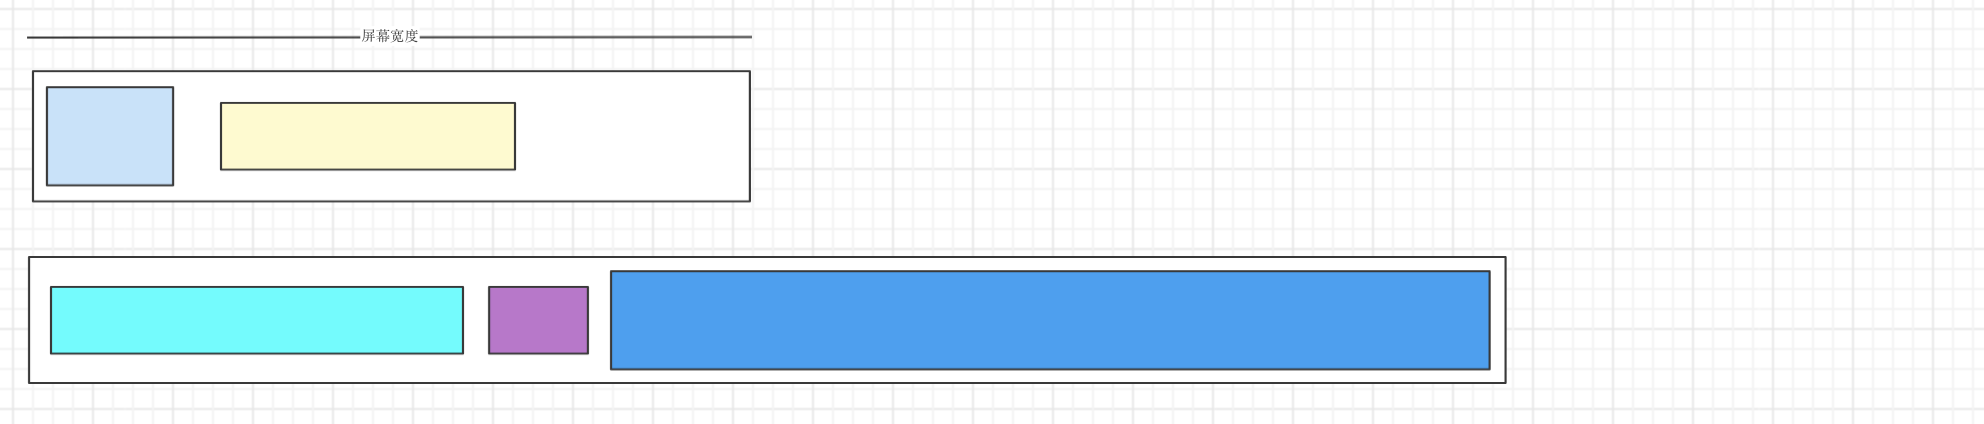
如图,假设这就是Box树:
白色节点是
root,淡蓝色节点为第1个孩子节点,
橘红色节点为第2个孩子节点,同时它有3个孩子节点,分别为黄色、天蓝色和紫色;
蓝色节点为第3个孩子节点。
假设现在要排版第一行,根据屏幕宽度,发现橘红色节点需要进行拆分,由于橘红色节点有子节点,所以需要递归,通过观察可以黄色节点需要归属到当前行,而紫色节点肯定无法归属到当前行,比较麻烦的是天蓝色节点,它是一个节点,又没有子节点,所以需要判断它是否可拆分
- 如果不可拆分,则可能是这样的结果:
- 如果可拆分,那么可能就会是这样的一个排版结果:
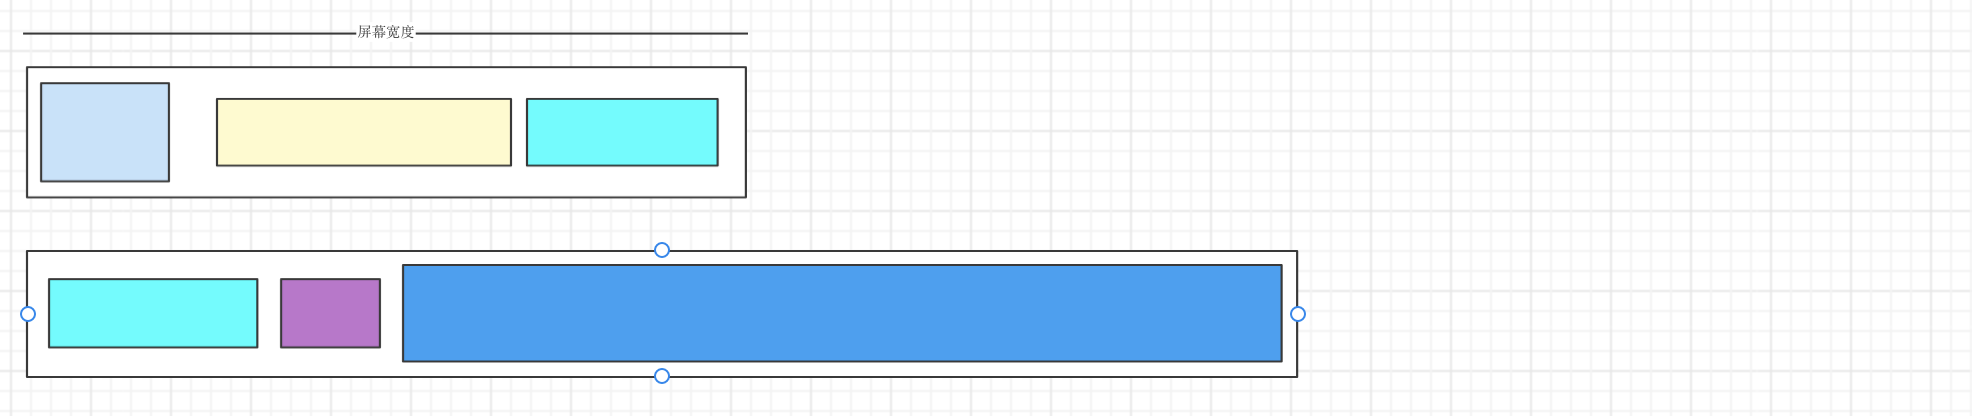
需要注意的是,拆分之后,橘红色节点消失了,这是由于橘红色节点作为一个父节点,相当于一个容器节点,并不会占用真正的空间,完全由其孩子节点决定的。然而更复杂的情况是,如果如果上述的天蓝色节点也有孩子节点,那么就需要继续递归下去,所以每一行的排版,可能都要涉及到多层次的深入递归,直至最后排满当前行。
块元素内部提前排版
markdown中有一些块元素,例如表格、列表或者引用,对外会占据整个宽度,对外表现为一个整体,拆分之后仍然独占一行。然而这些块元素的内部子元素也有换行的情况,因此这些块元素需要进提前将内部子元素排版好。
- 引用
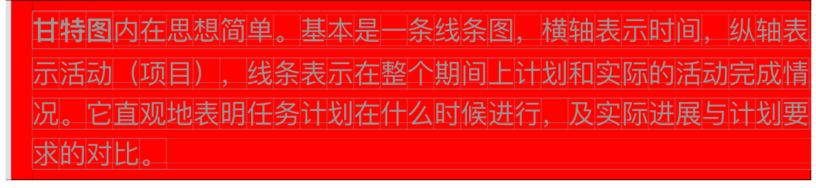
如上图所示,以"Quote"为例,最左边有和文本等高的灰色直线,排版的时候要把直线以及直线之后的空白处预留出来,因此要把上下文中的宽度减去预留位置的宽度。
1 | std::shared_ptr<Box> MDQuoteAtom::createBox(const std::shared_ptr<Environment>& env) { |
1 | MDQuoteBox::MDQuoteBox(const std::vector<std::shared_ptr<Box>>& boxes) : boxes(boxes) { |
- 表格
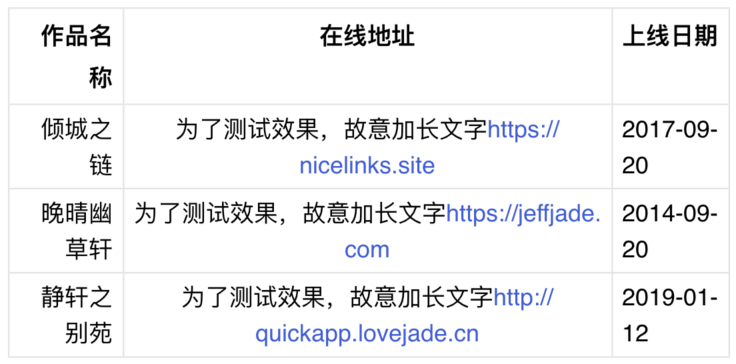
如图,关于表格的排版,要更加复杂一些:
首先要确定整个表格各个列的宽度,从而决定整个表格的宽度。有的情况下,表格的整个宽度都不及给定的宽度,而有的情况下表格的宽度则超出了给定的宽度。那么如何来决定表格各个列的宽度呢?
循环计算各列的最大宽度
将各列的宽度相加
如果和未超过给定宽度,则不作任何处理;
否则计算各列的比例百分比,用百分比乘以给定宽度,作为最后每个列的宽度.
每个表格单元中的内容都需要根据当前列的宽度,进行
Box拆分
另外表格的每一列都有自己的对齐规则:左对齐、居中对齐、右对齐,这些规则需要根据
markdown语法进行解析。
1 | std::shared_ptr<Box> MDTableAtom::createBox(const std::shared_ptr<Environment>& env) { |
行内对齐
关于对齐情况,要么左对齐,要么右对齐,或者居中。此时应对策略是:
左对齐,根据给定宽度,计算右侧空白区域,然后使用
StrutBox进行填充;右对齐,根据给定宽度,计算左侧空白区域,然后使用
StrutBox进行填充;居中对齐,根据给定宽度,计算左右两侧空白区域,然后使用
StrutBox进行填充;两端对齐,根据给定宽度,计算每两个字符之间的空隙,然后使用
StrutBox进行填充;
1 | double rest = w - b->getWidth(); |
排版规则(细节中的魔鬼)
类似于阅读引擎,Markdown
引擎中的文本排版有很多相似的默认规则。但不同于普通的流式文本,Markdown
的文本排版始终行驶在一个 Box
的多叉树上,遵守这些排版规则需要付出比较相对高昂的代价。
中文都是换行点;
避首避尾标点都不是换行点;
连续破折号不是换行点;
空格都是换行点;
英文单词不是换行点;
部分英文标点不是换行点;
符号分离禁则
以下标点符号,在行间应为一体,视作一个字符存在,不能为了适配分行而拆成两行。
破折号:––
省略号:……和······
竖直双引号:“xxx”,xxx为一个英语单词。
缩写:例如 I’m、You’re 等
这些问题的解决方案如下:在 MDTextNode
中对文本拆分的时候进行的,提前进行绑定,在排版的时候被当成一个整体来对待。
1 | std::shared_ptr<Atom> MDTextNode::getAtom() { |
行尾行首禁则
为了保持阅读顺畅、体验一致,多数标点符号的位置有限制,通常一个标点符号依其性质,禁止出现在行首或行尾:
点号(顿号、逗号、句号、冒号、分号、叹号、问号)、结束引号、结束括号、结束双书名号(书名号乙式)、连接号、间隔号、分隔号不能出现在一行的开头。
开始引号、开始括号、开始单双书名号等符号,不能出现在一行的结尾。
那么有哪些需要避头尾的标点呢?
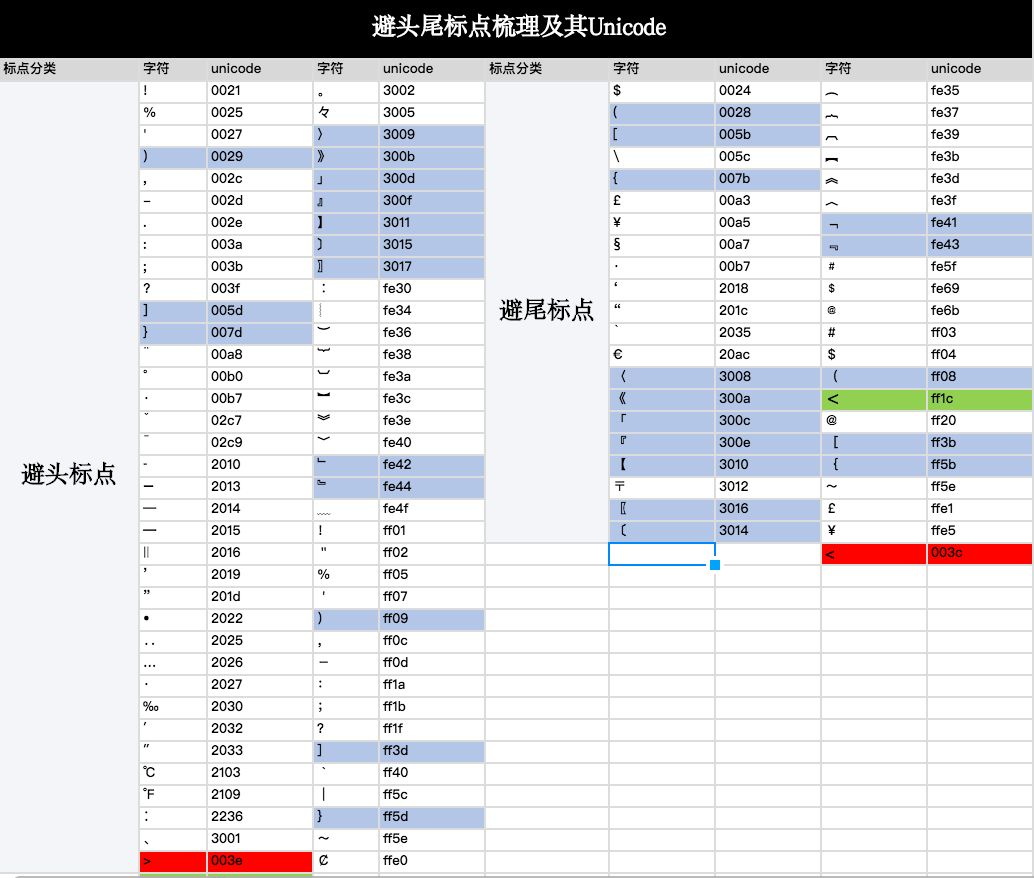
图引自:https://www.zcool.com.cn/article/ZMTE5NjYwOA==.html#kuak
“推出式”避头尾 vs “优先推入式”避头尾
左图和右图均引自:https://www.zcool.com.cn/article/ZMTE5NjYwOA==.html#kuak
“推出式”避头尾是大部分排版系统的做法,以避头标点为例,若此标点被排到了行首,“推出式”的做法是从上一行拉一个字放在本行。然而这么做的话,上一行的字间距被拉大,打断了阅读节奏,如左图所示。
“优先推入式避头尾”,通过将本行内的标点宽度进行挤压后,腾出了空间给本来排不到的逗号,确保了字间距的恒定。然后只有在本行内标点无法压缩出足够空间时,才会选择“推出式”的处理方式。以避头尾标点为例,“优先推入式”避头尾在这种情况下会将本行内标点宽度挤压,为避头尾的标点腾出空间,如右图所示。
行首空白处理
有的情况下,空白字符会位于某些行的行首,此时应将行首的空白字符剔除。
1 | // LayoutRuler.cpp |
标点符号的宽度调整
连续标点符号的调整
无论文本整体采用何种风格,当夹注符号与其他符号连续排列时,或者夹注符号重复出现(如开始+开始,结束+结束,或者结束+开始)时,都应该进行原则上的调整,以使文字体裁更加紧凑、易读。原则上的调整度应为:如果任意两个相邻标点符号占用2个字宽,应当缩减成1.5个字宽。在此原则上,允许排版风格进一步调整让两个符号只占1个字宽。挤压方向判定原则上应该让开始、结束夹注符号应紧靠被夹注的内容。
具体的挤压规则如下:
【结束夹注符】后面是:开始夹注符、结束夹注符、顿、逗、句(包括全宽句点)、冒、分,就挤;
【开始夹注符】后面是:开始夹注符,就挤;
【顿、逗、句】后面是:开始夹注符、结束夹注符,就挤;
【分、冒】后面是:开始夹注符,就挤;
1 | void LayoutRuler::applySqueezeRulesOfAdjacentPunctuation(const std::shared_ptr<HorizontalBox>& root) { |
行首行尾标点挤压
当标点符号出现在行首或行尾时,以下的空隙调整规则使文字体裁更加紧凑、易读。
当行首出现开始夹注符号,可以缩减该符号始侧二分之一个汉字大小的空白。
原本占一个字宽的标点出现在行尾时,应缩减该符号末侧二分之一个汉字大小的空白。
如何支持 RTL?
RTL 是 Right-to-left
的缩写,其意为人们书写阅读习惯是从右向左,朝左继续的,常见的 RTL
语言有阿拉伯语,希伯来语等。iOS 从 9.0 开始提供了系统方案支持 RTL
界面,主要是提供了 leading 和 trailing 的
UILayoutGuide 来替代需要在 RTL 中翻转的场景下的
left 和 right,以及 UIView 的
semantic attributes —— 也就是说在 RTL
环境中,leading 等同于
right,trailing 等同于
left,而在一般环境下反之。有些解决方案使用 Window
镜像的方案来适配
RTL,然而有些元素是不可翻转的,例如文本类元素,因为文本类元素无条件需要正面对着观众。因此
UILabel、UITextView、YYLabel 等组件,默认就属于
不可翻转的元素。
那么自定义的Markdown 引擎又应该如何来处理 RTL
问题呢?
Markdown中有大量的文本类元素,不可翻转,那么就需要自己处理文本元素 RTL 逻辑;Markdown还包括大量的其它元素,例如引用、表格、列表等,也需要适配 RTL 规则。
示意图中左边 Markdown 引擎是不经过处理的显示,右边是经过处理后正确的显示
如何使用?
1 | MarkdownParam *param = [[MarkdownParam alloc] init]; |
文本
引擎会针对每个段落,使用其第一个字符作为排列顺序的判断依据。比如文本 “مرحبا 你好”,因为第一个字符是阿拉伯语字符,所以会使用 RTL 规则处理。同理,如果文本是“你好 مرحبا“,因为第一个字符是中文,则会使用 LTR 规则
如果使用 LTR 规则,那么逐行扫描每一行中 RTL 的区域,并将这些区域中的 RTL 文本进行首尾翻转;
如果使用 RTL 规则,则要进行下面的步骤:
逐行扫描每一行中的 RTL 区域,并将其中 RTL 区域中的文本首尾翻转;
逐行扫描每一行中的 LTR 区域,将 LTR 区域最后的标点符号和空格分别移动到该区域首部位置;
以前面扫描出来的的区域为单位,循环移位;
引用
- 灰色竖直线要靠右排版;
- 其中的文字要整体右对齐;
列表
对于列表
- 黑色圆点整体靠右排版;
- 其中的文字要整体右对齐;
表格
对于表格:
- RTL 首先要整体靠右对齐;
- 表格的列也是从右往左排,例如 LTR 的第一列数字,在 RTL 中属于第三列
- 对齐方式也需要适配,例如 LTR 中的左对齐,在 RTL 变成了右对齐
事件交互
单击事件
Markdown的一些元素是需要支持点击事件的,例如链接元素。由于整个渲染都是在C/C++层绘制完成的,并不涉及到具体的Native控件,那么如何来支持事件呢?答案是递归寻找事件信息
hitTest
在基类Box定义hitTest方法
1 | // Box.h |
在一些子类中重写hitTest方法
1 | // HorizontalBox.cpp |
事件信息绑定
当某个元素需要事件的时候,可以把事件的类型和一些参数绑定到区域对应的Box上。例如,这里创建
AreaInfo 并将其附加到 MDHrefNode 生成的
Atoms 上,随后 Atom 将 AreaInfo
传递给生成的 Boxes。
1 | std::shared_ptr<Atom> MDHrefNode::getAtom() { |
1 | void FontRenderingAtom::addTexBox(SplitStyle splitStyle, std::shared_ptr<HorizontalBox>& hb, const std::wstring &str, int style, double factor, const std::shared_ptr<Font>& font, bool kerning) { |
给定坐标寻找事件信息
当触摸事件发生时,坐标将传递给 Icon,Icon
最终将找到包含该坐标的不可分割的 Box。 然后
Icon 将检查框中是否有绑定的 AreaInfo。 如果
AreaInfo 不为空,可以通过代理抛出必要的信息来响应事件。
1 | std::shared_ptr<AreaInfo> Icon::getAreaInfo(const std::shared_ptr<Point2D>& point) { |
1 | - (void)touchesBegan:(NSSet<UITouch *> *)touches withEvent:(UIEvent *)event { |
区域选中
作为一个富文本渲染组件,自然需要和用户进行交互,而常见的交互操作首当其冲便是区域选中,由于是自定义组件,所以这个功能也需要开发实现。区域选中的功能原理比较简单:给定一片区域,如果某个元素在这块区域中,则进行染色,否则不进行处理。原理虽然简单,但是实践起来却是不易,接下里逐步描述实现过程
长按确定起点和终点
通常来说,区域选中都是通过长按来实现的,长按过程中有一些状态的变化,当长按结束后且未被取消,就可以获取起点和终点
1 | - (void)handleLongPress:(UILongPressGestureRecognizer *)gestureRecognizer { |
修改起点和终点
当某个区域被选中后,仍然可以响应touch事件来拖拽起始或者结束锚点,从而改变选中区域
1 | - (void)touchesBegan:(NSSet<UITouch *> *)touches withEvent:(UIEvent *)event { |
根据起点和终点确定区域
当给定起点和终点后,会发现仅仅通过两个点来定义一片区域会造成一些错误
如图所示,如果起点为sp,终点为ep,那么橙色区域则为两坐标点之间的区域,而浅绿色方格则为文字所在的方格,很明显这种情况下按照坐标来计算的话,这些文字方格是未被包含在区域中的,是无法被选中的,但是从实际体验上来说,是希望这些方格被选中的。所以硬计算坐标会有明显的缺陷。
换一个思路,如果某个点定位到某个方格中,则代表该方格被选中,在这种情况下,可以重新校正起点和终点:
- 将起点所在方格的左上角坐标设置为新的起点
- 将终点所在方格的右下角坐标设置为新的终点
那么新的选中区域如下所示,期望选中的方格都可以被选中
上述情况只是单行,多行又有新的问题,如果将区域人为地按照行来进行分割,会造成计算的错误,因为其中某些理应被选中的文字可能会占据多行,可能会出现无法归属的情况,导致未被选中,因此最终采取了补全方案:
- 将选中区域的左上角和右下角补全,整体区域作为\(S_1\)
- 将补全的区域作为\(S_2\)和 \(S_3\)
- 那么方格被选中的条件为:\(S_1\)包含该方格 && \(S_2\)和 \(S_3\)不包含该方格
该方案可以同时适应单行和多行的情况,非常便于理解和计算。
根据给定区域计算确定包含元素
确定好区域后,就可以遍历 Box
树进行匹配了,这里直接采用多叉树的前序遍历方式。当获取到这些包含着区域内的
box 之后,进行坐标转换,直接绘制即可。
1 | std::vector<std::shared_ptr<Box>> Icon::getSelectedBoxes(const std::shared_ptr<Point2D>& sp, const std::shared_ptr<Point2D>& ep, double lineHeight) { |
效果图
平台无关接口
绘制实现在每个端上都是不同的,为了增强代码通用性,对平台进行了抽象,限于篇幅,这里只列出部分接口
Graphics2D
Graphics2D定义了2D绘制设计的一些虚接口:
绘制字符串、直线、矩形、视图等;
进行变换:平移、缩放和旋转等;
设置字体、颜色、线条等;
1 | class Graphics2D { |
TextLayout
TextLayout 是另一个非常重要的接口类,它抽象了文本的布局和渲染接口
1 | class TextLayout { |
Others
除了这两个接口外,还有一些其他接口,如Point2D、Line2D、Retangle2D、Path和View。
限于篇幅,这里不再展开。
平台适配
iOS
OC/C++ 混编
iOS 的平台适配是通过 OC/C++
混编方式实现的,只需要将文件命名为.mm
形式,就可以在一个文件中同时访问 OC 和 C++ 的
API 。关于 OC/C++
混编,有一些注意事项需要了解:objc++ 没有为 OC
类增加 C++ 的功能,也没有为 C++ 增加
OC 的功能,例如:不能用 OC 语法调用
C++ 对象,也不能为 OC
对象增加构造函数和析构函数,也不能将 this 和
self 互相替换使用。类的体系结构是独立的,C++
类不能继承 OC 类,OC 类也不能继承
C++ 类。
更多的OC/C++
混编细节可以参考我之前的一篇微信公众号投稿文章: 《深入理解
OC/C++ 闭包》。
每个接口都对应着一个实现类,混编可以在 .mm 中同时书写
OC 和 C++,非常直接了当。
Graphics2D_iOS
以绘制字符串为例,看一下方法实现,会发现这些API在阅读引擎系统中很常见。
1 | void Graphics2D_iOS::draw(const std::string& t, int x, int y) { |
TextLayout_iOS
1 | // TextLayout_iOS.mm |
How to bind?
MarkdownView 对象包含 _icon,而
_icon 的 paintIcon 需要一个
Graphics2D 类型参数
1 | class Icon : public std::enable_shared_from_this<Icon>, public IIcon { |
同时 MarkdownView 持有1个 _graphics
对象,根据 C++ 的多态特性,只要把 _graphics
传递给 paintIcon 方法,就完成了绑定。
1 | // MarkdownView.mm |
Android
分层实现
Android平台的适配需要借助JNI来实现Kotlin和C/C++两种语言的相互通信,所以设计为3层:
Kotlin层的API层JNI通信层C/C++的实现层
不同于 iOS,这里每个接口同时对应一个 C++
的实现类(xxx_Android)和一个 Kotlin
的实现类。这是由于 Android无法做到混编,无论是
C++ 的实现类还是 Kotlin
的实现类,都无法单独完成接口适配的工作。二者必须通过 JNI
相互配合,弥补对方不足,绑定成一个整体来完成适配工作。
Graphics2D_Android
调用流程: draw->markRecord->JNI->record->play->drawText
1 | // Graphics2D_Android.cpp |
1 | // Graphics2D.kt |
TextLayout_Android
1 | std::shared_ptr<Rectangle2D> TextLayout_Android::getBounds() { |
1 | class TextLayout { |
How to bind?
1 | // MarkdownView.kt |
JNI 通信
Kotlin -> C/C++
举个栗子:
MarkdownIconBuilder.kt文件中有个方法叫build方法:
1 | // MarkdownIconBuilder.kt |
但是Kotlin层本身没有解析能力,所以需要调用到C/C++层,因此需要声明
nParse 方法
1 | private external fun nParse(param: MarkdownParam, generatorPtr: Long): Long |
nParse方法本身会被映射到jni_iconbuilder.cpp文件中的
Java_com_edu_markdown_api_MarkdownIconBuilder_00024Companion_nParse方法,这个长名字方法则会调用
MDIconBuilder完成真正的解析工作。
1 | extern "C" |
这样就完成了Kotlin到C/C++的调用
C/C++ -> Kotlin
举个栗子:
Graphics2D_Android.cpp中有个方法叫makeRecord,该方法涉及到绘制逻辑,C/C++接口层本身没有绘制能力,所以需要触发Kotlin层的API调用到Kotlin层。
1 | void Graphics2D_Android::makeRecord(int action, jobject arg, const jfloat* args, int argsLen) { |
之后在需要的时候通过JNIEnv的Call系列方法进行调用,只需要将类名、方法名、参数传递进去即可,例如
1 | env->CallVoidMethod(_javaGraphics2D, gMethodRecord, action, arg, arr); |
这样就完成了C/C++到Kotlin的调用。
jni_def.cpp文件中把C/C++需要的Kotlin
API作了暴露
1 | static void load(JNIEnv* env) { |
定制化
有些情况下,业务侧可能对某些节点有着不同的理解和呈现方式,Markdown作为一个SDK,在面对多个业务接入的情况下,还是需要遵守标准的渲染方式,那么如何来缓解这种矛盾呢?
解决问题的办法就是提供一种方式,让业务侧提供节点的实现UI,并将这种实现注入到引擎,注入的UI要参与Markdown的排版过程,最终被引擎绘制到画布上。
iOS
抽象View接口
第一步是定义 View
接口:getWidth、getHeight和
getDepth 用于布局,setX、setY和
getNativeView用于渲染。
这里列出的纯虚方法都是缺一不可的。
1 | class View { |
定义View_iOS
第二步是实现接口View。 对于 iOS,定义了
View_iOS,实现逻辑非常简单易懂。 唯一值得一提的是在
setX/setY/getNativeView 方法中调用了
invokeRenderBlockIfNeeded 方法。
这样做的原因是允许布局和渲染逻辑在不同的线程中完成,显然引擎不想在子线程中解析期间操作
UI。 实际上,在排版过程中并没有生成真正的视图。
1 | View_iOS::View_iOS(double w, double h, double d, ViewRenderBlock block, NSDictionary *attr) { |
定义 MDCustomNode_iOS
根据前面提到的树模型,定义了MDCustomNode_iOS作为定制化的
Node,从代码中可以看出布局逻辑是在 getAtom
方法中通过执行 layoutBlock 来实现的。 随后创建了
MDCustomAtom_iOS 对象,一切看起来都很好。
然而,这里有一个容易忽略的问题:content。
在定制化布局时,需要具体的内容,而内容与子节点相关。
当一个节点刚产生时,它并不知道自己有哪些子节点,只有当整个节点树构建完成后,才能从子节点中获取内容。当然这里的处理也比较粗糙,只能应对最简单的文本情况。
1 | std::shared_ptr<Atom> MDCustomNode_iOS::getAtom() { |
定义 MDCustomAtom_iOS
1 | MDCustomAtom_iOS::MDCustomAtom_iOS(const std::string& name, const std::map<std::string, std::string>& attributes, CustomLayoutRender layoutRender) : MDCustomAtom(name, attributes), mLayoutRender(layoutRender) { |
排版定制视图
1 | std::shared_ptr<Box> MDCustomAtom::createBox(const std::shared_ptr<Environment>& env) { |
绘制定制视图
1 | void MDCustomViewBox::draw(const std::shared_ptr<Graphics2D>& g2, double x, double y) { |
根据 C++ 的多态性,g2->draw
会调用下面的方法,该方法通过 addSubview
方法将原生视图添加到其父视图(MarkdownView)中。
1 | void Graphics2D_iOS::draw(const std::shared_ptr<View>& view) { |
由于 cell
复用机制,这里的实现会造成一些问题,所以每次调用
MarkdownView 的 drawRect 时,都需要先调用
[nativeView removeFromSuperview],将
nativeView 从老的父视图中移除。
注册定制实现
假设此时,业务侧想把sup标签理解为1个输入框,那么定制如下:
1 | auto func = ^CustomViewParam *(NSString* name, NSDictionary<NSString*, NSString*>* attributes) { |
Android
抽象View接口
和 iOS 一致。
1 | class View { |
定义View_Android
第二步是实现接口View。 对于 Android,定义了
View_Android,该类持有一个 Kotlin 的真正视图
mView。 不同于 iOS的懒加载生成视图,这里的
mView 是由外面生成传入的,是提前生成的,具体原因是
Android 想达到 iOS
的懒加载效果,需要付出比较高昂的代价,这里做了一些妥协。
1 | View_Android::View_Android(double width, double height, double depth, jobject view) : mWidth(width), mHeight(height), mDepth(depth), mView(view){} |
定义 MDCustomNode_Android
1 | std::shared_ptr<Atom> MDCustomNode_Android::getAtom() { |
不同于 iOS可以通过 block
直接生成视图,Android 则需要先定义一个
MDCustomViewGenerator 类型的变量
mGenerator,专门负责视图的排版和渲染工作。
1 | class MDCustomViewGenerator { |
由于 MDCustomViewGenerator 本身在 C++
层,无法创建一个真正的视图,所以需要同时在 Android
层创建一个真正的视图生成器,真正的视图生成器需要实现这个接口中的方法(这个真正的视图生成器和真正的视图会在后文讲到),这里只需要面向接口去理解。
1 | interface ICustomViewGenerator { |
1 | // CustomViewGeneratorManager.kt |
那么此时,就需要 C++ 层的
MDCustomViewGenerator 和 Kotlin
层的CustomViewGeneratorManager 通过 JNI
进行交互:
1 | jobject MDCustomViewGenerator::createView(const std::string &name, const std::map<std::string, std::string> &attributes) { |
定义 MDCustomAtom_Android
1 | MDCustomAtom_Android::MDCustomAtom_Android(const std::string& name, const std::map<std::string, std::string>& attributes, double width, double height, double depth, jobject jView) : MDCustomAtom(name, attributes) { |
排版定制视图
和 iOS 一致
1 | std::shared_ptr<Box> MDCustomAtom::createBox(const std::shared_ptr<Environment>& env) { |
绘制定制视图
1 | void MDCustomViewBox::draw(const std::shared_ptr<Graphics2D>& g2, double x, double y) { |
根据 C++ 的多态性,g2->draw
会调用下面的代码逻辑将原生视图添加到其父视图(MarkdownView)中。
1 | ACT.ACT_DRAWVIEW -> { |
注册定制实现
假设此时,业务侧想把sup标签理解为1个输入框,那么定制如下:
1 | class InputViewGenerator : ICustomViewGenerator { |
1 | class InputCustomView(width: MDSize, height: MDSize, depth: MDSize) : CustomBaseView(width, height, depth) { |
1 | val param = MarkdownParam( |
性能
这些性能数据会持续更新
包体积
| 平台 | 设备 | 静态库 | 动态库 | |
|---|---|---|---|---|
| iOS | iPhone11 | 290 KB | 546 KB | |
| Android | Xiaomi M2104K10AC | - | 471 KB (arm64-v8a) | 354 KB (armebabi-v7a) |
由于一些
thin lto未统计在内,iOS的静态库数值偏小,真实值应该在300KB~400KB
CPU耗时
Support parsing asynchronously? YES
Support layouting asynchronously? YES
Support rendering asynchronously? NO
| 平台 | 设备 | Parse | Layout | Rendering |
|---|---|---|---|---|
| iOS | iPhone11 | 9 ms | 37 ms | 8 ms |
| Android | Xiaomi M2104K10AC | 3 ms | 34 ms | 30 ms |
内存消耗
| 平台 | 设备 | 内存占用 |
|---|---|---|
| iOS | iPhone11 | ~8 MB |
| Android | Xiaomi M2104K10AC | ~10 MB |
总结
本文的主要目的是介绍如何实现一个跨平台的 Markdown
渲染引擎,但是到此时你也许会发现,是否是解析和渲染Markdown已经不再重要,学会使用其中的排版和渲染思想才是最重要的。当你理解了其核心原理后,你也许可以实现一个自己的跨平台X引擎。
参考
- https://commonmark.org/
- https://github.com/mity/md4c
- 英文标点要如何排版?
- 图文落地页阅读体验优化探索
- 深入中英文的排版与换行(视频)
- 深入中英文的排版与换行
- Basic writing and formatting syntax
- Requirements for Chinese Text Layout 中文排版需求
- 译文排版规则指北
- The punctuation guide
- 全角半角碎碎念
- 不离不弃的破折号
- https://www.uisdc.com/chinese-typesetting-3-principle
- 移动阅读软件 :中文排印上那些你不知道的事
- 孔雀计划:中文字体排印的思路
- https://github.com/w3c/clreq
- 阿拉伯文字的艺术、设计和开发:伊斯兰书法和字体
- 阿拉伯文字的艺术、设计和开发:RTL布局的设计要点
- 阿拉伯字母变形表
- Text Layout Requirements for the Arabic Script
- UNICODE及其编码(UTF-8、UTF-16、UTF-32)
- https://www.catch22.net/tuts/#
- https://juejin.cn/post/7124887769796591653
- https://gitlab.com/gitlab-org/gitlab-foss/-/merge_requests/6296
- http://rtlmd.codecast.ir/
- https://github.com/dalirnet/rtl-markdow

