背景
App 中有几类图像理解需求,例如作品检索、补充图片 Prompt 和生成发布文案,目前主要依赖服务端大模型。为了降低调用成本、图片传输和网络延迟,我们开始探索端侧模型。
此前调研了 MLX、llama.cpp 等推理框架。本文以 SmolVLM 和 llama.cpp 为例,从模型结构入手,继续分析它在 llama.cpp 中的完整推理过程。选择这套组合主要有两个原因:
- SmolVLM 提供了多种适合端侧运行的量化版本,llama.cpp 较早完成了对该模型的适配。
- llama.cpp 本身以 C++ 实现,也便于两端复用底层推理代码,减少跨平台语言层的额外适配。
VLM 模型简介
本节内容参考 SmolVLM 论文。
大多数 VLM 都可以拆成三个核心模块:视觉编码器(Vision Encoder)、投影器(Projector)和大语言模型(LLM)。视觉编码器负责提取图像特征,投影器把这些特征映射到语言模型能够处理的嵌入空间,LLM 再结合文本 token 完成理解与生成。
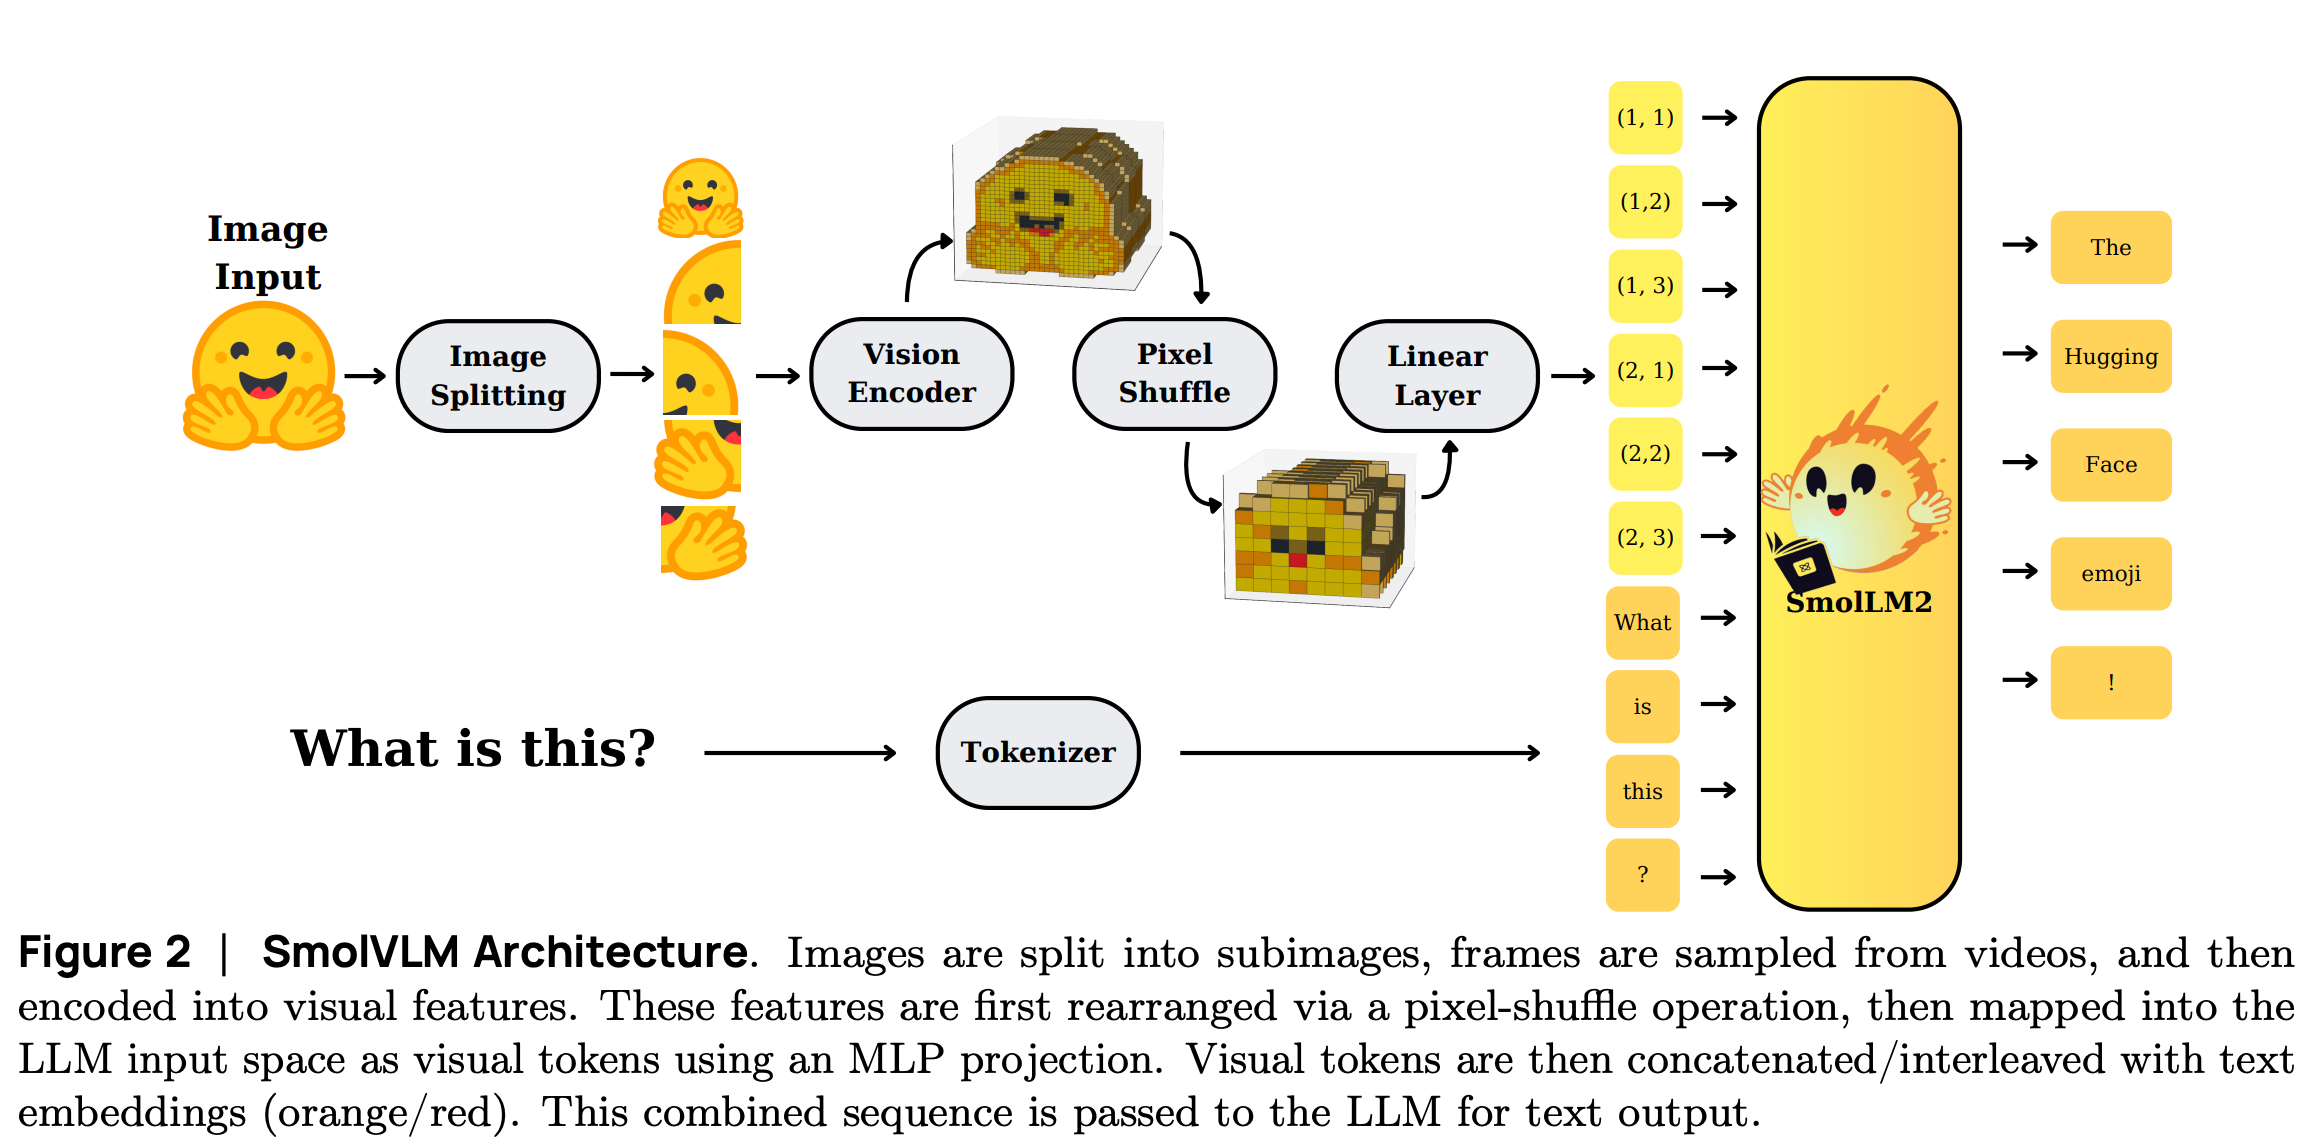
SmolVLM 沿用了这一结构,并针对内存占用和推理效率做了调整。图像或视频帧先被编码为视觉特征,再与文本嵌入组成混合序列送入语言模型。对应到模型中有三部分:
- Vision Model:SigLIP 编码器负责处理输入图像或视频帧,提取视觉特征。
- Projector:先通过 Pixel Shuffle 对视觉特征进行压缩,再统一映射到语言模型的嵌入空间,供 LLM 理解与处理。
- LLM:基于 SmolLM2,处理视觉与文本组成的混合序列并生成结果。
SmolVLM 的图像切分策略
SmolVLM 在视觉编码前会执行 Image Splitting。这里容易产生误解:它不做对象级语义分割,而是根据图片尺寸和模型限制划分规则网格,同时保留一张低分辨率的全局缩略图。局部切片保留细节,全局图补充整张图片的上下文。
直接编码全图:若将 1920×1080 等高分辨率图片直接缩放到视觉编码器的固定输入尺寸(如 512×512),小文字、图表元素等细节容易丢失。
规则切片:将缩放后的图片按固定网格切成多个子图,每个子图单独编码,可以在模型输入尺寸不变的情况下保留更多局部信息。
视觉编码器
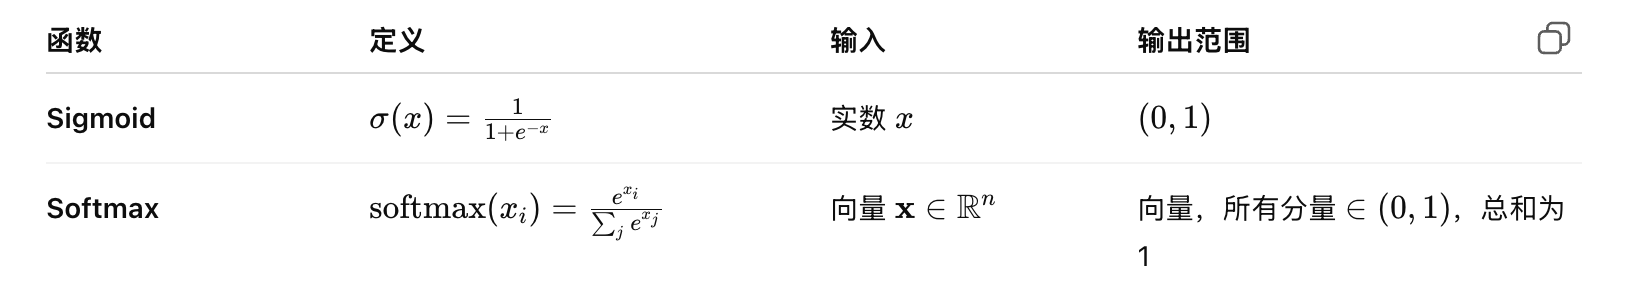
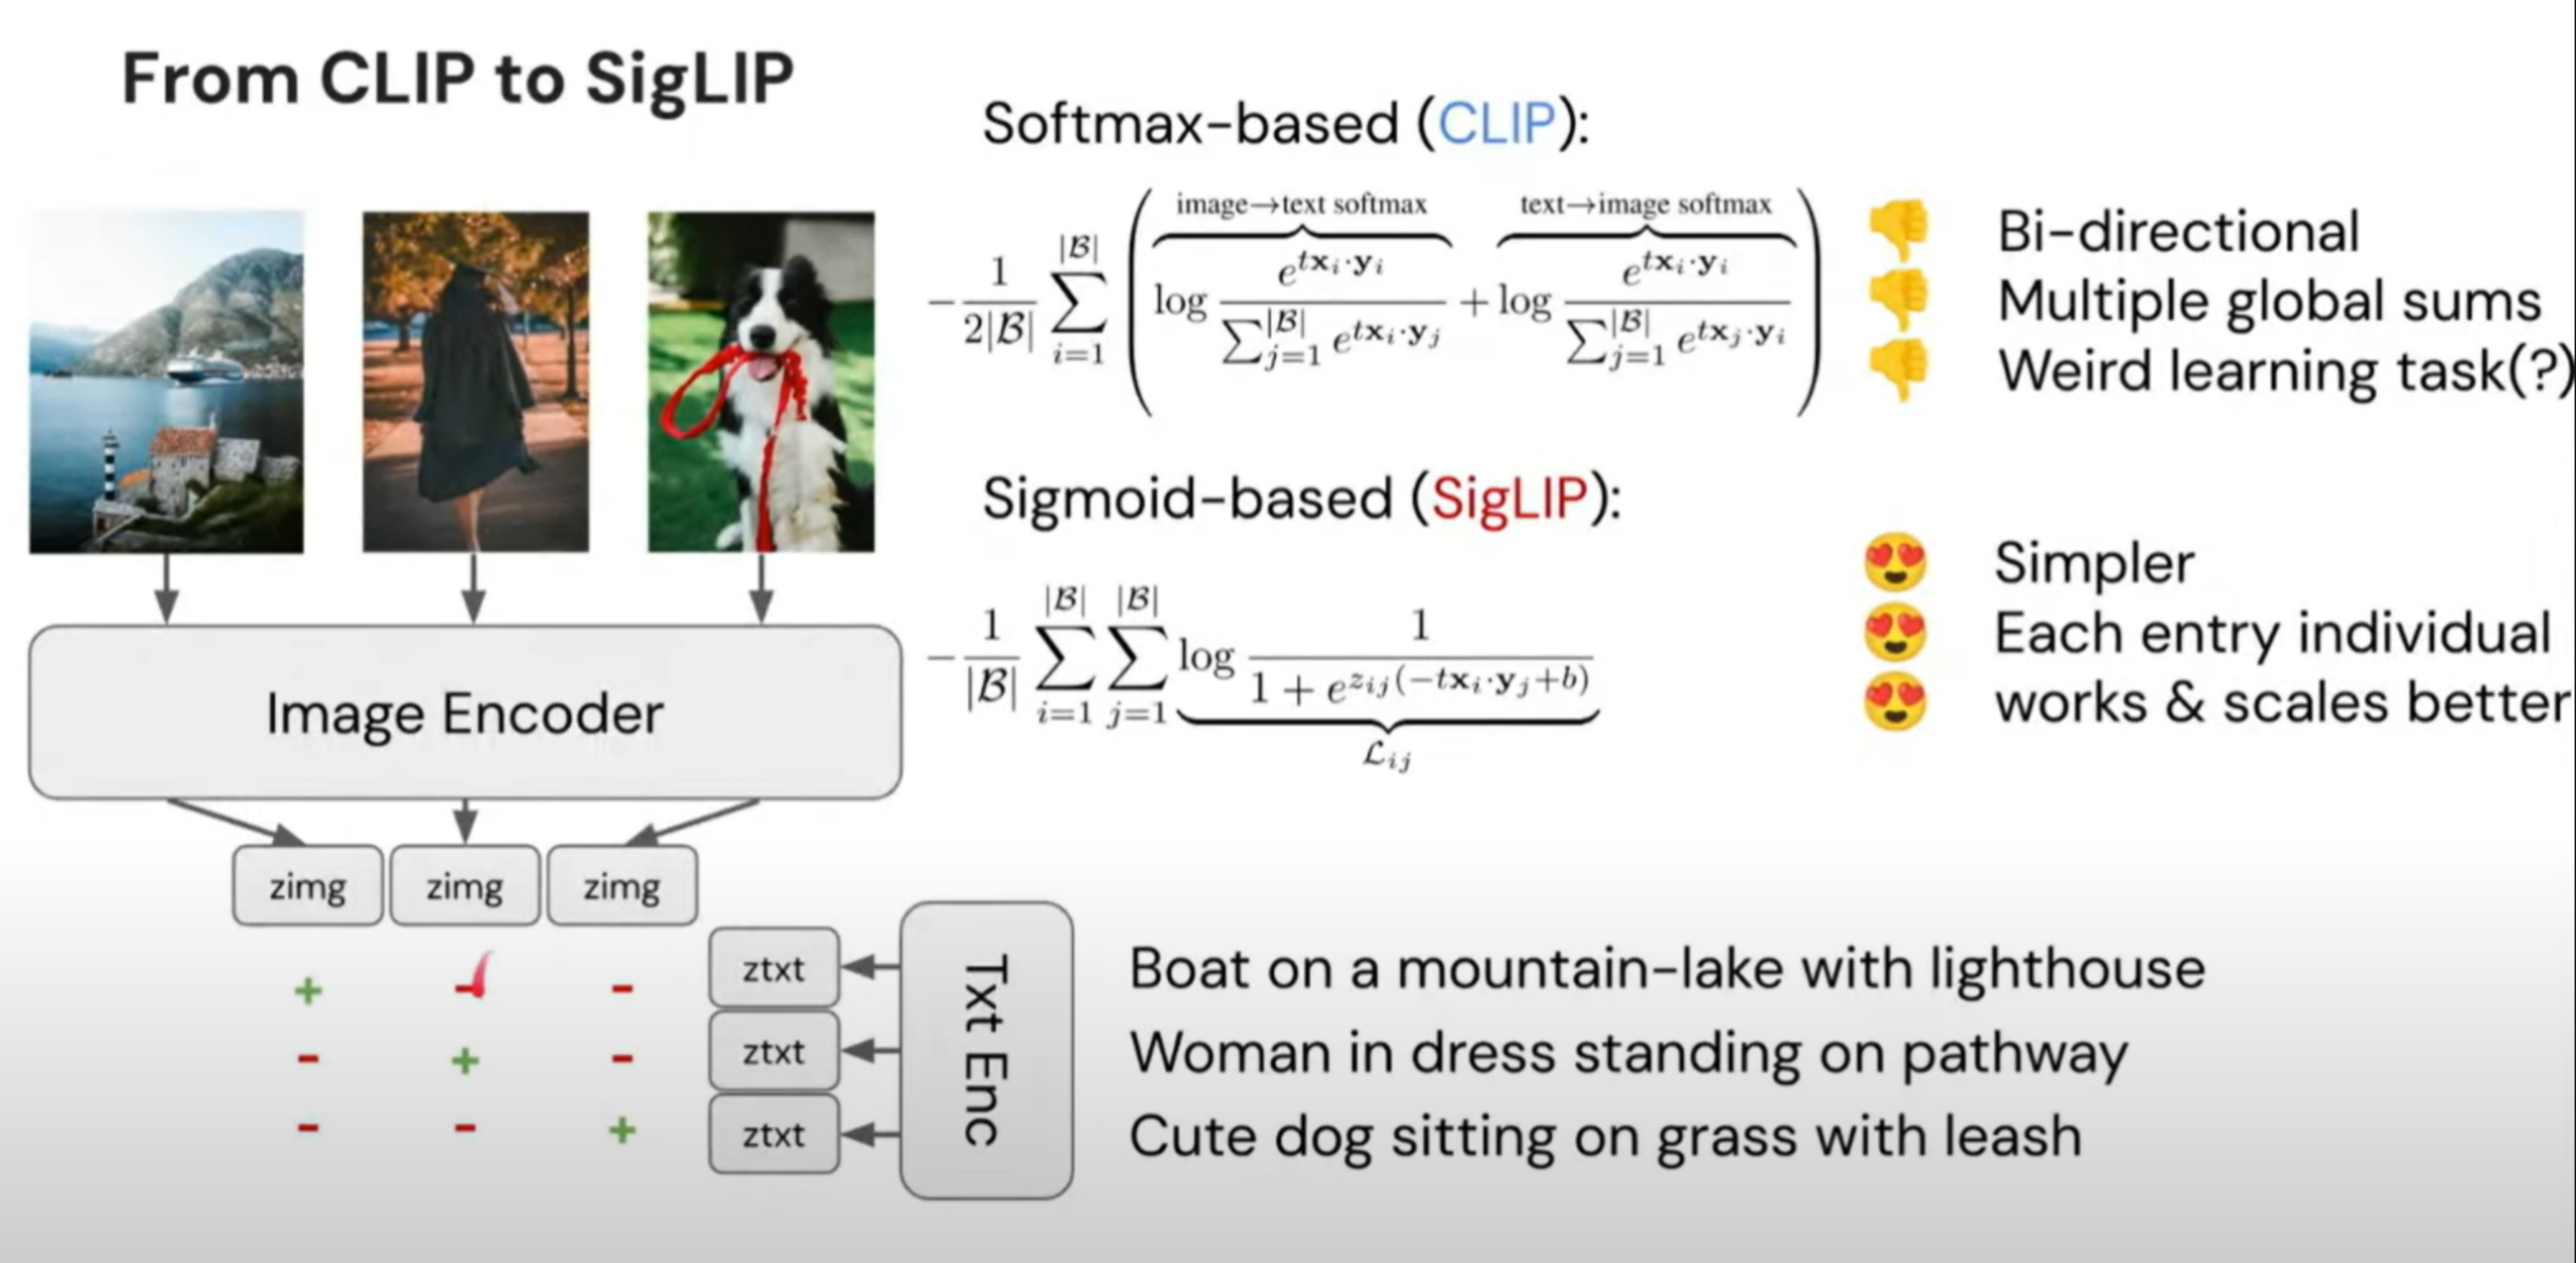
SmolVLM 的视觉编码器基于 SigLIP(Sigmoid Loss for Language-Image Pretraining)。SigLIP 采用 Vision Transformer(ViT)架构,通过图文对预训练,把视觉信息编码为紧凑的特征表示。与 CLIP 的全局 softmax 不同,SigLIP 对每个图文对独立计算 sigmoid loss,不需要对批次内所有相似度做全局归一化,因此对 batch size 的依赖更小。
| 对比维度 | CLIP | SigLIP |
|---|---|---|
| 提出时间 | OpenAI,2021 | Google,2023 |
| 训练目标 | 在一个 batch 内对图文相似度进行全局 softmax 归一化 | 对每个图文对独立计算 sigmoid loss |
| 对 batch 的依赖 | 通常需要较大的 batch 才能获得足够多的负样本 | 不依赖全局归一化,在较小 batch 下也能保持较好的训练效果 |
SmolVLM 会根据模型规模和应用场景选用不同的 SigLIP 变体:
SigLIP base patch-16/512:参数量约 93M,patch 大小为 16×16 像素,用于 SmolVLM-256M 和 SmolVLM-500M,适合资源受限的设备。
SigLIP-SO400M:参数量约 428M,patch 大小为 14×14 像素,用于 SmolVLM-2.2B,面向更高性能需求。
SmolVLM 的实验表明,增大视觉编码器并不一定能显著提升整体效果。搭配 135M 语言模型时,428M 视觉编码器的表现反而不及 93M 版本;搭配 360M 语言模型时,较大的编码器虽然带来了 11.6% 的性能提升,参数量也随之增加了 66%。
对紧凑型 VLM 来说,单独增大视觉编码器未必划算。语言模型太小时,额外增加的视觉特征不一定能被充分利用。
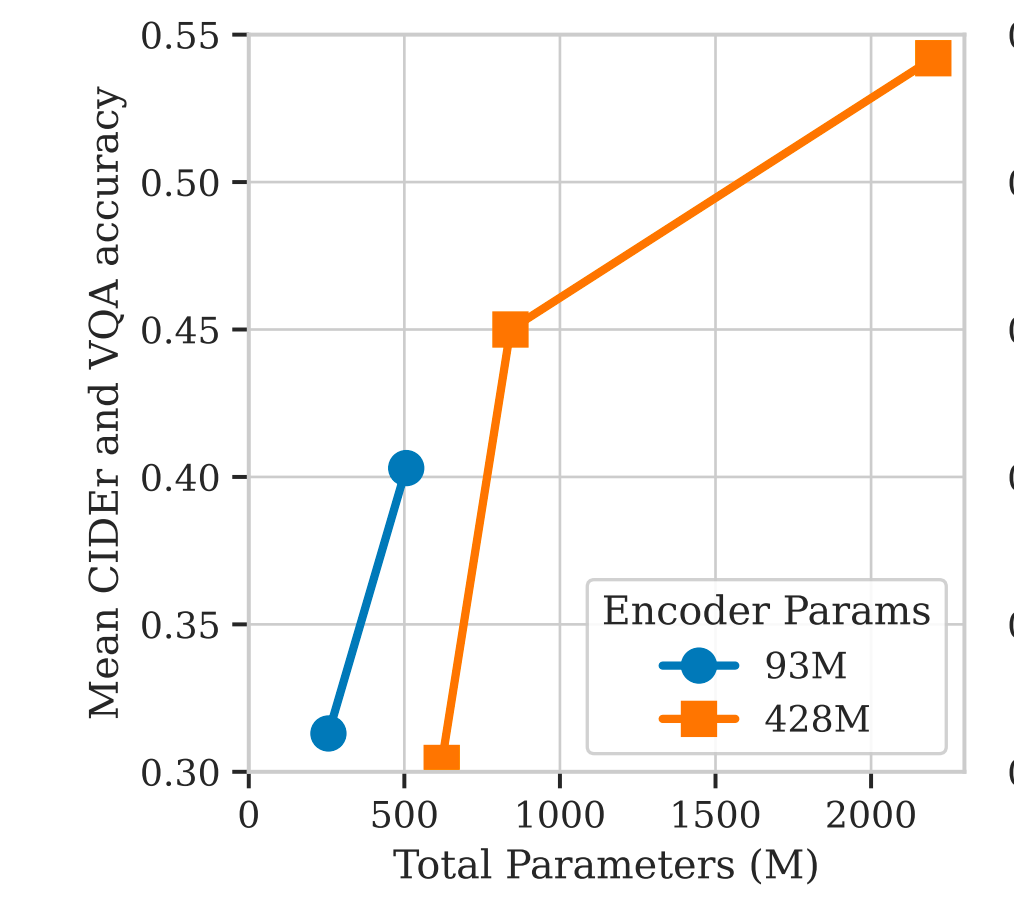
类似的紧凑型 VLM 也常采用“语言模型参数量高于视觉编码器”的配置。
大语言模型
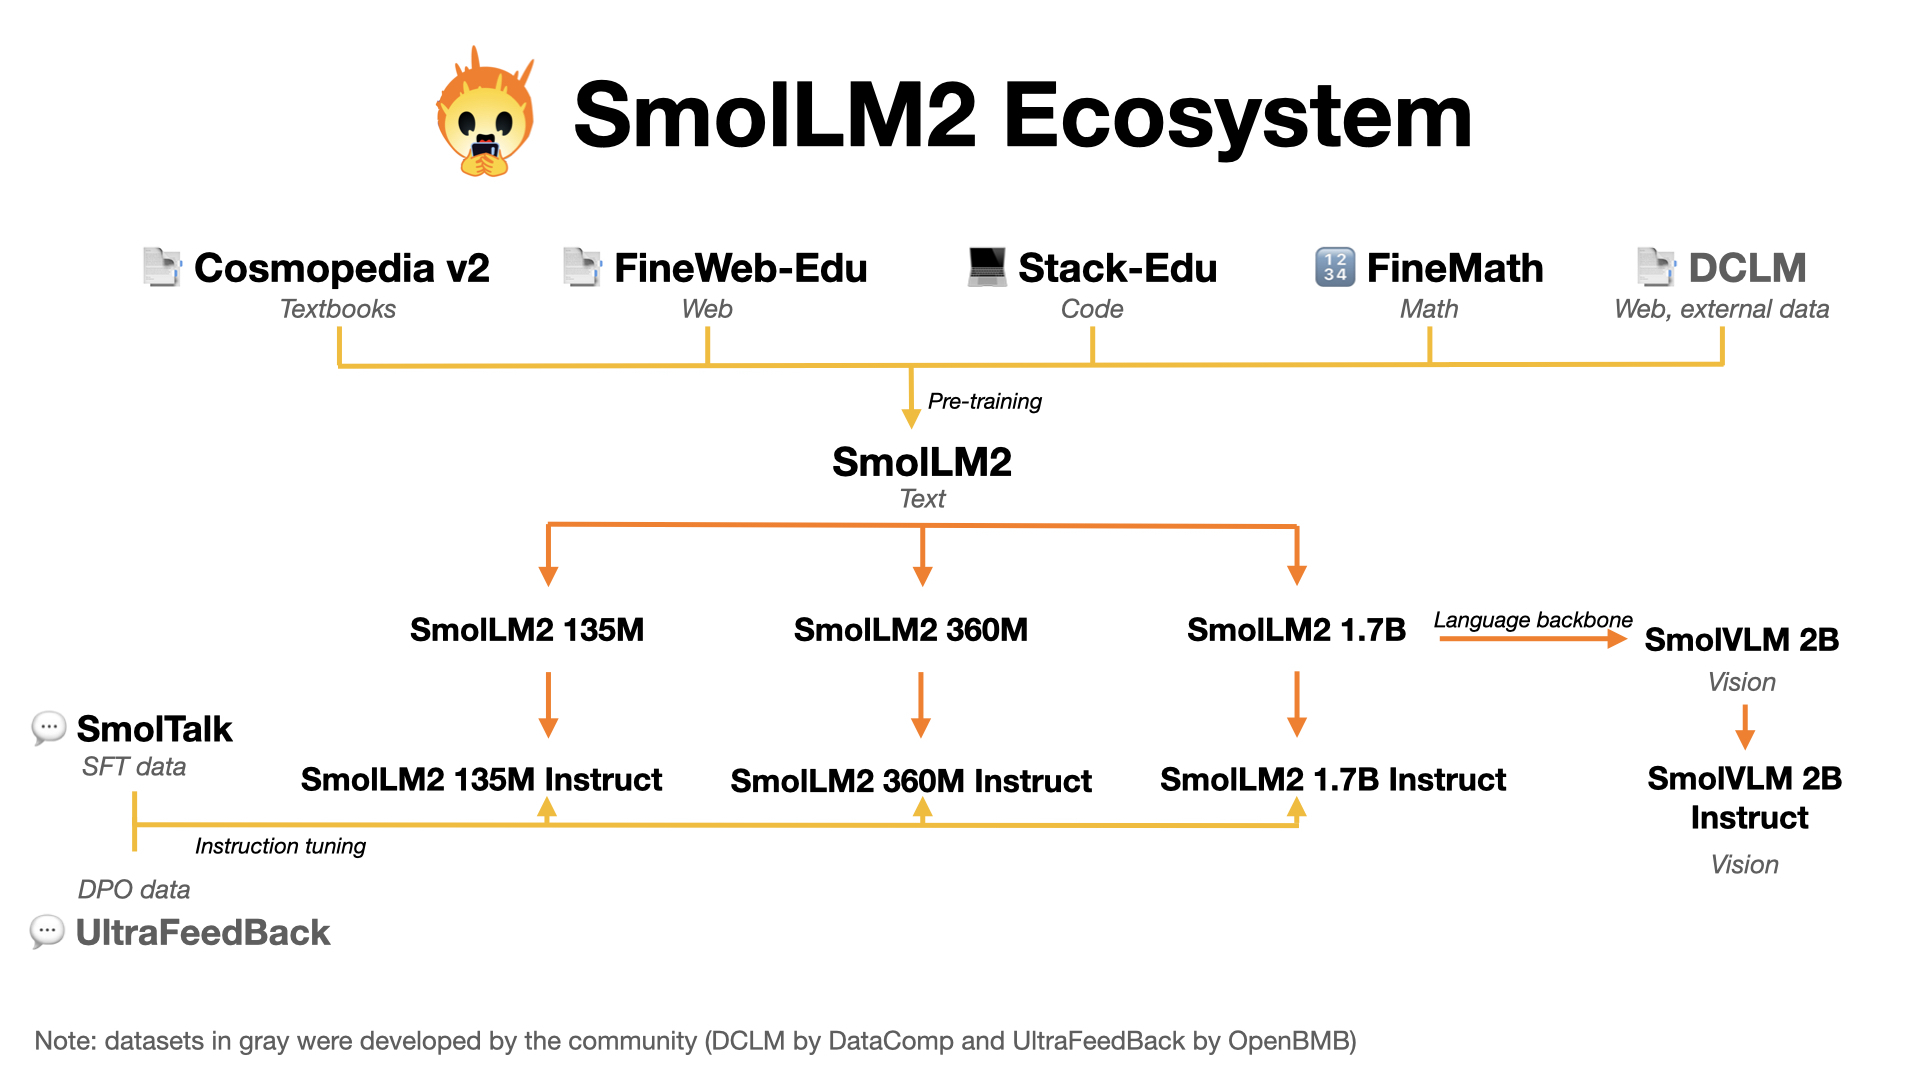
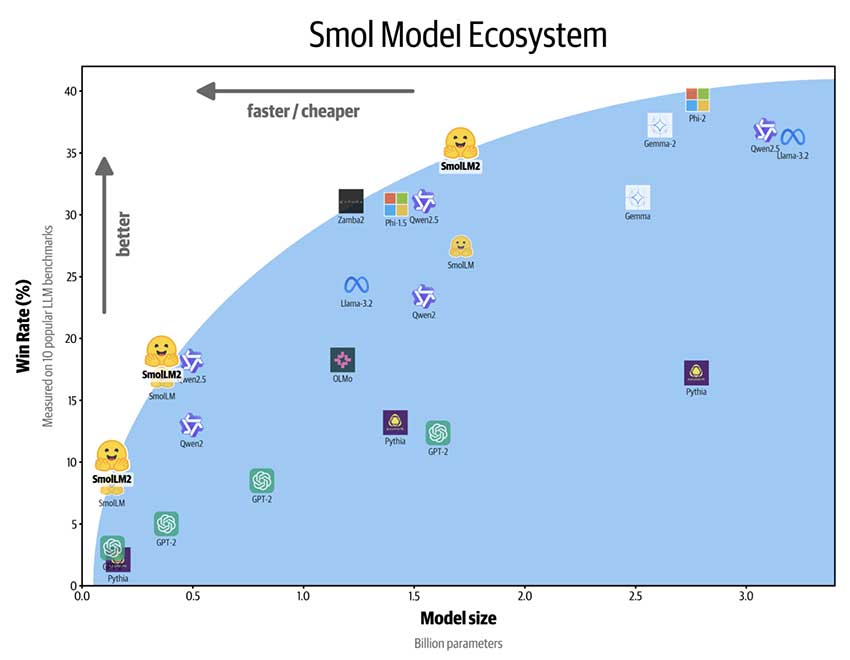
Hugging Face 发布的 SmolLM2 是一组面向端侧应用的小型语言模型,包含 0.1B、0.3B 和 1.7B 三种规模。它延续了 SmolLM1 的轻量化方向,适合对延迟、隐私和硬件资源较为敏感的场景。
其中,SmolLM2-1.7B 使用 FineWeb-Edu、DCLM 和 The Stack 等数据集中的约 11 万亿个 token 进行训练,内容以英语为主,并针对文本重写、摘要和函数调用等任务做了优化。从公开材料看,训练过程有几个值得注意的地方:
长时间训练:模型规模较小,但训练 token 数量远高于以往同等规模模型的常见配置。
多阶段训练:先使用大规模 Web 文本,再逐步加入高质量数学、代码和指令数据,并动态调整数据源的混合比例。
数据评估与选择:分别评估 Web、代码、数学和指令遵循数据,并根据结果决定训练数据的组成。
数据集增强:补充 FineMath、Stack-Edu 和 SmolTalk,分别加强数学推理、代码和指令遵循能力。
在线重平衡:根据模型在关键基准测试上的表现,持续调整数据集比例。
投影层
SmolVLM 的投影层负责把 SigLIP 输出并经过 Pixel Shuffle
处理的视觉特征映射到语言模型的嵌入空间。Pixel Shuffle 将每个视觉 token
的特征维度扩展为原来的
这一层的结构很轻,计算开销也不高。不过它做的主要是维度和特征空间对齐,投影时可能丢失一部分细节,也不会主动建模更复杂的跨模态关系。
像素重排
Pixel Shuffle 最初用于图像超分辨率,通过重新排列空间维度与通道维度,在不丢弃元素的情况下改变特征图形状。SmolVLM 使用相反方向的重排,把部分空间信息压入通道维度,减少送入语言模型的视觉 token 数量。结果是特征向量变宽,token 序列变短。
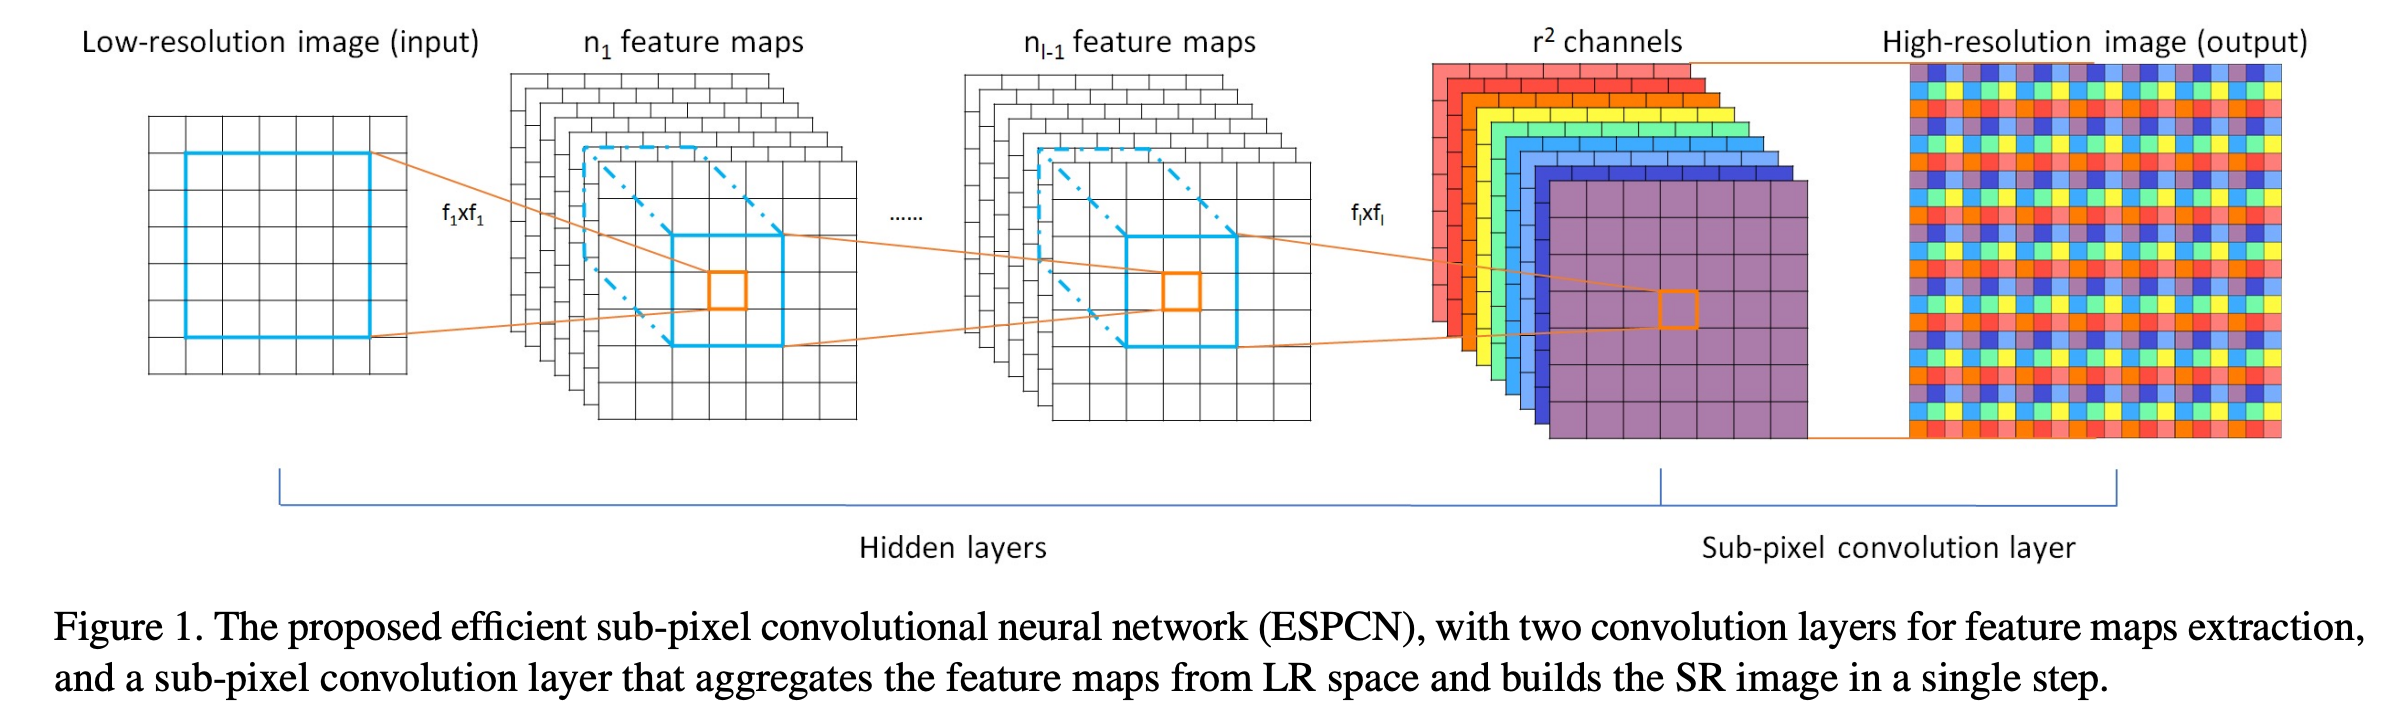
标准 Pixel Shuffle 的形状变化可以写成:
B :批次大小(batch size)。
个子单位( 是缩放因子)。 H:图片高度。
W :图片宽度。
上式对应超分辨率方向。SmolVLM 使用逆向重排,可表示为
以一个典型变换为例:
在 SmolVLM-256M 模型中,一张 512×512 的图像会被划分为 64 个独立图像块,每个图像块被编码为一个视觉 token,最终仅用 64 个 token 完成整张图像的表征。这种设计大幅减少了输入语言模型的视觉 token 数量,既降低了内存占用,也显著加速了推理速度。
SmolVLM-256M 使用 SigLIP base patch-16。对于 512×512 的输入图,patch 大小为 16×16,因此会产生 1024 个视觉 token。接下来再通过 Pixel Shuffle 将其压缩到 64 个。
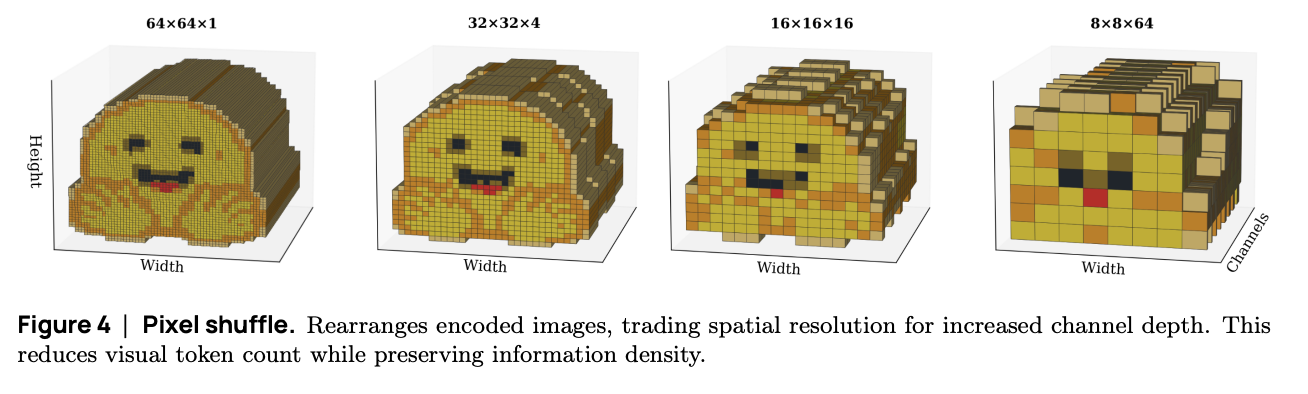
1024 个 patch 对应一个 32x32 的空间网格。将 token 数量从
1024 减少到 64 时,压缩比为:
对 Transformer 而言,注意力计算通常随序列长度呈平方增长。若 token 序列长度为 Len、特征维度为 Dim,则
和 的形状为 ,注意力矩阵的形状为 。 在推理过程中,模型会生成并缓存键 (Key) 和值 (Value) 向量(KV Cache)。KV Cache 的大小直接与输入序列长度和批次大小成正比。
进入语言模型后,视觉 token 仍然会被展平成一维序列。二维空间关系主要由视觉编码器及位置相关信息表达,LLM 接收到的是按序排列的视觉特征。SmolVLM 论文对这一过程有更完整的说明。
推理框架
llama.cpp
是以 C/C++
实现的本地大模型推理框架,目标是在多种硬件环境中以较少依赖完成模型部署,并提供具有竞争力的推理性能。
框架特性:
基于纯 C/C++ 实现,无任何外部依赖;
原生支持苹果芯片(Apple silicon),并通过 ARM NEON、Accelerate 框架及 Metal 框架进行深度优化;
针对 x86 、RISC-V 架构,提供各自的指令集支持;
支持 1.5 位、2 位、3 位、4 位、5 位、6 位及 8 位整数量化,实现更快的推理速度并降低内存占用;
提供定制化 CUDA 核函数,用于在 NVIDIA GPU 上运行大语言模型(LLMs);同时通过 HIP 支持 AMD GPU,通过 MUSA 支持摩尔线程(Moore Threads)GPU;
支持 Vulkan 及 SYCL 后端;
支持 CPU+GPU 混合推理模式,可对超出显存总容量的大型模型实现部分加速运行。
在这次接入中,我们主要用到的是 llama.cpp 的多模态推理链路:语言模型、视觉投影器和图文输入都由同一套接口组织。再加上 iOS、Android 两端都能运行,底层模型逻辑可以共用,客户端只需处理各自的平台接入。
模型文件
GGUF 是 GGML
生态使用的一种模型交换与存储格式,针对快速加载和推理做了优化。它是
GGML、GGMF 和 GGJT
的后续格式,可以在文件中保存模型结构、配置和权重,也允许在保持兼容性的前提下扩展元数据。随着
llama.cpp 的发展,GGUF 已被许多本地推理工具采用。
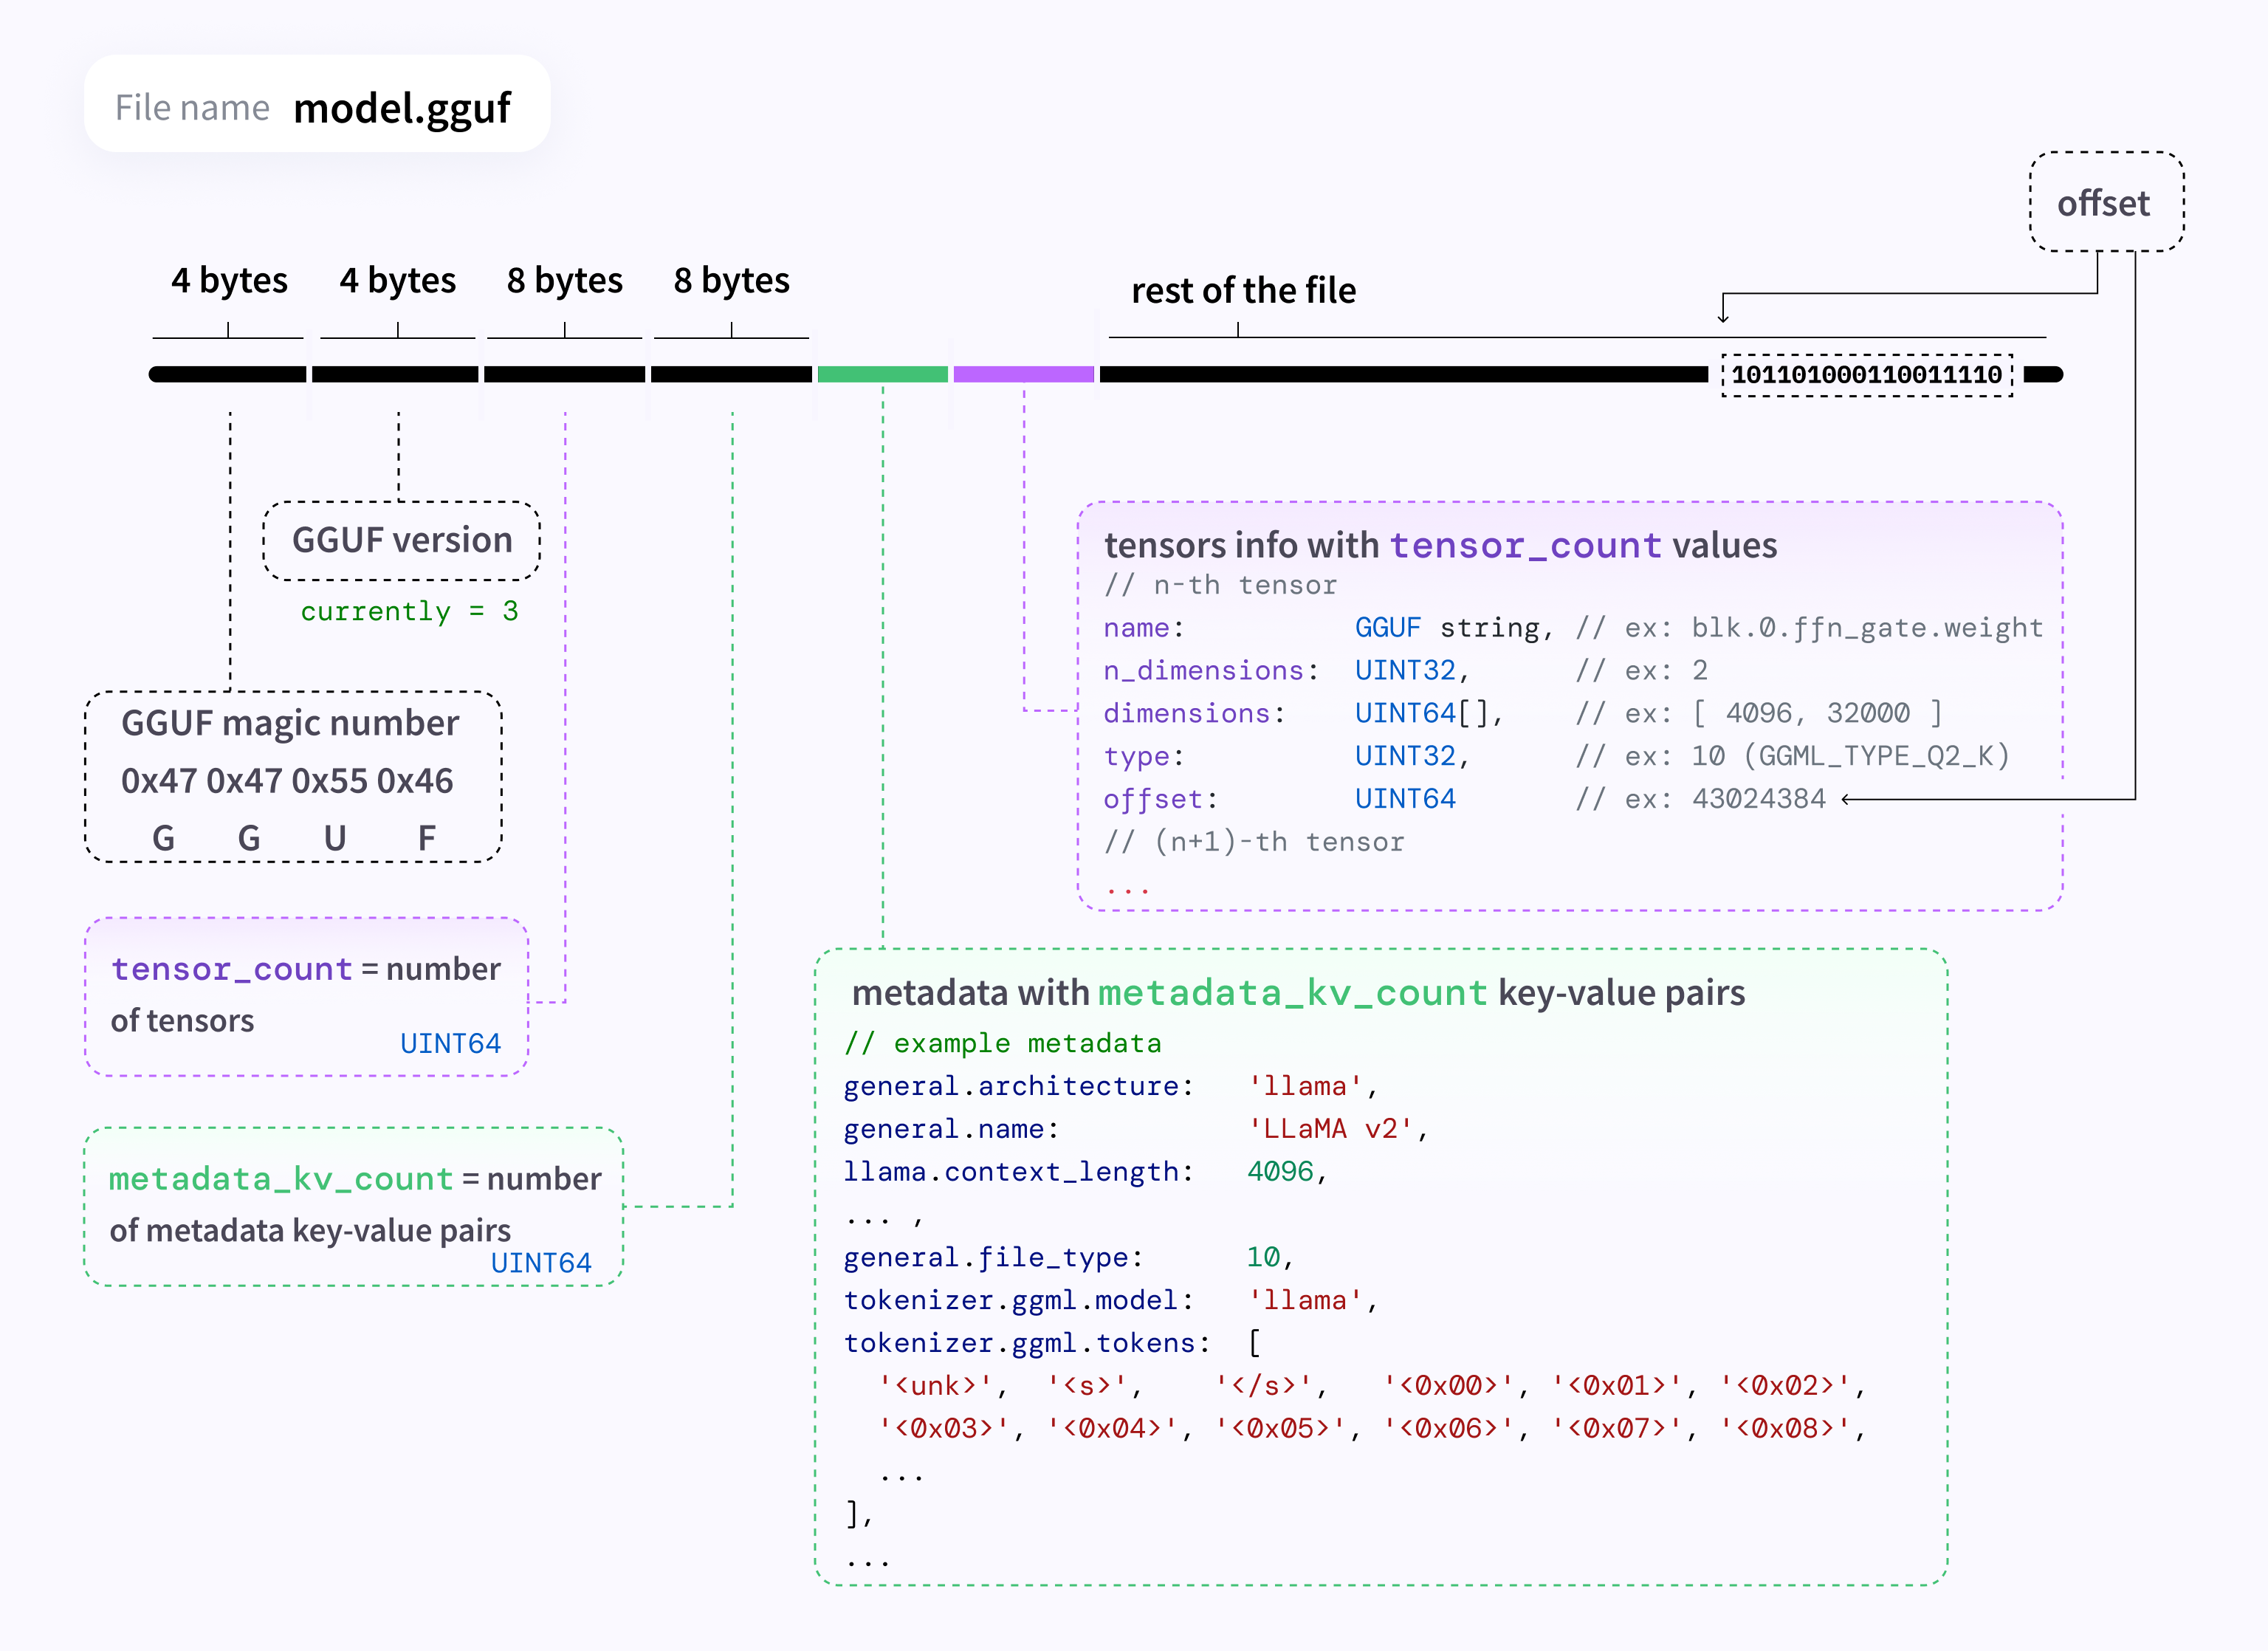
GGUF 文件是一种二进制格式,由三个主要部分组成:文件头、元数据和张量数据。
文件头: 包含魔数
GGUF和格式版本号,供加载器识别文件并处理版本差异。元数据: 以键值形式保存模型架构、名称、embedding 维度、词表和张量信息等配置,使加载器不必依赖额外配置文件。
张量数据: 连续存放权重、偏置和归一化参数。量化模型还会保存低精度数据及反量化所需的信息,并按照
Q4_0、Q5_K、Q8_0、F16、F32等类型进行组织。张量通常按特定字节边界对齐,以便高效地进行内存映射和加载。
与 Safetensors 相比,GGUF 更强调面向推理的自描述能力:除了权重,还可以保存模型架构、量化方式和词表等元数据;Safetensors 虽然也支持文件级元数据,但模型配置和 tokenizer 通常由其他文件提供。对于多模态模型,语言模型与视觉投影器仍可能分别存放在不同的 GGUF 文件中。
自描述:权重、架构和量化信息放在同一个模型组件中,加载器可以直接从文件读取所需参数。
内存映射:张量按规则对齐,可以通过
mmap映射,避免启动时复制整份模型。可扩展:元数据采用键值结构,新增字段时不必重新设计整个文件格式。
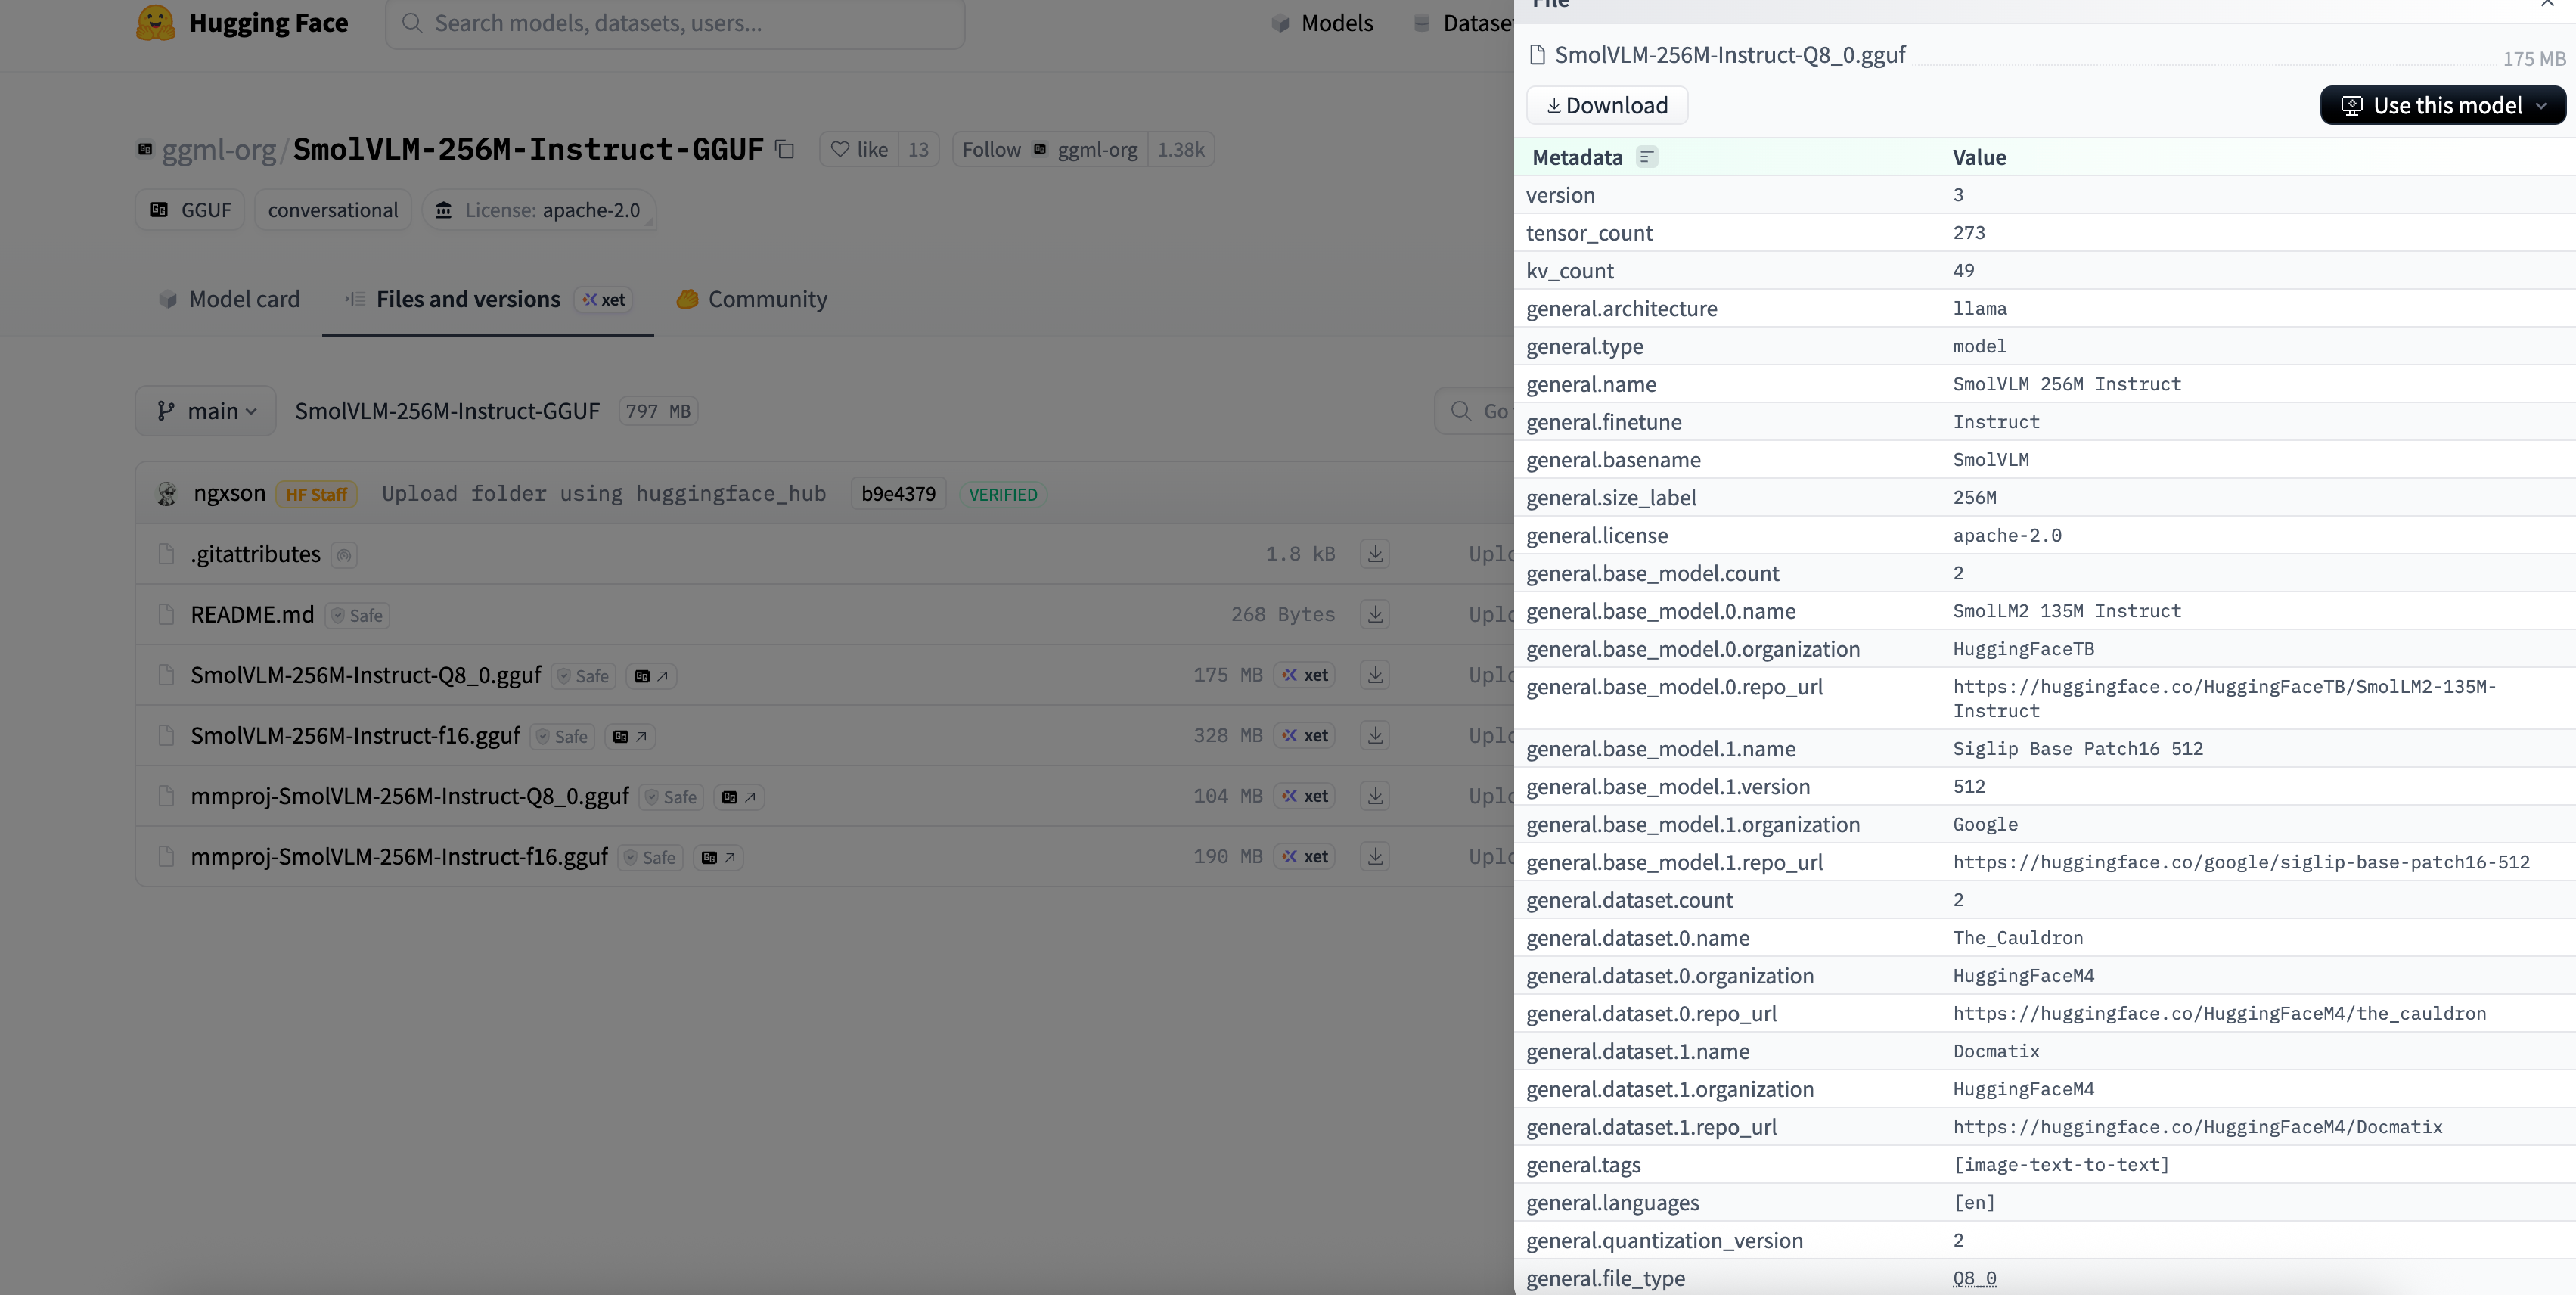
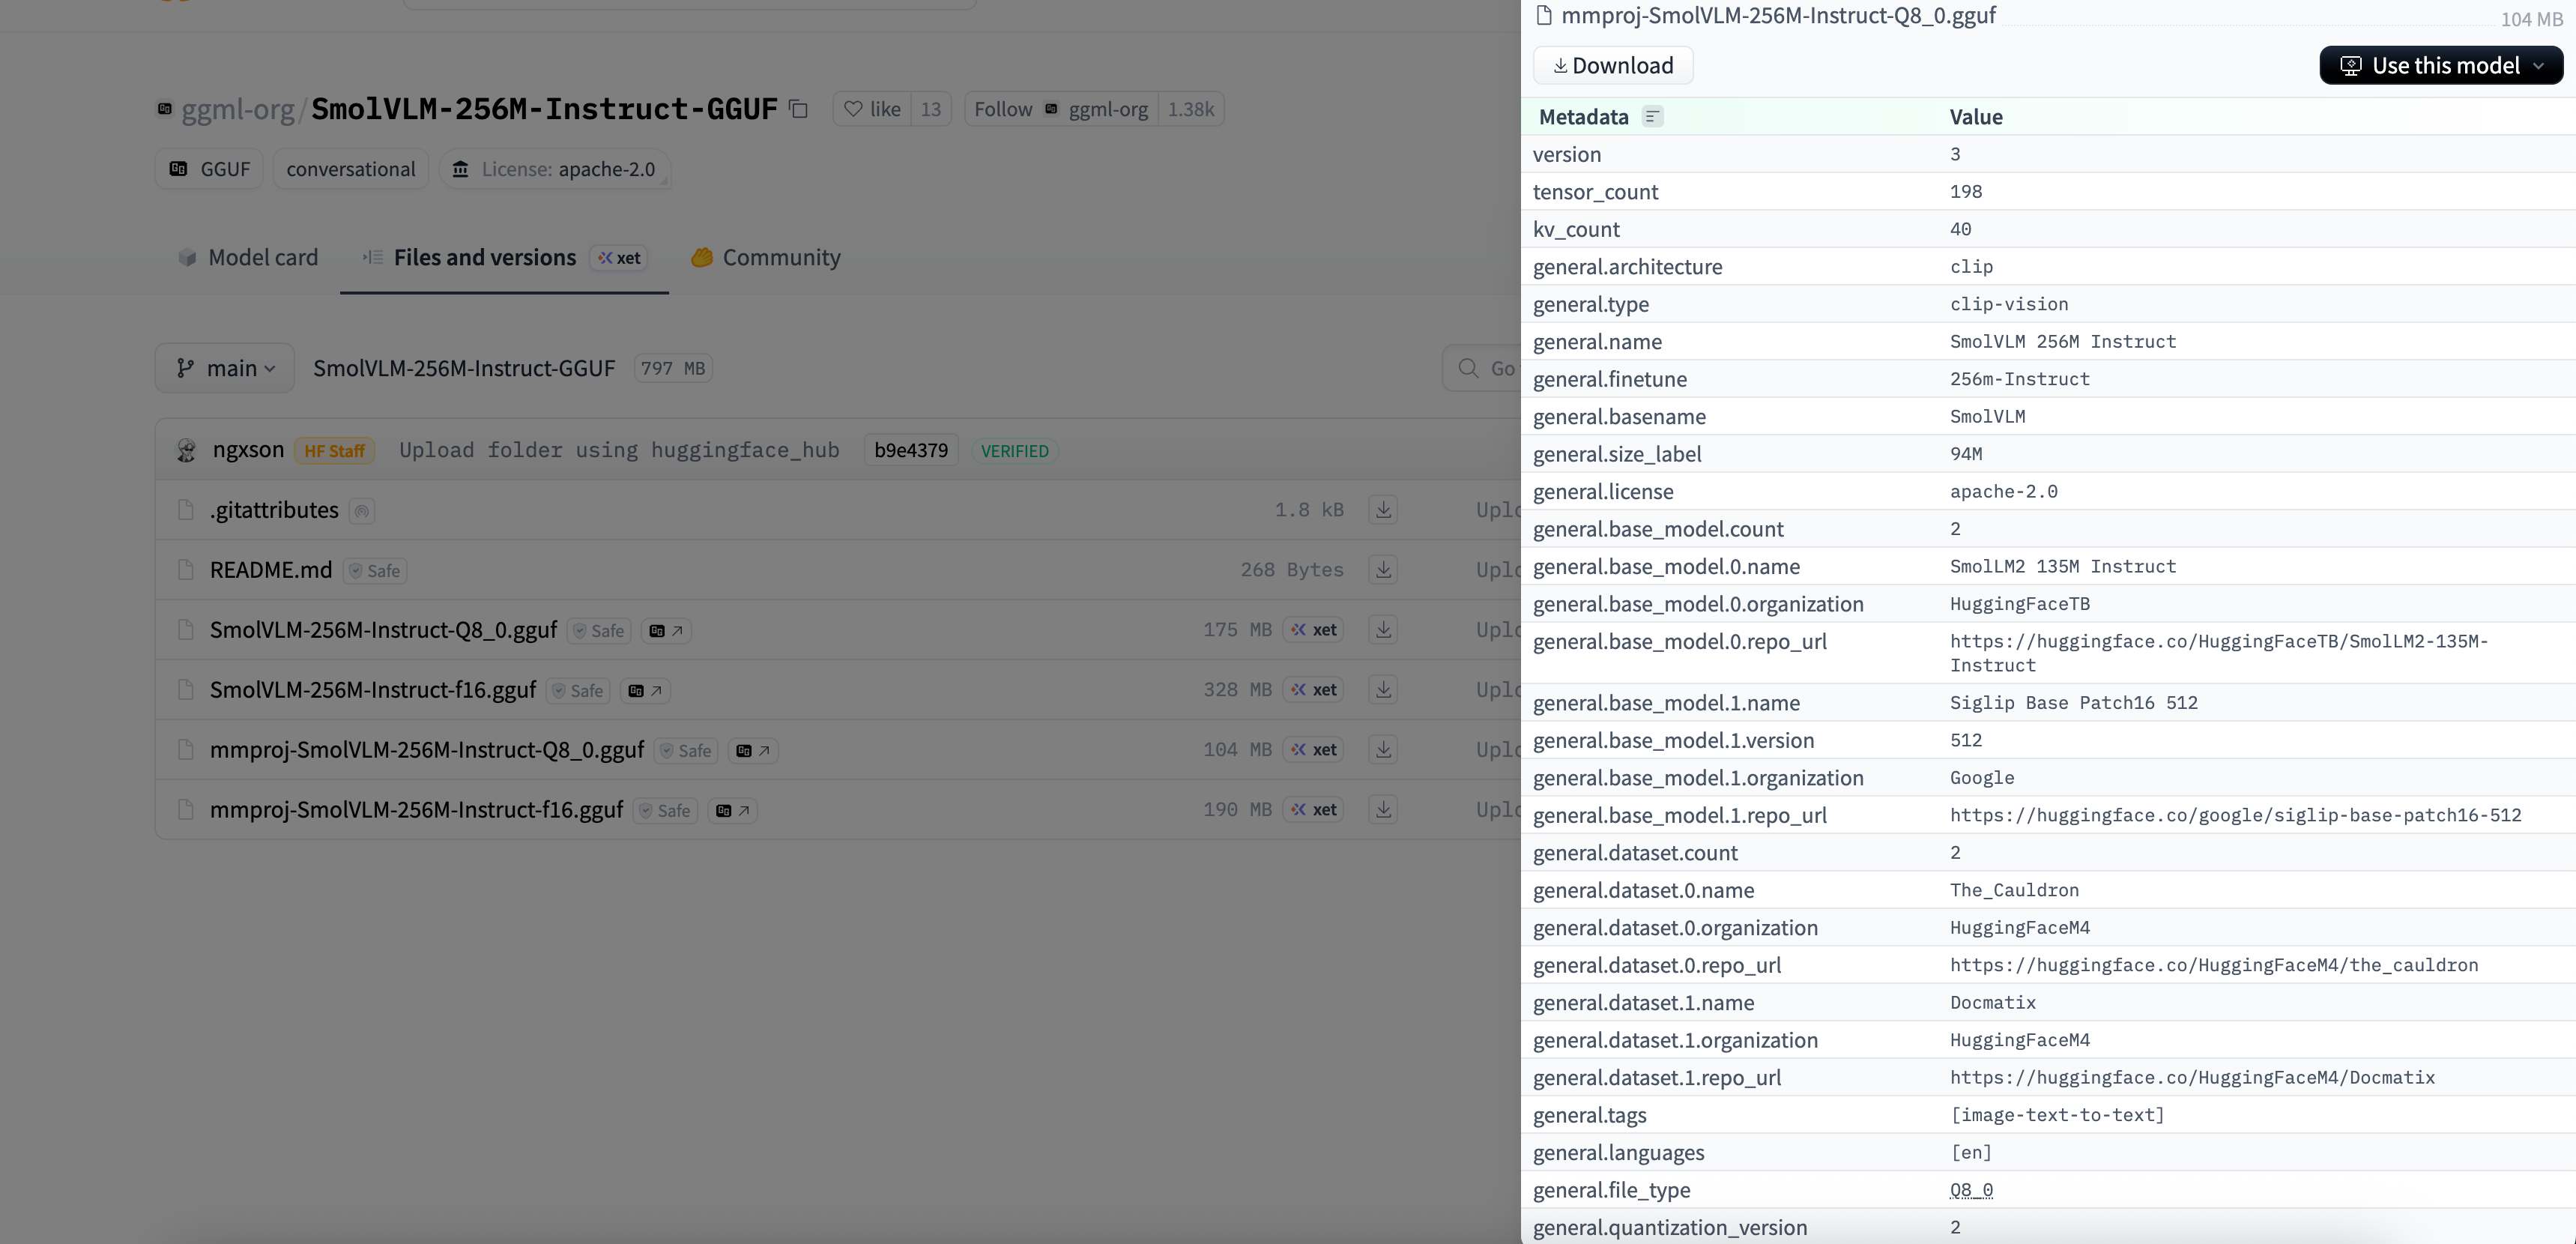
以 SmolVLM-256M-Instruct-GGUF 为例,可以直接在 Hugging Face 查看语言模型与视觉模型的元数据和张量描述。
推理过程
接下来从 mtmd-cli.cpp
的入口往下走,看看图像切分、视觉编码、Pixel Shuffle
和语言模型推理分别落在哪段代码里。
加载模型
llama.cpp 的初始化入口位于 mtmd-cli.cpp 的
main() 方法中。
1 | int main(int argc, char ** argv) { |
common_params_parse() 负责把环境变量与命令行参数归一化到
common_params,并完成模型下载和参数约束校验。后续的模型加载、上下文创建与推理都会直接使用这个统一参数结构。
构建 Context
1 | int main(int argc, char ** argv) { |
构建 mtmd_cli_context
时会加载语言模型与视觉模型,并初始化模型参数、Chat
Template、词表和缓存,最终得到后续推理所需的
llama_context。
Prompt 处理
不同模型使用的 Chat Template 并不相同。SmolVLM 基于 IDEFICS3 架构,Prompt 需要按照官方的 Chat Template 组织。该模板也会写入模型文件,可以在加载模型时直接读取。
1 | <|im_start|> |
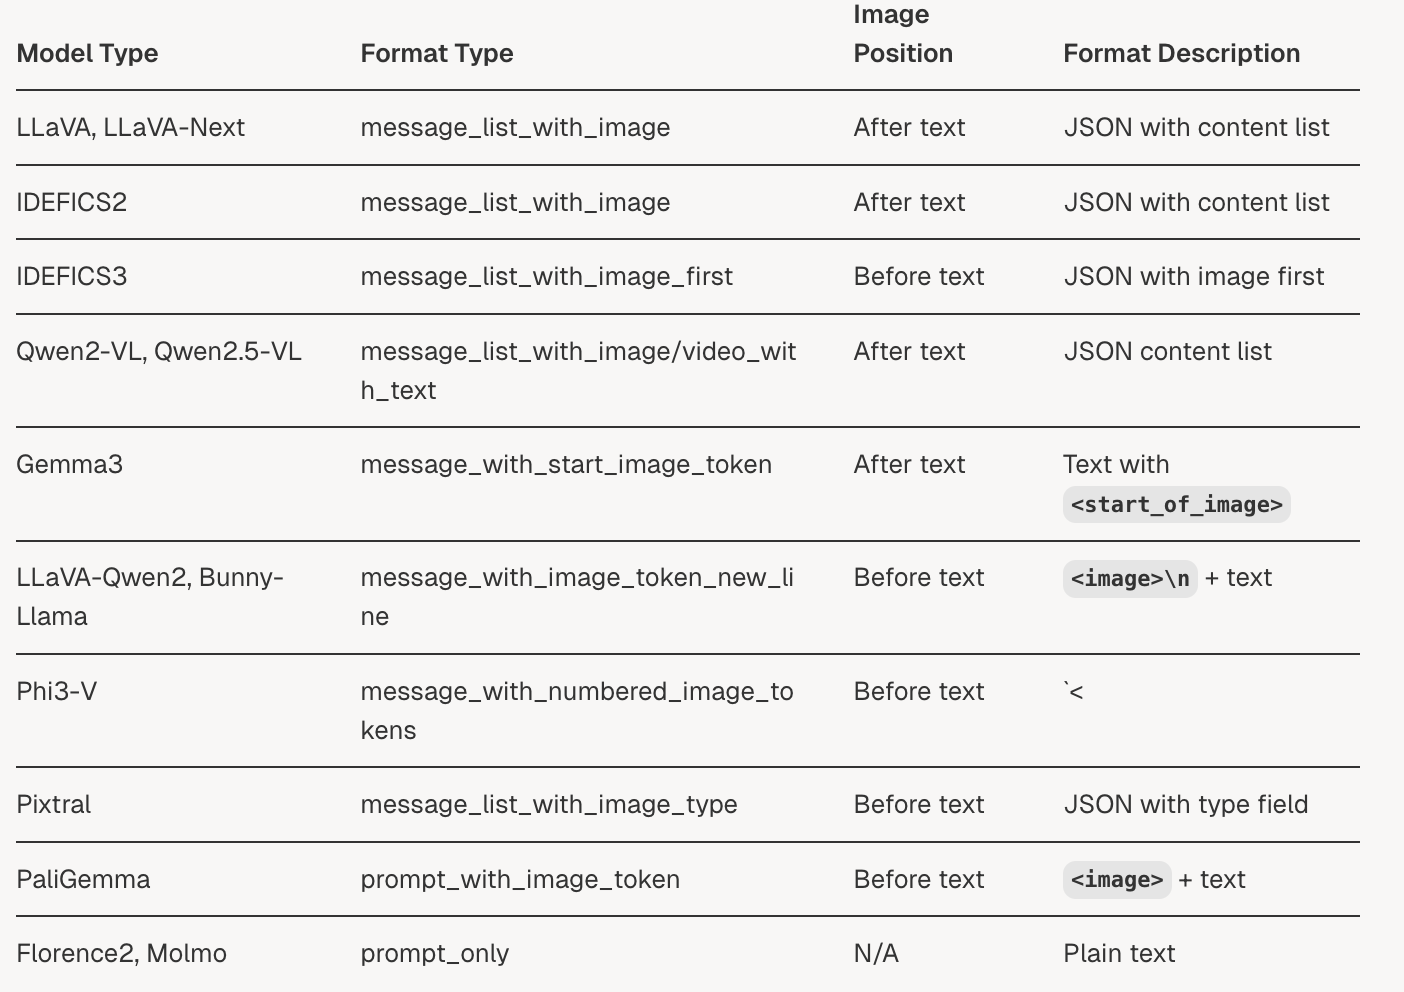
Image Marker、User Prompt 和 System Prompt 必须按照模板规定的顺序拼接。图片与文本位置颠倒可能导致异常输出。
1 | <|im_start|>System: You are a helpful assistant.<end_of_utterance> |
llama.cpp 中的 Image Marker 可以改为官方模板使用的
\<image\>。这个标记不会被转换成普通 token
id,而是被解析成独立的图片 chunk;进入 Transformer
前,它会被替换为图片的 embedding 向量。
1 | //mtmd.cpp |
在这里使用的 llama.cpp 版本中,System Prompt 和 User Prompt
会分别调用一次 eval_message(),而不是一次性完成处理。
1 | //mtmd-cli.cpp |
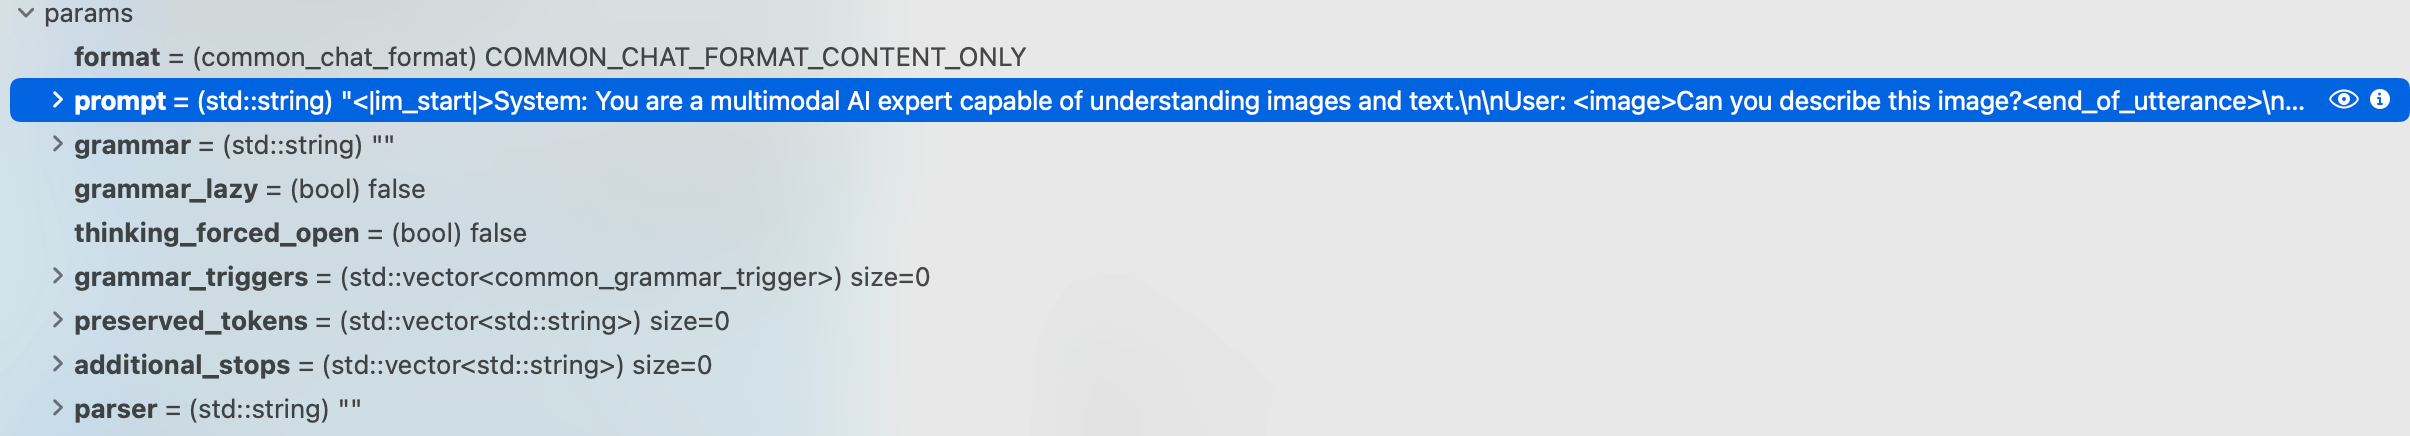
当时的实现没有为 System Prompt 添加结束标记
\<end_of_utterance\>,因此需要补上这段逻辑。
1 | //llama-chat.cpp |
Prefill 过程
在 LLaMA、GPT 等自回归语言模型中,第一次把完整输入序列送入模型,计算隐藏状态、logits 和 KV Cache 的过程通常称为 Prefill。
1 | static int eval_message(mtmd_cli_context & ctx, common_chat_msg & msg) { |
一次 eval_message() 就对应一次 Prefill:先由
mtmd_tokenize() 对 Prompt 进行 token 化并拆分 chunk,再由
mtmd_helper_eval_chunks() 执行前向推理。
Prefill 流程
System Prompt 和 User Prompt 会分别执行一次
eval_message(),也就是分两段完成前向推理。从 llama.cpp
的实现来看,只要 token 的位置连续、KV Cache
按顺序追加,分段处理就不会改变最终序列。第一段产生的
logits_0 不参与后续采样,真正用于生成的是最后一个 chunk 的
logits。代价是中间段仍然会计算一份最终不会使用的 logits。
mtmd_helper_eval_chunks() 负责把图像与文本 chunk
按顺序送入模型,并分别处理图像编码和文本 decode。
如图所示,System Prompt 会形成文本
chunk0,先进入语言模型完成一次前向推理并生成
logits_0。User Prompt 则被拆成文本
chunk1、图片 chunk2 和文本
chunk3,再依次送入模型。只有最后一个文本 chunk 产生的
logits_last 会用于自回归采样。
llama.cpp 中的图像预处理
SmolVLM 论文提到,图片进入 SigLIP
编码器前会先被切成多个局部图,再分别编码为图片 embedding。llama.cpp
的对应入口是 clip_image_preprocess()。
1 | clip.h |
这段逻辑会先确定全局预览图的尺寸
overview_size,再计算原图按模型限制缩放后的
refined_size,最后根据单张切片的目标尺寸得到网格数量
grid_size。
SmolVLM 的 preprocessor_config.json
中,size.longest_edge 为
2048,表示缩放后图片的最长边限制;max_image_size.longest_edge
为 512,对应视觉编码器处理单张图片的目标尺寸。例如,1024×512
的原图会被缩放为 2048×1024,再切成 8 张 512×512
的局部图,加上一张全局预览图,共有 9 张图片参与编码。这里使用的
llama.cpp 与视觉 GGUF 没有单独保存
longest_edge,实际运行时只处理了全局预览图;若要启用完整切片,需要在读取视觉模型超参数时补充相应的
longest_edge。
Llama Decode
llama_context::decode() 是推理过程的核心入口:它接收一批
token,执行 Transformer 前向计算,更新 KV Cache,并得到 logits。
其主要步骤有:
- 构建计算图
- 运行 Transformer
- 写入 KV Cache
- 生成 logits
1 | int llama_context::decode(const llama_batch & batch_inp) { |
process_ubatch() 负责构建计算图、设置输入数据并调度
Metal 后端执行,同时保存本轮生成的 KV Cache。计算完成后,logits
会异步拷贝到 CPU 侧的 llama_context::logits.data
缓存,供后续自回归采样使用。后端张量和计算图调度涉及更多细节,本文暂不展开。
自回归解码
自回归解码(Autoregressive Decoding)是主流大语言模型在生成阶段普遍采用的解码方式。
模型每次只生成一个 token,新 token 依赖 Prompt、KV Cache 和此前已经生成的全部 token。
Prefill 得到首个采样位置的 logits 后,模型从中采样 token,将它追加到 batch,再执行下一轮 decode。这个过程持续循环,直到命中停止条件。
1 | static int generate_response(mtmd_cli_context & ctx, int n_predict) { |
总结
回头看这条链路,图像和文本其实走了两条不同的准备路径。图像经过切分和视觉编码,再由 Pixel Shuffle 缩短视觉 token 序列,最后通过投影层进入语言模型的嵌入空间。文本则按照 Chat Template 被拆成 token 和 chunk。两者按 Prompt 中的位置合并,在 Prefill 阶段写入 KV Cache,随后进入逐 token 的自回归 Decode。
如果输出结果不符合预期,可以先核对 Chat Template、Image Marker、图像预处理参数,以及各段 Prefill 是否连续更新位置和 KV Cache。这几处都会直接影响输出内容、图像理解效果和内存占用。

